all-papers
收藏资源简介:
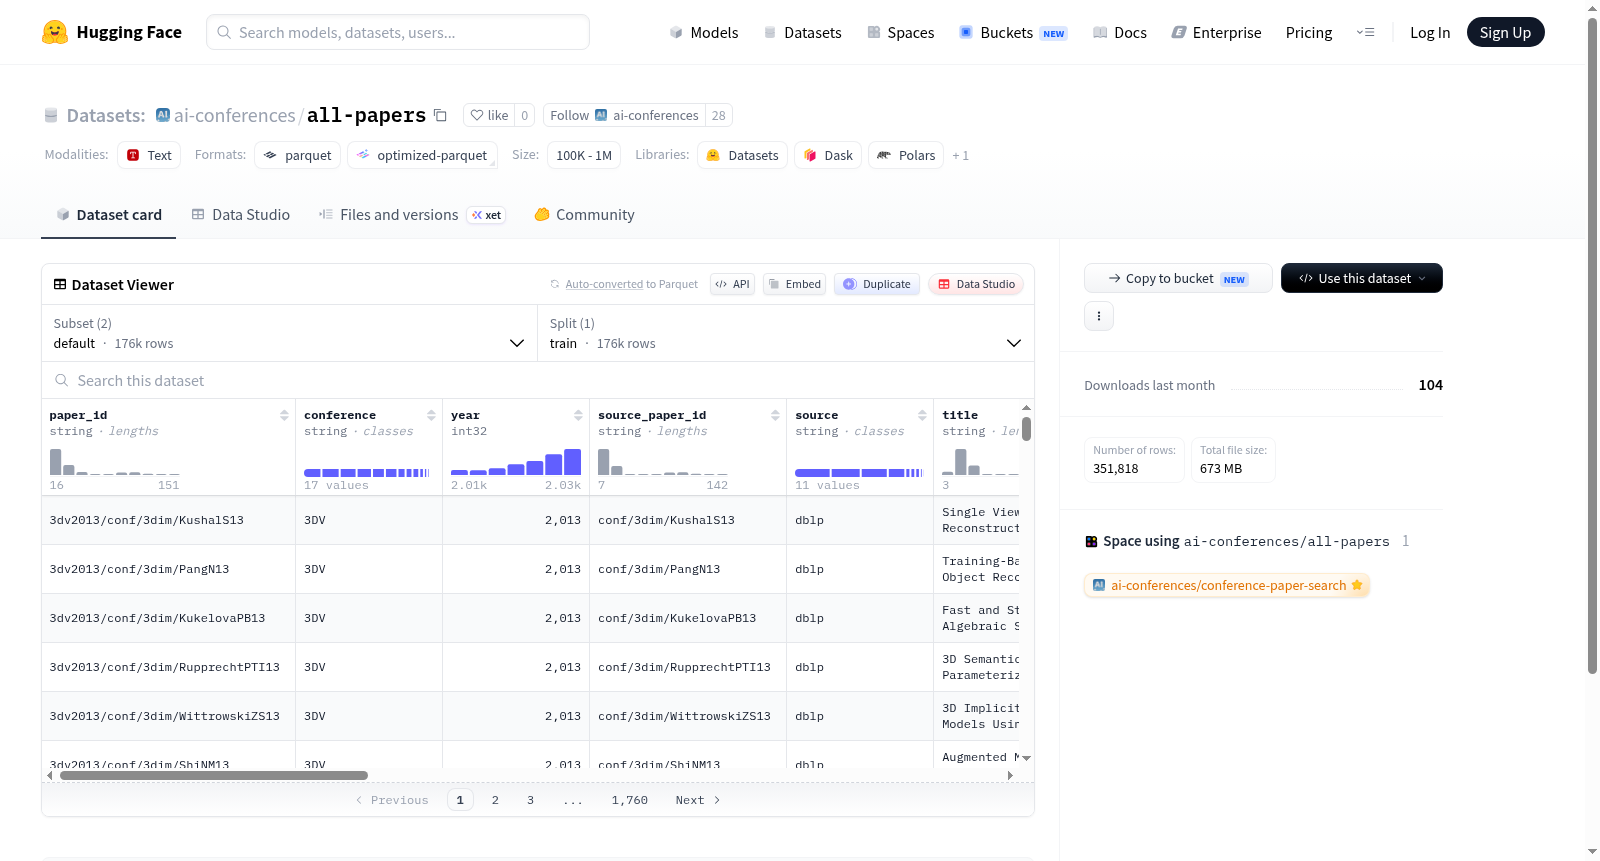
该数据集是一个大规模的学术论文元数据集合,包含约175,909篇论文的详细信息。数据涵盖多个字段:论文唯一标识(paper_id)、发表会议(conference)、年份(year)、来源论文ID(source_paper_id)与来源(source)、标题(title)、作者列表(authors)、摘要(abstract)、论文网页链接(paper_url)与PDF链接(pdf_url)、数字对象标识符(doi)、arXiv标识符(arxiv_id)及其来源(arxiv_id_source)、论文类型(type)、主要研究领域(primary_area)、关键词列表(keywords)、简短总结(tldr)以及获奖信息(award)。数据集还提供了一个独立配置(embeddings-bge-base-en-v1.5),包含论文ID及其对应的BGE-base-en-v1.5模型生成的嵌入向量(embedding)。数据适用于学术文献挖掘、信息检索、文本分类、摘要生成、推荐系统等自然语言处理任务。
This dataset is a large-scale collection of academic paper metadata, containing detailed information on approximately 175,909 papers. The data covers multiple fields: paper unique identifier (paper_id), conference of publication (conference), year (year), source paper ID (source_paper_id) and source (source), title (title), author list (authors), abstract (abstract), paper webpage link (paper_url) and PDF link (pdf_url), digital object identifier (doi), arXiv identifier (arxiv_id) and its source (arxiv_id_source), paper type (type), primary research area (primary_area), keyword list (keywords), short summary (tldr), and award information (award). The dataset also provides an independent configuration (embeddings-bge-base-en-v1.5) containing paper IDs and their corresponding embedding vectors generated by the BGE-base-en-v1.5 model. The data is suitable for natural language processing tasks such as academic literature mining, information retrieval, text classification, summarization generation, and recommendation systems.
数据集概述
- 数据集名称:all-papers
- 来源:ai-conferences(Hugging Face)
- 覆盖范围:包含来自多个学术会议/领域的论文数据
数据集配置
该数据集提供两个配置:
1. default(默认配置)
- 数据内容:每个样本包含论文的元数据,共18个字段
- 字段列表:
paper_id:论文唯一标识(字符串)conference:所属会议(字符串)year:发表年份(整数)source_paper_id:来源论文ID(字符串)source:来源(字符串)title:论文标题(字符串)authors:作者列表(字符串列表)abstract:摘要(长字符串)paper_url:论文链接(字符串)pdf_url:PDF链接(字符串)doi:DOI标识(字符串)arxiv_id:arXiv ID(字符串)arxiv_id_source:arXiv来源(字符串)type:类型(字符串)primary_area:主要领域(字符串)keywords:关键词列表(字符串列表)tldr:简短摘要(长字符串)award:获奖信息(字符串)
- 数据规模:训练集包含175,909个样本,总大小约269.7 MB
2. embeddings-bge-base-en-v1.5(嵌入预计算配置)
- 数据内容:每个样本包含论文ID及其对应的嵌入向量
- 字段列表:
paper_id:论文唯一标识(字符串)embedding:嵌入向量(浮点数列表)
- 数据规模:训练集包含175,909个样本,总大小约548.8 MB
- 嵌入模型:基于 bge-base-en-v1.5 模型预计算
数据存储与访问
- 默认配置数据文件路径:
data/train-* - 嵌入配置数据文件路径:
embeddings-bge-base-en-v1.5/train-* - 下载总大小:默认配置约127.9 MB,嵌入配置约544.8 MB