
ontocord/MixtureVitae-v1-upsampled
收藏官方服务:
资源简介:
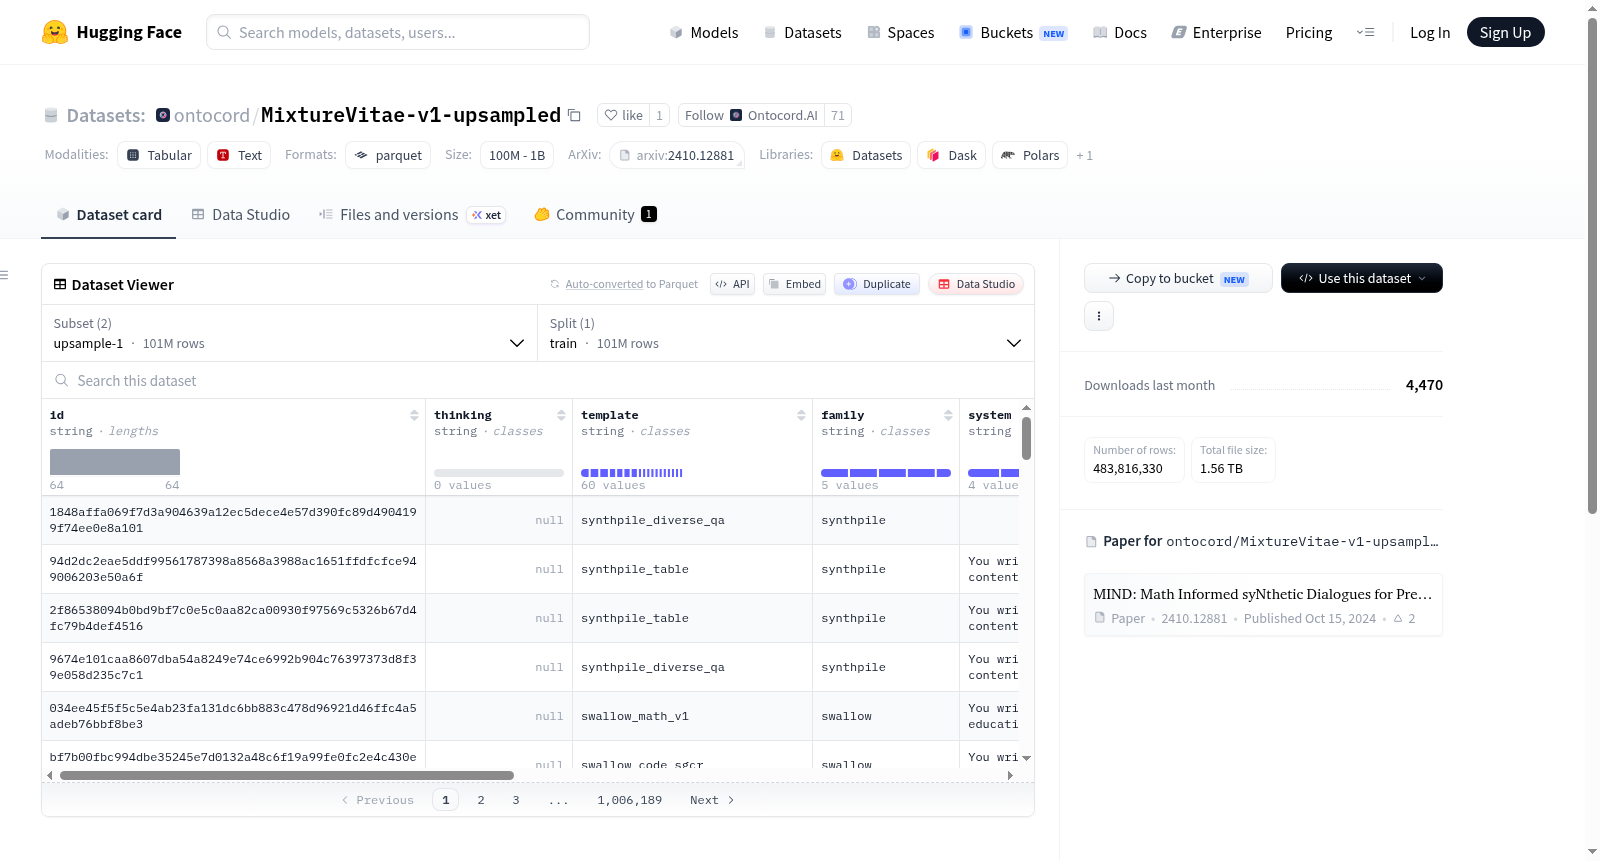
MixtureVitae-v1 upsampled是一个基于MV1-decontaminated生成的合成数据集,包含约1250亿token。数据由合成对话和学习策略数据组成,使用Qwen3-8B模型和MIND风格(参考arXiv:2410.12881)从MixtureVitae-v1生成。数据集提供两个配置:upsample-1(完整生成过程)和upsample-2(第二次生成过程)。
MixtureVitae-v1 upsampled is a synthetic dataset generated based on MV1-decontaminated, containing approximately 125B tokens. It consists of synthetic dialogues and study-strategy data generated from MixtureVitae-v1 using Qwen3-8B and MIND-style (arXiv:2410.12881). The dataset includes two configs: upsample-1 (full generation pass) and upsample-2 (second generation pass).
提供机构:
ontocord搜集汇总
数据集介绍
构建方式
MixtureVitae-v1-upsampled数据集是基于MixtureVitae-v1去污染版本(MV1-decontaminated)所生成的合成数据集合,其构建涉及多个策略的融合。研究者利用Qwen3-8B模型从原始语料中生成对话式与学习策略型数据,并结合MIND风格(参见arXiv:2410.12881)、Swallow及Finephrase等先进数据处理管线。特别地,数据集采用了“Synthpile”技术,即Finephrase策略的一种应用,专注于表格等结构化信息的合成。整个生成流程分为两个配置:upsample-1对MixtureVitae-v1的所有分片进行一次完整生成,而upsample-2则进行第二次生成,以增加数据的多样性和覆盖度。最终,该数据集共计包含约1250亿词元(tokens),为大规模语言模型的预训练与微调提供了丰富的合成样本。
使用方法
使用MixtureVitae-v1-upsampled数据集非常简单,借助HuggingFace的datasets库即可快速加载。用户通过`load_dataset`函数调用指定配置(如`'upsample-2'`)即可获取默认的`'train'`分割数据,所有文件以高效的Parquet格式存储,便于内存优化和分布式处理。该数据集可直接用于大规模语言模型的预训练或领域自适应微调,尤其适合需要多样化对话、结构化表格以及混合风格文本的场景。开发者也可以根据具体任务自定义数据加载流程,例如,通过`data_files`参数选择特定的`upsample-1`或`upsample-2`子集,将其融入现有训练管线中,无需额外数据清洗步骤。
背景与挑战
背景概述
MixtureVitae-v1-upsampled数据集由Ontocord团队于近期创建,其核心研究问题在于如何通过合成数据生成策略扩充高质量的多领域训练语料。该数据集基于MixtureVitae-v1去污染版本,利用Qwen3-8B模型、MIND风格框架及Finephrase技术(如表格合成)生成了约1250亿词元的对话与研究策略数据。作为合成数据领域的创新性尝试,它旨在缓解真实标注数据稀缺、版权争议及隐私泄露等问题,为语言模型预训练、指令微调及多任务学习提供更丰沛、可控的资源,对推动开放数据生态与模型性能提升具有潜在影响力。
当前挑战
该数据集面临的核心挑战包括:1)所解决的领域问题——合成数据虽能规避真实数据采集的高昂成本与法律风险,但其质量、多样性及与现实世界的对齐程度仍高度依赖于生成模型的性能与策略设计,易引入系统性偏差或虚假模式,影响下游模型的泛化性与鲁棒性;2)构建过程中的挑战——采用两轮生成策略(upsample-1与upsample-2)虽能丰富数据覆盖,但如何避免冗余、保障不同轮次间数据的独立性及互补性,以及确保表格、对话等异构格式的语义一致性,均需精细的过滤与质量监控机制。
常用场景
经典使用场景
MixtureVitae-v1-upsampled数据集在自然语言处理与多模态预训练研究中扮演着关键角色,其最经典的使用场景是作为大规模合成语料库,为语言模型提供高质量的预训练数据。该数据集基于MixtureVitae-v1去污染版本,采用多种合成策略如MIND、Swallow和Finephrase,生成了约1250亿个令牌的对话与学习策略数据。研究者常将其作为基础训练集,用于提升模型在对话生成、知识理解与复杂推理任务上的表现,尤其适合需要大规模、多样性文本数据的场景。
解决学术问题
该数据集有效解决了学术研究中高质量训练数据稀缺与数据污染问题。通过去污染处理和多种合成策略,它提供了干净、多样且规模宏大的文本资源,满足了大规模语言模型对海量、高信噪比数据的需求。其引入的对话式与学习策略数据形式,助力研究者在模型对齐、指令遵循和长期依赖建模等前沿方向上取得突破,推动了合成数据在预训练阶段的理论与实践发展,显著提升了模型的泛化能力与鲁棒性。
实际应用
在实际应用中,MixtureVitae-v1-upsampled被广泛用于工业级语言模型的训练与优化。其合成文本可用于改进智能客服、教育辅导系统和内容创作助手等产品的对话能力。例如,基于该数据训练出的模型能更好地理解用户意图、生成连贯回复并适应多轮交互。此外,其表格数据增强等策略也适用于金融、医疗等领域的文档理解与知识检索任务,为垂直行业提供了高效的数据增强手段。
数据集最近研究
最新研究方向
基于MixtureVitae-v1-decontaminated语料库,利用Qwen3-8B等先进模型生成的约1250亿tokens合成数据,结合MIND风格、Swallow与Finephrase等策略,探索合成对话与研究策略数据的规模化生成与质量提升。该数据集专为多轮次上采样设计,通过两次生成传递实现数据增强,其Synthpile策略(如表格生成)为复杂结构化数据的合成开辟了新路径,显著推动了合成数据在大规模语言模型预训练与微调中的应用边界,并强化了数据多样性与可控性研究。
以上内容由遇见数据集搜集并总结生成


