
遇见数据集

AIM-SCU/MAVEN_Multicultura_Text-to-Video_Generation

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

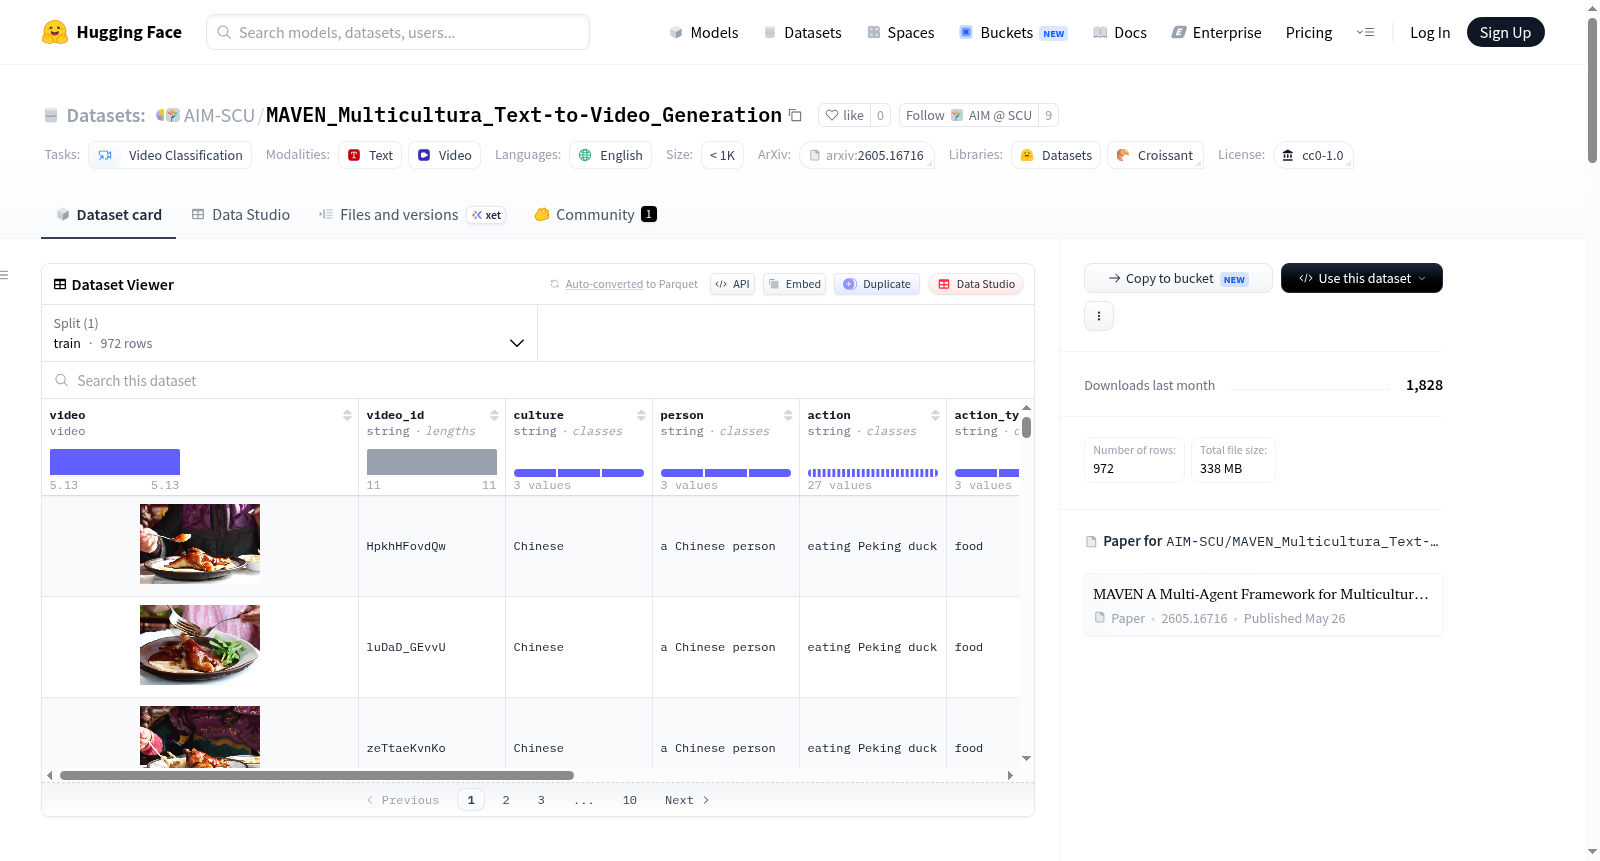
这是一个全面的AI生成视频数据集,展示不同文化、动作类型和地点的多元文化内容。数据集包含使用多种管道方法生成的视频,包括原始和精炼提示。总共有972个条目(243个独特视频 × 4种管道),涵盖三种文化(中国、美国、罗马尼亚)、三种动作类型(食物、音乐、舞蹈)以及四种生成管道(基线单代理、单代理、多代理顺序、多代理并行)。数据集支持文化感知视频生成和表示的研究,每个视频为5秒MP4格式,并包含详细元数据。

A comprehensive dataset of AI-generated videos showcasing multicultural content across different cultures, action types, and locations. The dataset includes videos generated using multiple pipeline approaches with both original and refined prompts. Total entries: 972 (243 unique videos × 4 pipelines). Cultures: Chinese, American, Romanian. Action types: food, music, dance. Pipelines: base, sa (single-agent), mas (multi-agent sequential), map (multi-agent parallel). The dataset supports research into culturally-aware video generation and representation, with each video being 5 seconds in MP4 format and containing detailed metadata.
提供机构:
AIM-SCU
搜集汇总
数据集介绍
AIM-SCU/MAVEN_Multicultura_Text-to-Video_Generation 数据集图片
构建方式
MAVEN_Multicultura_Text-to-Video_Generation数据集源自一项开创性工作,旨在通过多智能体框架推动跨文化文本到视频生成的前沿探索。该数据集通过设计四种不同的生成管线构建而成,包括基础单智能体基线(base)、单智能体管线(sa)、多智能体序列管线(mas)以及多智能体并行管线(map),每种管线均针对同一组提示词生成视频,从而确保评估的公平性与系统性。原始提示词经精细化增强后,融入了更为丰富的文化细节,最终形成972条视频条目,每条记录均包含视频标识、文化类型、人物描述、动作类别、动作类型、场景位置、是否为跨文化内容、原始与增强提示词、视频文件路径及生成管线等结构化字段。数据来源覆盖中国、美国和罗马尼亚三种文化,动作类型涵盖食物、音乐与舞蹈三大类,且在单文化与跨文化两个维度上均有充分采样,为多文化视频生成研究提供了坚实的数据基础。
使用方法
数据集可通过Hugging Face Datasets库便捷加载,仅需一行代码即可获取完整数据。用户能够基于丰富的元数据进行灵活筛选:通过filter方法可按动作类型(如仅保留食物相关视频)、文化类别(如筛选中国文化样本)或跨文化属性进行定向抽取;亦可针对特定生成管线(如多智能体并行管线)独立分析不同架构的表现。每条记录提供了原始提示词与增强提示词,研究者可对比文化细节注入前后的生成效果差异。数据集同时支持视频文件的实际播放与处理,适用于视频生成模型的训练、评估,以及跨文化内容质量分析等多种下游任务。此外,公开的代码仓库提供了完整的生成与评估管线,便于复现实验或扩展至新的文化与动作类型。
背景与挑战
背景概述
MAVEN_Multicultura_Text-to-Video_Generation数据集由Shuowei Li、Yuming Zhao、Parth Bhalerao和Oana Ignat于2025年创建,旨在解决文本到视频生成领域中文化表征缺失的突出问题。该数据集包含972条由多智能体框架生成的视频条目,覆盖中国、美国和罗马尼亚三种文化,涉及食物、音乐和舞蹈三类动作类型,并设计了基线、单智能体、多智能体顺序和多智能体并行四种生成流程。作为首个系统融合跨文化元素的视频生成基准,MAVEN为评估和推动文化感知视频生成模型提供了关键资源,对促进人工智能生成内容的多样性和文化包容性具有深远影响。
当前挑战
该数据集面临的挑战主要体现在两方面。领域问题层面,现有文本到视频模型普遍缺乏对文化细节的精细刻画,难以生成兼具真实性和文化特异性的高质量视频,例如跨文化场景中人物、动作与环境的协调一致性常出现偏差。构建过程中,研究人员需精心设计原始提示与精炼提示的对应关系,并协调四种不同流程的生成结果,确保972条视频在文化属性、动作类型和流程间具有均衡分布,同时克服多智能体协作中语义冲突与视觉风格统一性的技术难题。
常用场景
经典使用场景
在跨文化文本到视频生成研究领域,MAVEN_Multicultura_Text-to-Video_Generation数据集作为评估多智能体框架生成多元文化视频效果的基准数据集而被广泛采用。研究者常借助该数据集对比基线单智能体、单智能体、多智能体顺序及多智能体并行四种流水线的生成质量,通过分析同一动作(如烹饪、舞蹈、演奏)在不同文化背景(中国、美国、罗马尼亚)下的视频表现,深入探究文化细节注入对生成真实感的影响。数据集中精炼提示词与原始提示词的配对设计,为衡量文化感知增强技术提供了标准化的测试平台。
解决学术问题
该数据集致力于解决当前视频生成模型在处理文化多样性时表现不足的学术难题。传统数据集往往集中在单一文化或通用场景,导致模型在生成非主流文化内容时出现刻板印象或细节缺失。MAVEN数据集通过系统性地收录三个国家、三种动作类型的跨文化视频,并区分单一文化与跨文化样本,为研究者提供了量化分析文化偏差、评估文化公平性的重要资源。这一创新设计推动了文本到视频领域从技术性能导向向文化包容性导向的范式转变,显著提升了生成模型在全球化应用中的文化适应能力。
实际应用
在实际应用中,该数据集为开发面向多元用户群体的视频内容生成工具提供了数据根基。例如,广告创意平台可利用其中关于食物、舞蹈、音乐的文化表征数据,训练出能够根据目标市场文化自动调整视觉风格的生成模型,从而产出更具本土亲和力的营销视频。教育科技公司也可借助数据集中的跨文化素材,构建用于语言文化教学的沉浸式视频资源,帮助学习者直观理解不同文化背景下的日常行为差异。此外,该数据集还赋能社交媒体内容生成器,使其在创作包含多文化元素的短视频时能够更自然地融合不同地域的习俗与美学。
数据集最近研究
最新研究方向
基于多智能体协作框架的跨文化文本生成视频研究正逐步成为多模态生成领域的前沿热点。MAVEN数据集聚焦于中国文化、美国和罗马尼亚三大文化背景,囊括饮食、音乐与舞蹈三类动作场景,并通过base、单智能体、多智能体顺序及多智能体并行四种pipeline生成972条精心标注的视频样本,为深入探究文化表征在视频生成中的融入与跨文化理解提供了系统性基准。该数据集不仅支持跨文化与单文化视频的对比分析,还助力构建更具文化包容性的人工智能视频生成系统,推动全球文化多样性在生成模型中的公平呈现与深度融合。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

