
Sayanjib/numfmt-core
收藏官方服务:
资源简介:
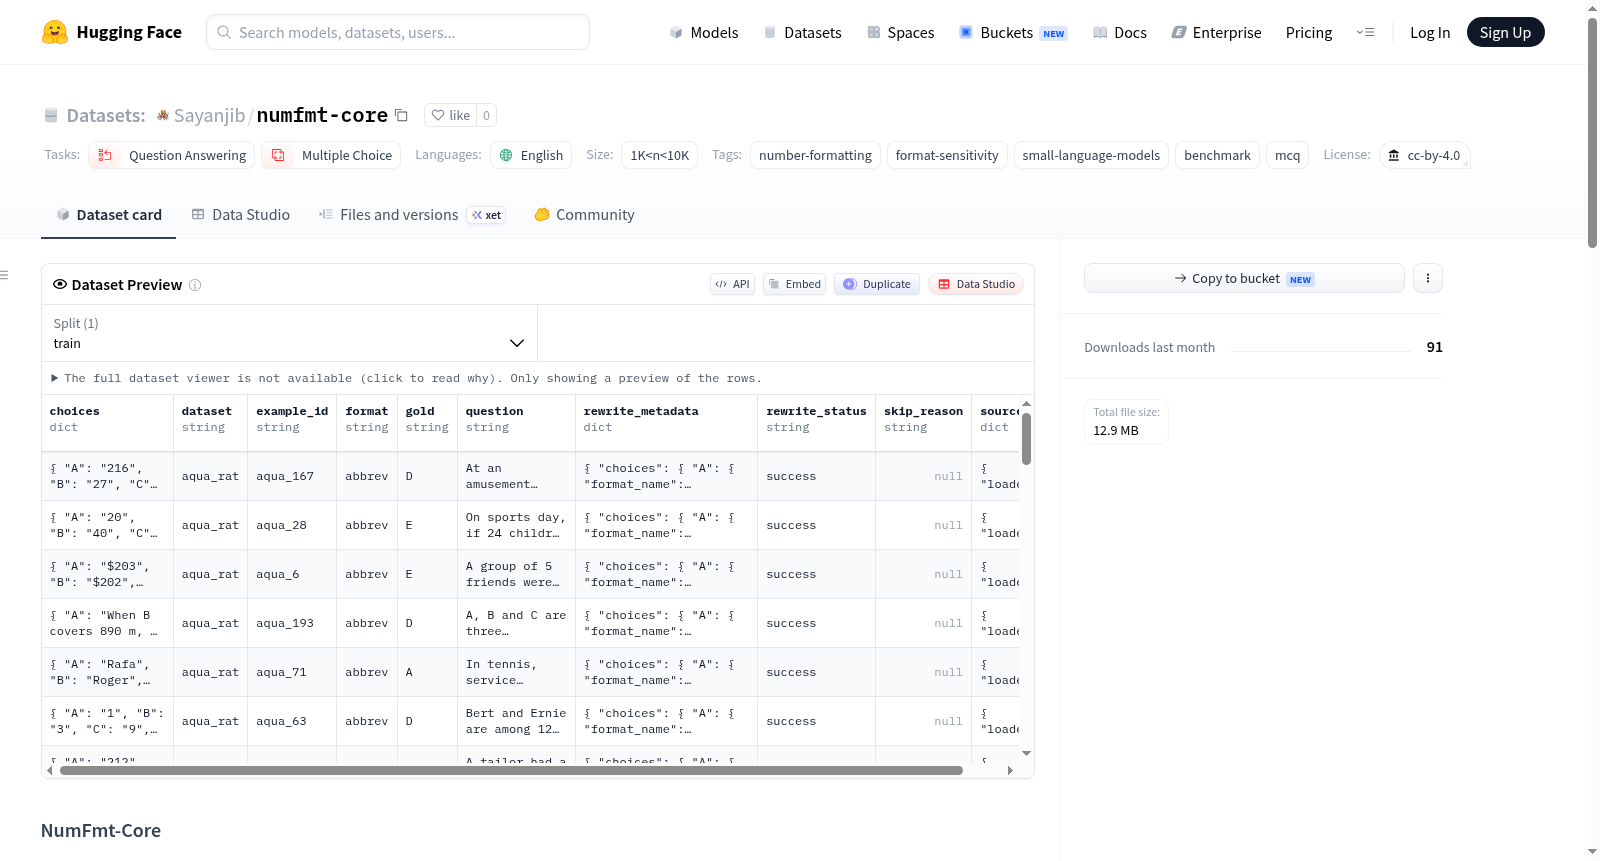
NumFmt-Core是一个用于衡量语言模型中数字格式敏感性的基准数据集。它包含7个数据集(如AQuA-RAT、MMLU-Quantitative、SciQ等),这些数据集被重写为5种数学上等价的数字格式(例如普通格式、逗号分隔格式、文字格式、科学计数法格式和缩写格式),旨在研究数字格式化是否影响小语言模型的推理能力,相关研究发表于2025年的论文中。
NumFmt-Core is a benchmark for measuring number-format sensitivity in language models. It contains 7 datasets rewritten into 5 mathematically equivalent number formats, used in the paper NumFmt-SLM: Does Number Formatting Affect Small Language Model Reasoning? (2025).
提供机构:
Sayanjib搜集汇总
数据集介绍
构建方式
NumFmt-Core 是一个旨在评估语言模型对数字格式敏感性的基准数据集,源自2025年的研究论文《NumFmt-SLM: Does Number Formatting Affect Small Language Model Reasoning?》。该数据集通过将七个原始数据集中的数值分别改写为五种数学上等价的表示形式构建而成,包括纯数字、逗号分隔、英文单词、科学计数法和缩写形式。每个数据集对应特定任务,其中AQuA-RAT、MMLU-Quantitative、SciQ、ARC-Challenge和ARC-Easy为多项选择题,而GSM8K和FinanceBench则属于生成式问答。所有样本均以JSONL格式存储,文件名遵循“数据集__格式”的命名规范,确保格式清晰且易于索引。
特点
NumFmt-Core 的独特之处在于其专注于数字格式的多样性,涵盖了七个子数据集和五种数字表示法,总计超过700个测试样本。每个样本均包含原始问题和经过格式重写的版本,且保留了“rewrite_status”字段以标记改写是否成功,从而确保数据完整性。该基准特别针对小型语言模型设计,通过对比同一模型在不同数字格式下的推理表现,能够精准揭示数字表达方式对模型性能的影响。此外,数据集任务类型兼顾选择题与生成式任务,为评估提供了多维度视角。
使用方法
使用NumFmt-Core时,研究人员可直接从HuggingFace加载JSONL文件,每个文件包含单一格式的样本。对于多项选择题,模型需从给定的选项中选择正确答案;对于生成式任务,模型需输出数值答案。完整的评估流程已封装在开源的GitHub代码库中,支持自动加载数据集、运行推理并计算各格式下的准确率指标。用户可通过调整代码适配不同的语言模型,对比同一模型在五种数字格式下的表现差异,从而深入分析格式敏感性。此外,数据集兼容常见问答和多项选择任务类别,便于集成到现有评估框架中。
背景与挑战
背景概述
NumFmt-Core是一个专为评估语言模型数字格式敏感性而设计的基准数据集,于2025年由相关研究团队在论文《NumFmt-SLM: Does Number Formatting Affect Small Language Model Reasoning?》中提出。该数据集整合了AQuA-RAT、MMLU-Quantitative、SciQ等七个经典问答及推理任务,并将其重写为plain、comma、words、scientific、abbrev五种数学上等价但格式迥异的数字表示形式。通过精心构建的小样本测试集(1K至10K条样本),NumFmt-Core旨在系统揭示小参数规模语言模型在数字格式变化下的推理稳定性与脆弱性,为理解语言模型数值认知机制提供了关键评测工具,对推动可解释人工智能与数值推理领域的研究具有重要影响。
当前挑战
NumFmt-Core所应对的领域核心挑战在于语言模型对数字格式变换的敏感性问题,即模型在解析1,000,000与1.0e+06等不同表示时,其推理能力可能出现显著波动,这暴露了模型在抽象数值理解上的根本局限。在数据构建过程中,研究者面临多重困难:需确保七个源数据集在改写为五种格式后仍保持数学语义等价,尤其是对含有复杂数值上下文的样本进行精准转换;同时,需平衡各格式样本的分布均匀性,避免因格式差异引入新的混淆方差,并设计严格的rewrite_status机制标记转换失败案例,以保障评测的公正性与可比性。
常用场景
经典使用场景
NumFmt-Core是一个专注于探究数字格式对语言模型推理能力影响的基准测试数据集。其经典使用场景在于评估和比较小规模语言模型在不同数字表示形式下的推理表现,涵盖多项选择问答和生成式任务,涉及AQuA-RAT、MMLU-Quantitative、SciQ、ARC-Challenge、ARC-Easy、GSM8K和FinanceBench等多个子数据集。通过将每个数据集中的数值分别以纯数字、逗号分隔、英文单词、科学记数法和缩写格式改写,NumFmt-Core构建了五个数学等价但格式迥异的版本,从而系统性地检验语言模型对数字格式的敏感度。该基准可用于衡量模型在数值理解和数理推理方面的鲁棒性,尤其适合小规模语言模型的评测与改进。
衍生相关工作
NumFmt-Core的发布催生了一系列值得关注的相关工作。首先,其配套论文《NumFmt-SLM: Does Number Formatting Affect Small Language Model Reasoning?》直接建立了格式敏感性研究的方法论框架。后续研究可能在此基础上探索大语言模型是否也受类似格式扰动影响,或者开发针对数字格式鲁棒性的数据增强技术。此外,该基准可与其他数值推理数据集(如MathQA、SVAMP)结合,构建更全面的数字理解评测体系。NumFmt-Core所采用的改写范式也启发了研究者将类似思路延伸至其他符号实体(如单位、日期、货币符号),从而催生更广泛的格式敏感性评测工作,推动语言模型在符号处理层面的深入研究。
数据集最近研究
最新研究方向
NumFmt-Core基准测试揭示了数字表示格式对小型语言模型推理能力的显著影响,尤其是在多步数学推理和定量问答任务中。该数据集将七个标准评测集(如GSM8K、MMLU-Quantitative)重写为五种数学等价但视觉不同的数字格式(纯数字、逗号分隔、文字描述、科学计数法和缩写形式),系统性地评估了模型对数字格式的敏感性。研究显示,小型语言模型在‘逗号分隔’和‘科学计数法’格式下表现不稳定,而‘文字描述’格式往往能提升推理准确性。这一发现不仅对模型训练时的数据增强策略具有重要指导意义,也为构建更鲁棒的数值推理系统提供了新视角,尤其适用于金融计算、科学文献理解等对数字格式敏感的应用场景。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


