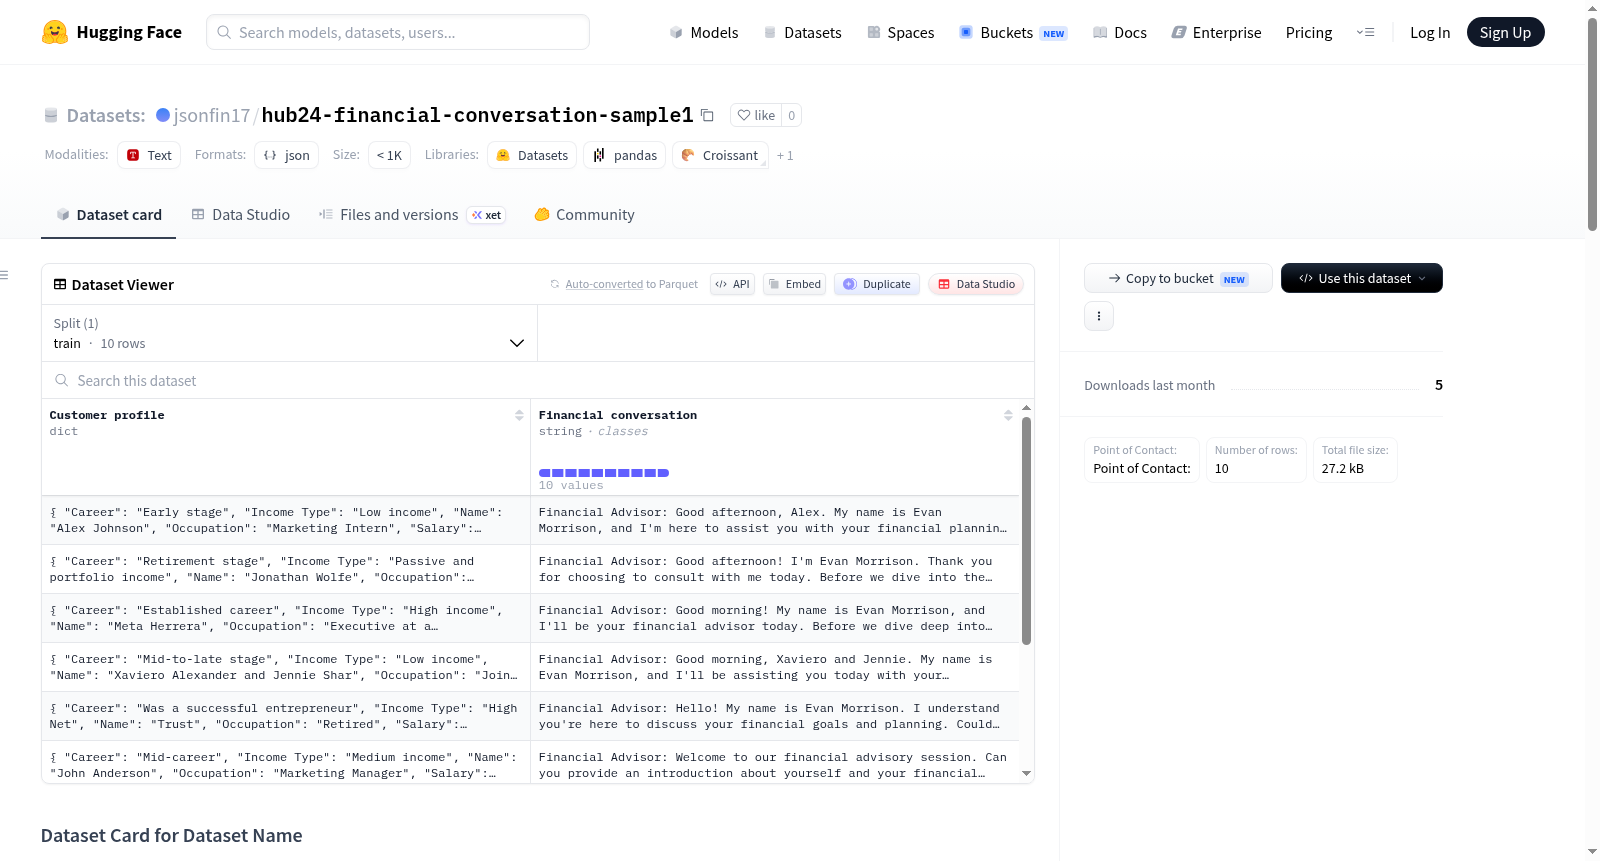
jsonfin17/hub24-financial-conversation-sample1
收藏资源简介:
--- # For reference on model card metadata, see the spec: https://github.com/huggingface/hub-docs/blob/main/datasetcard.md?plain=1 # Doc / guide: https://huggingface.co/docs/hub/datasets-cards {viewer: true} --- # Dataset Card for Dataset Name ## Dataset Description - **Homepage:** - **Repository:** - **Paper:** - **Leaderboard:** - **Point of Contact:** ### Dataset Summary Financial conversation with the provided customer profile ### Supported Tasks and Leaderboards [More Information Needed] ### Languages [More Information Needed] ## Dataset Structure ### Data Instances [More Information Needed] ### Data Fields [More Information Needed] ### Data Splits [More Information Needed] ## Dataset Creation ### Curation Rationale [More Information Needed] ### Source Data #### Initial Data Collection and Normalization [More Information Needed] #### Who are the source language producers? [More Information Needed] ### Annotations #### Annotation process [More Information Needed] #### Who are the annotators? [More Information Needed] ### Personal and Sensitive Information [More Information Needed] ## Considerations for Using the Data ### Social Impact of Dataset [More Information Needed] ### Discussion of Biases [More Information Needed] ### Other Known Limitations [More Information Needed] ## Additional Information ### Dataset Curators [More Information Needed] ### Licensing Information [More Information Needed] ### Citation Information [More Information Needed] ### Contributions [More Information Needed]
# 如需参考数据集卡片元数据规范,请参阅:https://github.com/huggingface/hub-docs/blob/main/datasetcard.md?plain=1 # 文档/使用指南:https://huggingface.co/docs/hub/datasets-cards {viewer: true} # 数据集卡片:数据集名称 ## 数据集描述 - **主页:** - **代码仓库:** - **相关论文:** - **排行榜:** - **联系人:** ### 数据集概述 基于给定客户画像的金融对话内容 ### 支持任务与排行榜 [需补充更多信息] ### 语言类型 [需补充更多信息] ## 数据集结构 ### 数据实例 [需补充更多信息] ### 数据字段 [需补充更多信息] ### 数据划分 [需补充更多信息] ## 数据集构建 ### 遴选依据 [需补充更多信息] ### 源数据 #### 初始数据采集与标准化 [需补充更多信息] #### 源数据的语言生成者为哪些群体? [需补充更多信息] ### 标注信息 #### 标注流程 [需补充更多信息] #### 标注工作由哪些人员完成? [需补充更多信息] ### 个人与敏感信息 [需补充更多信息] ## 数据使用注意事项 ### 数据集的社会影响 [需补充更多信息] ### 偏差问题讨论 [需补充更多信息] ### 其他已知局限性 [需补充更多信息] ## 附加信息 ### 数据集策展人 [需补充更多信息] ### 授权信息 [需补充更多信息] ### 引用信息 [需补充更多信息] ### 贡献声明 [需补充更多信息]
数据集卡片 - 数据集名称
数据集描述
数据集摘要
提供客户资料的金融对话
支持的任务和排行榜
[更多信息需要]
语言
[更多信息需要]
数据集结构
数据实例
[更多信息需要]
数据字段
[更多信息需要]
数据分割
[更多信息需要]
数据集创建
策划理由
[更多信息需要]
源数据
初始数据收集和规范化
[更多信息需要]
源语言生产者是谁?
[更多信息需要]
注释
注释过程
[更多信息需要]
注释者是谁?
[更多信息需要]
个人和敏感信息
[更多信息需要]
使用数据集的考虑因素
数据集的社会影响
[更多信息需要]
偏见的讨论
[更多信息需要]
其他已知限制
[更多信息需要]
附加信息
数据集策展人
[更多信息需要]
许可信息
[更多信息需要]
引用信息
[更多信息需要]
贡献
[更多信息需要]