遇见数据集

zwz-37k

收藏
Hugging Face2026-06-02 更新2026-06-03 收录
官方服务:

资源简介:

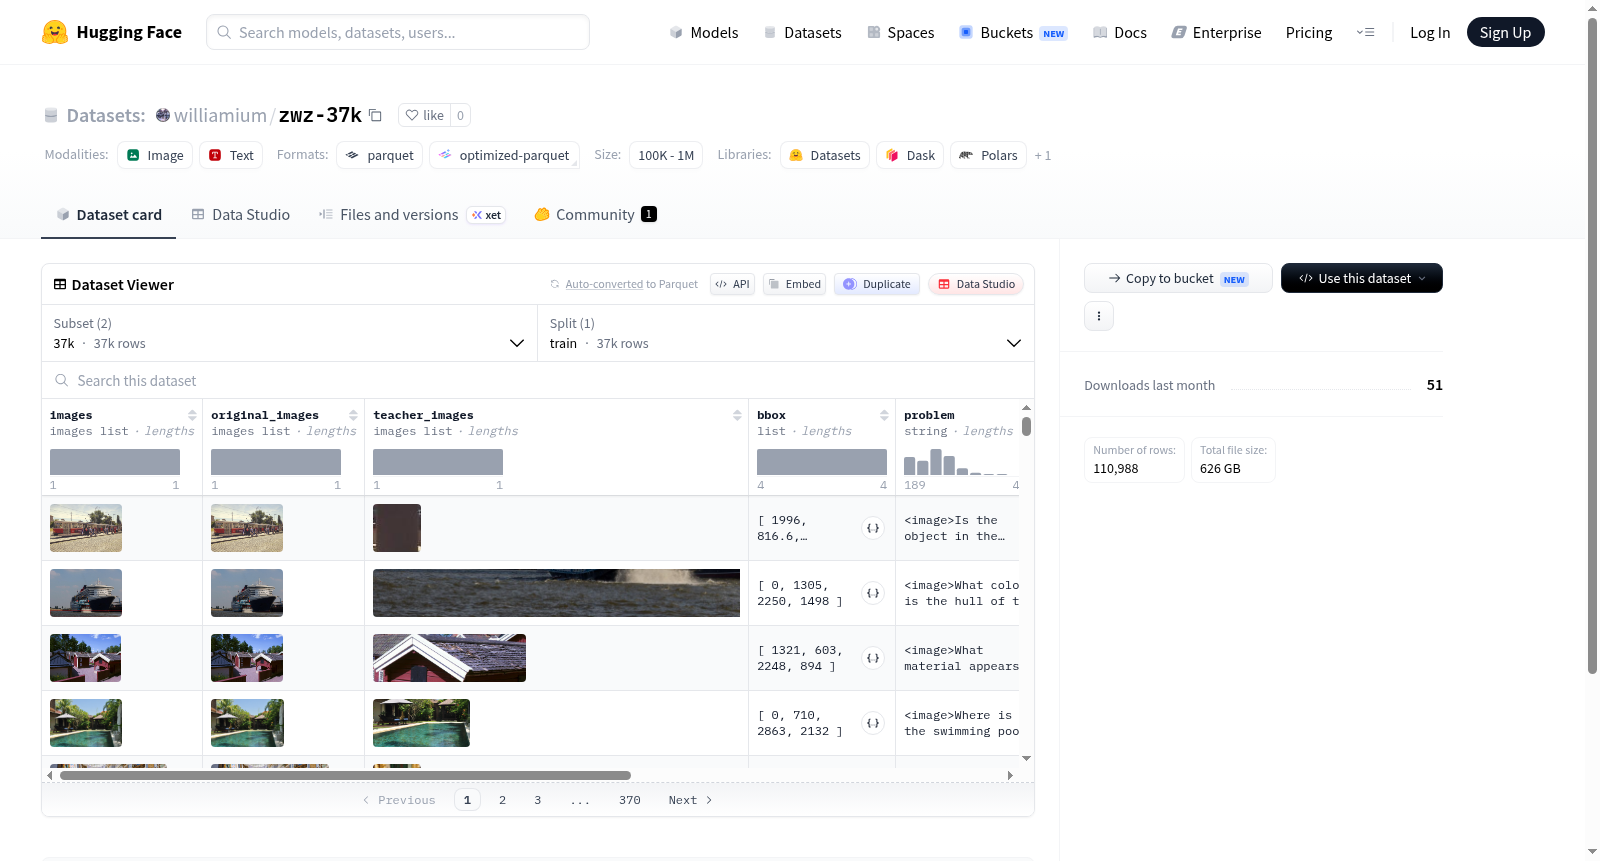
该数据集是一个多模态数据集,包含图像和文本数据,旨在支持视觉问答或相关任务。数据集提供了两个配置版本:37k版本包含36,992个训练样本,数据量约为209GB;74k版本包含73,996个训练样本,数据量约为416GB。每个样本包含以下主要字段:一组图像(images)、原始图像(original_images)、教师图像(teacher_images)、边界框坐标(bbox)、问题文本(problem)、答案文本(answer)、额外信息(extra_info,其中包含question和answer子字段)、能力标签(ability)以及数据来源标识(data_source)。数据集的结构表明其可能用于训练或评估模型在结合视觉和文本信息进行问题解答方面的能力。

This dataset is a multimodal dataset containing image and text data, designed to support visual question answering or related tasks. The dataset provides two configuration versions: the 37k version includes 36,992 training samples with a data volume of approximately 209 GB; the 74k version includes 73,996 training samples with a data volume of approximately 416 GB. Each sample contains the following main fields: a set of images (images), original images (original_images), teacher images (teacher_images), bounding box coordinates (bbox), problem text (problem), answer text (answer), additional information (extra_info, which includes question and answer subfields), ability labels (ability), and data source identifiers (data_source). The structure of the dataset suggests that it may be used for training or evaluating models in combining visual and textual information for question answering.

创建时间:
2026-05-31
原始信息汇总

数据集概述:zwz-37k

该数据集包含两个子配置,分别为 37k74k,均用于训练。

数据特征

所有配置共享相同的特征结构,每个样本包含以下字段:

  • images:图像列表(list: image
  • original_images:原始图像列表(list: image
  • teacher_images:教师图像列表(list: image
  • bbox:边界框列表(list: float64
  • problem:问题描述(string
  • answer:答案(string
  • extra_info:附加信息,包含 answer(答案)和 question(问题),均为 string 类型
  • ability:能力标签(string
  • data_source:数据来源(string

数据划分

配置名称 划分名称 样本数量 数据集大小
37k train 36,992 209,254,991,396 字节
74k train 73,996 416,647,543,176 字节

下载信息

  • 37k 配置:下载大小约为 209,271,616,747 字节
  • 74k 配置:下载大小约为 416,679,782,943 字节
搜集汇总
数据集介绍
zwz-37k 数据集图片
构建方式
该数据集名为zwz-37k,基于多模态视觉与语言交互任务构建。其核心构建方式围绕图像与文本的配对展开,包含三种类型的图像数据:原始图像、教师图像以及生成的图像,每张图像均附带边界框坐标(bbox)信息。文本层面,每条数据包含问题(problem)与答案(answer)字段,并通过extra_info结构保存了额外的问答对,以增强信息的丰富性。数据集提供37k与74k两个配置版本,均以训练集形式发布,分别包含36992和73996个样本,数据规模庞大,适用于训练复杂的多模态模型。
使用方法
使用该数据集时,可通过HuggingFace Datasets库加载,指定配置名称(如'37k'或'74k')即可获取对应训练集。数据以图像列表和文本字段形式提供,可利用边界框坐标进行视觉定位训练,或直接使用问题与答案对进行视觉问答任务。extra_info中的结构化问答对可用于构建更复杂的提示或进行教师-学生模型的训练。建议研究人员根据任务需求,灵活组合多种图像类型和文本字段,以充分发挥该数据集在多模态学习中的潜力。
背景与挑战
背景概述
在多模态大语言模型蓬勃发展的当下,视觉指令微调数据集成为提升模型细粒度视觉理解与推理能力的关键资源。zwz-37k数据集由研究机构于近期创建,专注于视觉定位与描述任务,核心研究问题在于如何利用结构化数据(如图像、边界框、问题与答案对)训练模型在复杂场景下进行精准的视觉定位与逻辑推理。该数据集包含37k与74k两种配置,其中37k版本包含约3.7万训练样本,每样本均配有多视角图像(原始、教师图像)及细粒度能力标注,为多模态对齐与空间关系理解提供了标准化基准。其对相关领域的影响力体现在:推动了视觉指令微调从粗粒度分类向精细化定位与推理的转向,成为评估多模态模型在目标检测、属性描述与空间推理等综合能力的重要测试平台。
当前挑战
zwz-37k数据集所面临的挑战主要来自两个方面。首先,在领域问题层面,现有模型往往难以在复杂视觉场景中同时完成目标定位(通过边界框)与语义理解(通过问题回答),尤其是面对稀疏标注或长尾分布的目标时,模型容易产生空间混淆与属性错配,这需要数据集提供多尺度、多视角的图像对齐信息以弥合视觉与语言之间的鸿沟。其次,在构建过程中,数据集需整合来自不同来源的图像并确保边界框、问题与答案三元组的一致性,由于图像尺寸、视角差异及标注噪声,人工标注极易引入不一致性;同时,教师图像的引入虽旨在提升模型迁移能力,但如何平衡其与原始图像的特征噪声以避免过拟合,亦是数据构建中的核心难题。
常用场景
经典使用场景
在视觉语言导航与多模态推理的交叉领域中,zwz-37k数据集为训练具备空间理解能力的智能体提供了坚实的数据基础。该数据集包含海量的图像序列、边界框标注以及对应的问题-答案对,尤其适合用于视觉语言导航任务,即模型需根据图像中的视觉信息与自然语言问题,精准定位并描述目标物体。此外,其丰富的教师图像与原始图像设计,使其也成为探究跨视角物体识别与语义对应关系的经典选择。
解决学术问题
该数据集主要解决了多模态学习中视觉与语言对齐的细粒度推理难题。通过提供多样化的场景图像与复杂问题,它促使研究者探索模型在遮挡、视角变化及多物体干扰下的准确应答能力。其意义在于推动了视觉定位、视觉问答以及图像描述等领域的评估基准建立,使得模型性能的量化对比更加公正合理。学术界借助它能更高效地验证新颖的空间注意力机制与多模态融合策略。
实际应用
在实际应用中,zwz-37k数据集可服务于智能辅助导航系统与增强现实设备。例如,它可以训练机器人在未知环境中根据语音指令寻找特定物品,或帮助视障人士通过图像问答理解周围环境。在公共服务领域,该数据集还能优化智能监控系统中的目标检索功能,提升安防效率。此外,它在教育场景中可用于开发交互式学习工具,支持学生通过图像对话获取知识。
数据集最近研究
最新研究方向
在当前多模态大模型竞相涌现的时代浪潮中,zwz-37k数据集凭借其精心设计的图像—文本对结构,尤其是创新性地引入教师图像与边框标注,为视觉定位与细粒度推理任务开辟了新的研究路径。该数据集不仅囊括了问题与答案的配对,更通过ability与data_source字段实现了对模型能力维度的精细刻画,这与近期学界对多模态模型可解释性与认知边界的探讨不谋而合。面对诸如LMMs在复杂场景下的语义理解瓶颈等热点议题,zwz-37k所提供的高质量、多来源训练样本,正成为推动从视觉对话到具身智能等前沿方向发展的关键基石,其影响深远地重塑着数据驱动下智能推理的范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务