infraset
收藏资源简介:
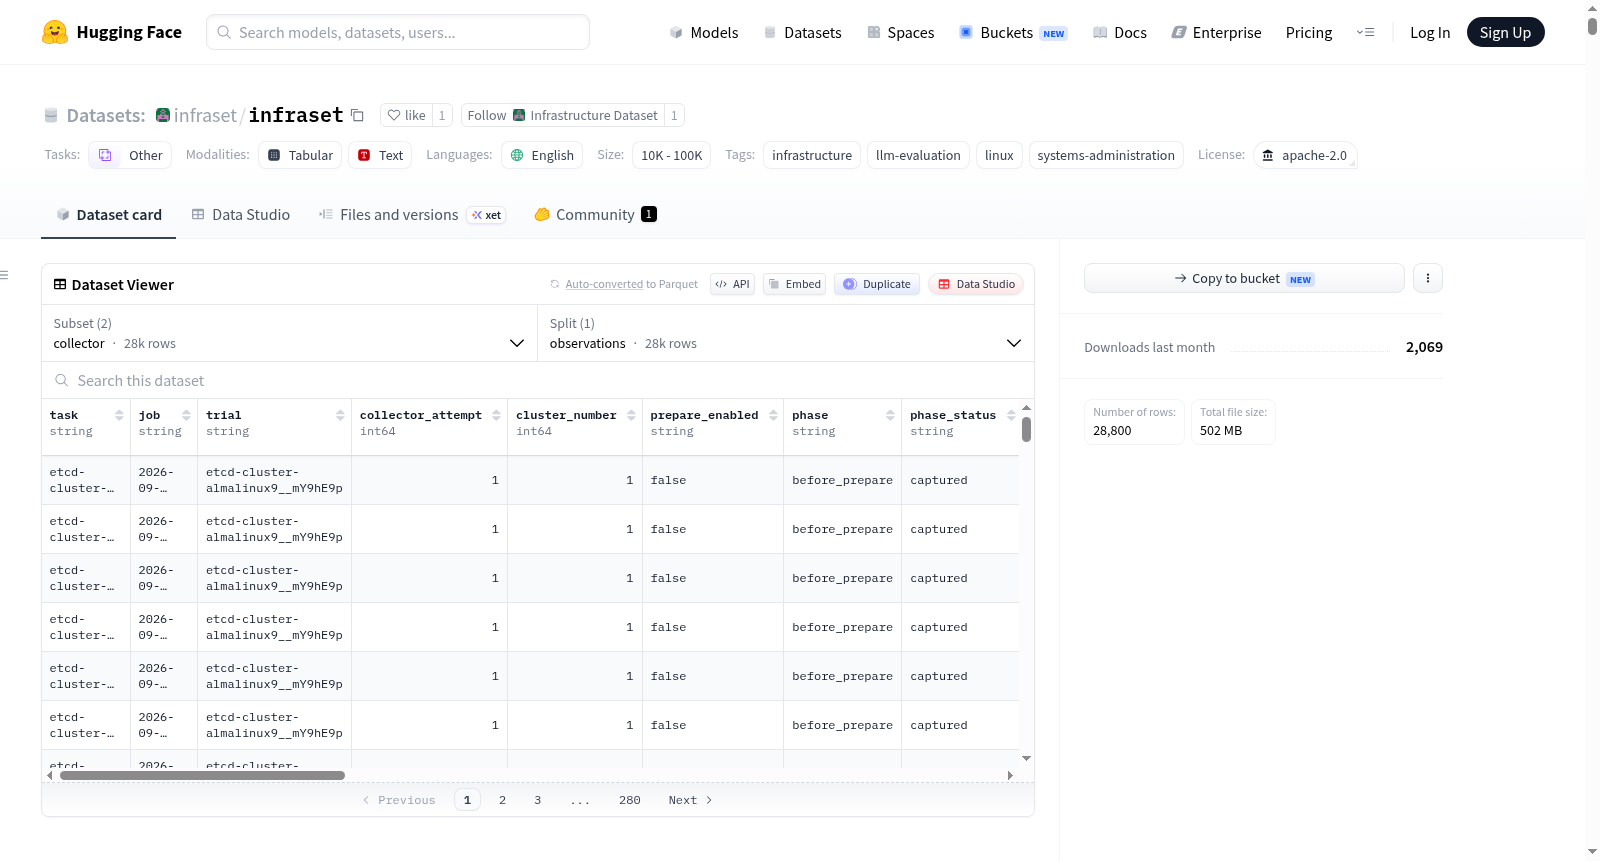
InfraSet 是一个开放数据集,记录了 LLM 执行基础设施任务的过程和结果。该数据集旨在为 LLM 在真实系统(包括新部署、已有系统、生命周期末期或分布式环境)中的操作表现提供实证数据。当前版本包含 800 个任务和 43970 条已执行的命令(其中 39511 条成功,4459 条失败)。数据集分为两个配置:execution-summary(任务执行摘要)和 collector-observations(收集器观测)。每个任务记录包括环境(如 AlmaLinux 9、Alpine、CentOS Stream 10 等)、命令统计(成功/失败)、奖励分数(Reward)、覆盖率(Coverage)、功能得分(Functionality)、操作卫生得分(Hygiene)以及时间指标(部署时间和执行时间)。该数据集适用于评估 LLM 在系统管理与基础设施自动化方面的能力。
InfraSet is an open dataset that records the processes and results of LLMs performing infrastructure tasks. This dataset aims to provide empirical data on the operational performance of LLMs in real-world systems, including new deployments, existing systems, end-of-life systems, or distributed environments. The current version includes 800 tasks and 43,970 executed commands (39,511 successful and 4,459 failed). The dataset is divided into two configurations: execution-summary and collector-observations. Each task record includes the environment (e.g., AlmaLinux 9, Alpine, CentOS Stream 10, etc.), command statistics (success/failure), reward score, coverage, functionality score, hygiene score, and time metrics (deployment time and execution time). This dataset is suitable for evaluating the capabilities of LLMs in system management and infrastructure automation.
InfraSet 数据集详情
基本信息
- 数据集名称: InfraSet
- 许可证: Apache-2.0
- 语言: 英语(en)
- 标签: 基础设施、LLM评估、Linux、系统管理
- 任务类别: 其他
- 数据规模: 少于 1K 条(n<1K)
数据集概述
InfraSet 是一个记录 LLM(大语言模型)执行基础设施任务的数据集,包含任务执行结果与完整追踪信息。该数据集旨在为 LLM 在真实系统(包括绿地、棕地、退役或分布式环境)中操作基础设施的表现提供公开的经验数据,弥补当前缺乏相关实证依据的空白。
数据配置
数据集包含两个配置:
- execution-summary: 任务执行摘要,数据文件位于
data/execution-summary.jsonl - collector: 观测数据,数据文件位于
data/collector-observations.jsonl
执行摘要说明
数据集共记录了 800 个任务 和 43,970 条已完成执行命令,其中 39,511 条成功,4,459 条失败。各项任务按指标(平均值)进行评估,具体指标含义如下:
- Commands: 成功/失败的执行命令数(
0/0表示有审计记录但无命令请求;audit unavailable表示无审计产物) - Reward: 成功结果得分
- Coverage: 覆盖率
- Functionality: 功能完整性
- Operational hygiene: 运维卫生度(检测执行过程中的不必要变更、遗留残留及无关回归;
1.000表示未发现问题,0.000表示无卫生得分) - Provisioning time: 预配置时间
- Execution time: 执行时间
一个失败的命令仅代表一次不成功的尝试,并不必然意味着最终任务失败。
任务任务与环境
数据集任务围绕多个集群服务和多种操作系统环境展开。任务类型包括:
- etcd-cluster: etcd 集群搭建
- etcd-member-replacement: etcd 成员替换
- mariadb-galera-cluster: MariaDB Galera 集群搭建
- mariadb-galera-cold-restart: MariaDB Galera 冷重启
- mariadb-galera-scale-out: MariaDB Galera 扩容
- postgresql-failover: PostgreSQL 故障转移
- postgresql-replication-tls: PostgreSQL TLS 复制
- postgresql-streaming-replication: PostgreSQL 流复制
- rabbitmq-cluster: RabbitMQ 集群搭建
- rabbitmq-tls: RabbitMQ TLS 配置
支持的环境操作系统包括:
- AlmaLinux 9
- Alpine
- CentOS Stream 10
- RHEL 7.9 / 8 / 9 / 10
- Ubuntu 16.04
各类任务的实例数通常为 3 或 4 个节点环境。
执行结果示例(部分)
以 PostgreSQL 在 RHEL9.8 环境为例:postgresql-failover-rhel9 任务的成功率表现最佳(命令成功/失败: 75/0,Reward: 1.000,Hygiene: 0.850,执行时间: 6m06s);而 postgresql-replication-tls-rhel9 的 Hygiene 仅为 0.600,说明执行过程中存在不必要的变更或残留。
在 Ubuntu 16.04 环境下的 mariadb-galera-cold-restart-ubuntu16 任务奖励得分最低(Reward: 0.750,Functionality: 0.750,Hygiene: 0.500,执行时间: 40m00s),表明该任务在部分指标上未完全达到预期。