
pl-legal-instruct-sample
收藏官方服务:
资源简介:
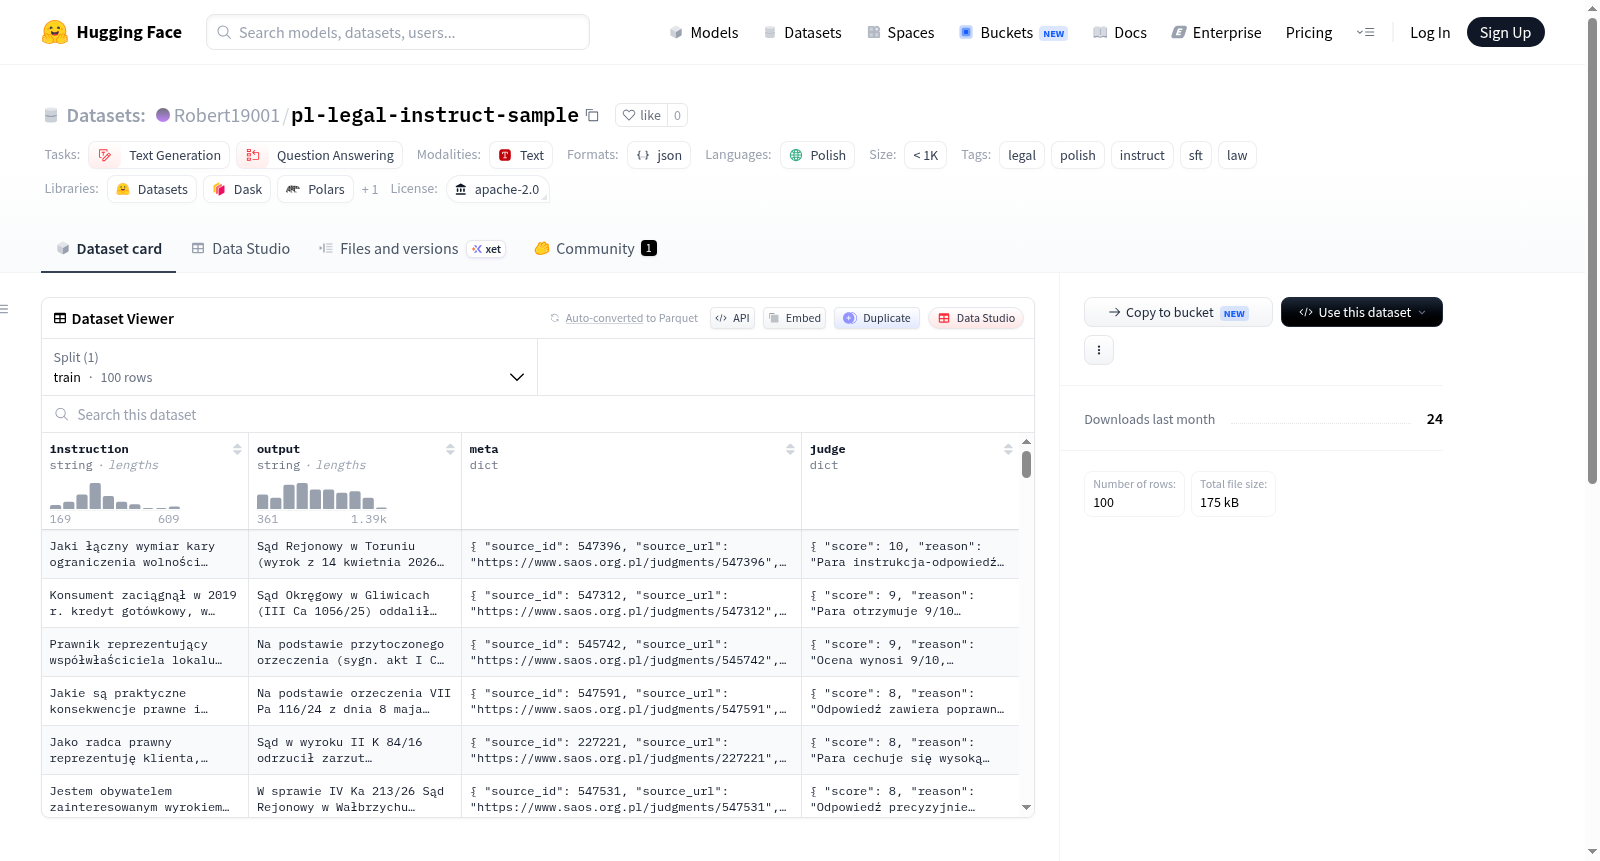
PL Legal Instruct是一个波兰语法律领域的指令数据集,专门用于文本生成和问答任务。该数据集基于波兰公开的法院判决(通过SAOS API获取)构建,包含instruction-output配对样本。数据格式为JSONL,每条记录包含instruction(指令)、output(输出)、meta(元数据)和judge(评分及理由)字段。数据集经过严格的质量控制:首先通过LLM-as-judge自动筛选(评分阈值7/10),然后进行人工抽查。语言为100%波兰语,采用法律专业风格。当前完整数据集包含459个样本(持续更新中),本示例版本包含50个样本。该数据集旨在用于训练法律领域的语言模型,但明确声明不构成法律建议。
创建时间:
2026-07-06
原始信息汇总
数据集概述:PL Legal Instruct (Sample)
- 名称:PL Legal Instruct (Sample)
- 许可证:Apache-2.0
- 语言:波兰语 (pl)
- 任务类别:文本生成、问答
- 标签:法律、波兰语、指令、SFT、法律
- 大小:n<1K(样本包含50对指令-输出)
数据集内容
- 来源:基于波兰公共法院判决(来自SAOS API),经过LLM-as-judge过滤(阈值7/10)和人工抽查。
- 格式:JSONL格式,每条记录包含:
instruction:指令output:输出meta:元数据judge:评分(score 0-10)和理由(reason)
- 去重:余弦相似度≥0.92的项已去重
- 语言风格:100%波兰语,法律专业风格
数据集用途
- 适用于训练法律领域的文本生成和问答模型
- 标注为非法律建议,仅供模型训练使用
完整数据集
搜集汇总
数据集介绍
构建方式
PL Legal Instruct Sample数据集源自波兰公共司法裁决(SAOS API),通过自动化流程生成指令-输出对,并经由LLM-as-Judge机制(阈值7/10)进行过滤筛选,辅以人工抽查以确保质量。目前完整语料库涵盖459对数据,且每日持续扩展,数据来源仅限于官方法律文档,并通过余弦相似度高于0.92的阈值去除冗余样本,确保内容独特性。
特点
该数据集以纯波兰语呈现,聚焦法律领域风格,包含标准化的指令与输出格式,每条记录携带元数据及评审评分与理由,支持监督式微调与文本生成任务。其样本规模虽小(50对),但完整版为付费产品,提供标准版与专业版,分别对应不同数据量需求,且购买后可获取持续更新的完整版本。
使用方法
数据集以JSONL格式存储,每行包含'instruction'、'output'、'meta'及'judge'字段,可直接用于训练文本生成或问答模型。用户可通过HuggingFace平台下载示例子集,完整版需通过Gumroad链接购买,数据集仅用于模型训练目的,不构成法律建议。
背景与挑战
背景概述
在法律人工智能领域,高质量指令微调数据集的匮乏长期制约着波兰语法律大语言模型的发展。PL Legal Instruct Sample数据集由研究机构或个人研究者Robertian040于近期创建,旨在通过提取公开司法判决(源自SAOS API)构建波兰语法律指令对,当前完整语料库包含459对指令-输出样本。该数据集以Apache-2.0许可证发布,专注于文本生成与问答任务,其核心研究问题在于如何利用官方法律文档生成结构化的监督微调数据,以提升模型在法律文本理解与生成方面的能力。作为波兰法律NLP领域的先驱性资源,该数据集通过LLM-as-judge评分(阈值7/10)与人工抽检双重质量把控,为后续波兰语法律模型训练提供了基础基准。
当前挑战
该数据集面临的挑战首先体现在领域问题的复杂性:法律文本的语义精确性与逻辑严谨性要求远超通用领域,模型需掌握波兰法律特有的术语体系、条文引用规范及判例推理逻辑,而现有指令对的数据规模(不足500对)难以覆盖法律咨询、合同审查等细粒度场景。构建过程中面临的挑战包括:从非结构化的公开判决书中自动提取高质量指令-输出对时,如何平衡生成内容的忠实性与多样性;余弦相似度去重阈值(≥0.92)可能导致语义相近但法律要点不同的样本被误删;人工抽检虽保障基础质量,但样本量增长(每日新增)使得持续质量控制成为资源密集型任务,且商业版本(Standard/Pro)的存在也引发了数据获取公平性的讨论。
常用场景
经典使用场景
在法律自然语言处理领域,高质量指令数据集稀缺,尤其针对波兰语系。PL Legal Instruct Sample 作为波兰法律指令微调数据集的开源样本,源自公开法院判决(API SAOS),经 LLM-as-judge 筛选与人工校验,为研究者提供 50 对高质量 instruction-output 示例。其经典使用场景聚焦于监督微调(SFT)法律大语言模型,通过注入波兰法律术语、司法推理逻辑与结构化文书风格,显著提升模型在法律问答与文本生成任务中的专业适配性。该样本虽小,却奠定了完整语料库(459 对)的构建范式,成为波兰法律 NLP 社区微调基线模型的基石。
实际应用
在现实场景中,该数据集驱动的模型可直接服务于波兰法律实务的多个核心环节。律师助理可利用微调后的模型快速检索判例、起草法律意见书摘要或生成标准化法律文书模板,显著提升工作效率。法院与法律咨询平台能部署该模型进行法律知识问答,为公民提供初步法律指引,缓解司法资源不均。此外,法律教育机构可借助模型生成的拟真判例对话,辅助学生理解法律推理过程。该数据集的实用性根植于严格的公共文书来源,确保了输出内容的权威性与合规性,规避了非正式语料带来的法律风险。
衍生相关工作
围绕 PL Legal Instruct 已衍生出若干关键进展。完整版本的 Standard 与 Pro 数据集(分别包含 459+ 对样本)提供了更丰富的指令覆盖范围,成为波兰法律大语言模型微调的核心资源。其构建方法论——基于公共判决 API 的自动化生成、LLM-as-judge 过滤与人工抽检——已被后续波兰法律 NLP 项目借鉴,形成数据采集基线。未来可预见的工作包括:多任务法律数据集(如结合合同审查与法律预测)、跨语言法律指令数据集(波兰-英语对齐),以及基于该数据的法律专用评估基准(Legal Benchmark),推动波兰法律 AI 生态的系统化发展。
以上内容由遇见数据集搜集并总结生成


