
dataset-stock-saas
收藏官方服务:
资源简介:
SaaS Data Lab是一个用于AI数据处理的实验室数据集,构建于一个虚构的订阅制SaaS系统的原始导出数据之上。
SaaS Data Lab is a laboratory dataset for AI data processing, built upon raw exported data from a fictional subscription-based SaaS system.
创建时间:
2026-09-02
原始信息汇总
数据集概述:SaaS Data Lab
这是一个用于AI辅助数据清洗练习的SaaS订阅数据集,包含12个月份的“脏数据”CSV导出文件,专为学习数据处理(清洗、标准化、去重和SaaS指标计算)场景设计。所有数据均为虚构,仅供教学使用,由Digital Innovation One(DIO)开发。
核心内容
- 数据集规模:约 40,627 行原始数据。
- 文件构成:
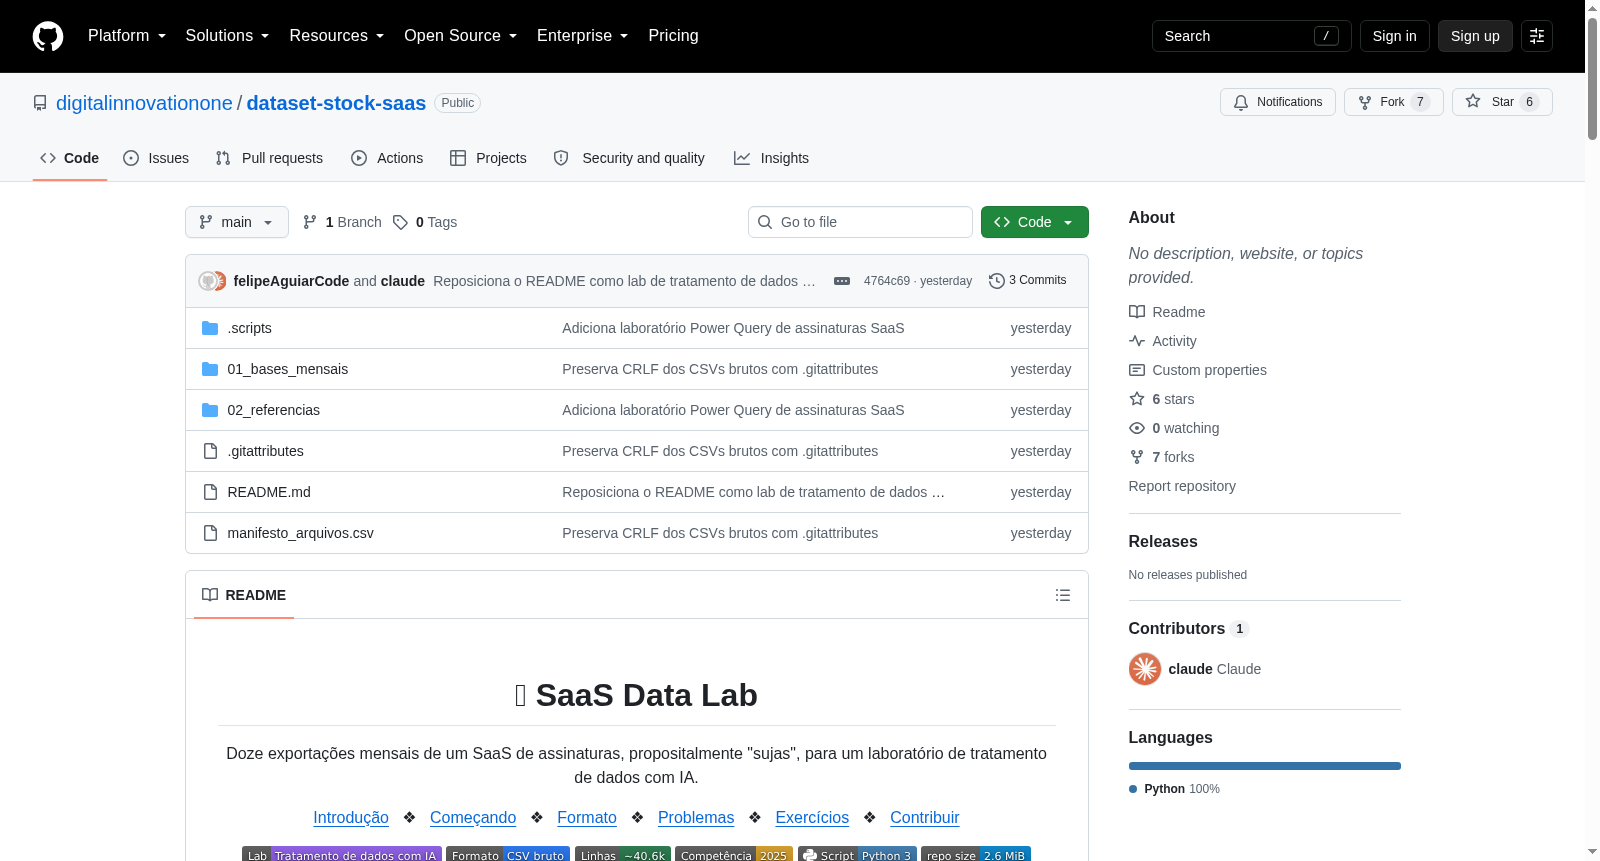
01_bases_mensais/:12个模拟月度导出的CSV文件(saas_assinaturas_2025_MM_mes.csv),覆盖2025年1月至12月。02_referencias/:dimensoes_referencia_saas.xlsx,用于验证订阅计划和状态的参考维度数据表。
- 数据特征:
- 文件格式:CSV(分隔符
;,UTF-8编码含BOM,CRLF换行)。 - 每个CSV文件都含有页眉元数据块、页脚汇总数据,且表头行位置不固定(位于第6至第9行之间)。
- 不同月份文件包含的列数不同(41、42或43列)。
- 数值字段(如价格)用逗号作为小数点,日期采用多样化的格式。
- 文件格式:CSV(分隔符
数据质量问题(人为设计)
- 缺失值、精确重复和近似重复记录
- 多种日期格式;金额既以数字形式也存在文本形式(如
R$ 299,90) - 货币写法不统一(如
BRL、Real):计划和状态值存在大小写、空格和别名不一致 - ID号含多余空格;无效及缺失的电子邮件
- 文件中存在全空白行
- 部分非法值:如激活席位多于签约席位、负席位、负净价
- 业务规则冲突:状态与取消日期存在逻辑不符
- 在特定月份中,有少量记录会被缺失
- 格式漂移:部分月份的列名被重命名、移除或新增(详情见Schema变化表)
- 页眉位于文件开头而非首行且有元数据块;页脚数据(如
Total de registros)混合在数据中 - 文件列数不固定(41/42/43列)
Schema 随月份的变化
- 2025年3月:
plano更名为plano_nome - 2025年5月:缺少
cupom列(仅有41列) - 2025年7月:
status_assinatura→subscription_status;mrr→receita_mrr - 2025年9月:新增额外的
taxa_setup列(共43列) - 2025年11月:
cliente_id更名为customer_id
数据清洗的主要任务
- 动态定位表头行:寻找首个字段为
assinatura_id的行,并弃用其上方的元数据。 - 清理页脚:移除
Total de registros、Fim da exportacao及空白行。 - 整合字段名:在合并12个月份数据前,统一不同月份间改动的列名。
- 从元数据提取补充字段:将
Competencia和Sistema origem作为新列加入合并后的表中。 - 去重:删除精确重复与近似重复的数据。
- 数据标准化:统一
plano、status、货币、UF与支付方式等字段。 - 处理杂乱的日期和金额:解析多格式的日期,把带逗号或
R$符号的文本型数字转换为十进制数值。 - 质量检查:核查电子邮件、席位数、状态与取消日期的逻辑一致性。
- 引用数据验证:用
dimensoes_referencia_saas.xlsx中的官方名称核对计划和状态。 - 计算月度SaaS指标:分析新客户数、取消数、重新激活数、MRR(月经常性收入)、客户流失率和坏账率。
辅助工具
manifesto_arquivos.csv:提供每个文件大概行数和列数的参考。.scripts/converter_xlsx_para_csv_bruto.py:用于从原始.xlsx文件生成及校验CSV(包含元数据前缀、页脚、BOM等)。
适用建议
该数据集适合需要使用AI工具、编程语言(如Python)或数据处理平台来学习数据清洗、类型转换、重复项处理及SaaS业务指标分析的用户。该实验室不依赖特定工具,用户可自由选择。
搜集汇总
数据集介绍
构建方式
该数据集源自一个虚构的SaaS订阅系统,模拟了真实世界从系统导出月度CSV文件至‘另存为’操作的全过程。它汇集了2025年1月至12月共12个月的原始导出文件,每个文件均包含元数据块、动态头部、数据主体及页脚信息。数据以分号分隔,采用UTF-8 with BOM编码及CRLF换行,并特意保留了多样化的数据格式,如十进制逗号、不同日期格式及字符型货币值。此外,数据集还包含了参考维度表格及生成脚本,以支持从Excel到CSV的转换验证。
特点
该数据集的核心特色在于其刻意嵌入的多样数据质量问题,旨在模拟真实数据清洗挑战。这包括大量缺失值、精确及近似重复项、格式不统一的日期与货币、列名随时期变更导致的schema漂移、表头位置不固定且被元数据包围、页脚混入数据主体、文件列数波动(41至43列)等。这些问题散布在约40,627行数据中,并伴有业务规则冲突如订阅状态与取消日期的矛盾,为学习数据清洗、标准化与特征工程提供了极具价值的实战素材。
使用方法
使用者可自由选用任何AI工具或数据处理环境,数据集不绑定特定平台。推荐的起始步骤包括克隆仓库或下载ZIP以获取CSV文件,并通过查看文件首尾行理解其结构。处理流程聚焦于动态识别表头(以‘assinatura_id’为标记)、移除页脚与空行、统一格式与列名,并整合12个月数据至单一表格。进阶操作涉及从元数据提取附加信息、去重、标准化,以及计算SaaS关键指标如MRR和流失率,参考文件提供了验证维度的标准指南。
背景与挑战
背景概述
dataset-stock-saas,由Digital Innovation One于2025年发布,旨在为AI辅助的数据清洗与处理提供真实模拟的SaaS订阅数据集。该数据集包含12个月份的CSV导出文件,约40,627行,刻意注入了多种数据质量问题,如图数据混杂、表头位置漂移、数值格式不统一等。其核心研究问题聚焦于如何利用AI技术处理非结构化、脏乱的企业数据,并推动SaaS指标(如MRR、流失率)的准确计算。作为教育性资源,它在数据科学和AI教学领域具有显著影响力,为学习者提供了从原始数据到分析就绪数据的全流程实践平台。
当前挑战
针对该数据集,主要挑战涵盖领域问题和构建过程两方面。领域问题方面,数据集旨在模拟SaaS企业数据治理中的常见难点,包括多格式日期与货币混用、重复记录、业务规则冲突、以及字段语义漂移(如列名变更),这些因素直接导致数据质量评估和机器学习建模的复杂性增加。构建过程中,需确保数据真实性与逻辑自洽,例如在12个CSV文件中人为设置不一致的表头位置、缺失列、额外列及元数据块,同时维持约4万行数据内的错误模式分布平衡,迫使学习者开发动态的解析算法而非硬编码规则,考验AI模型的鲁棒性和适应性。
常用场景
经典使用场景
在数据科学教学与研究领域,SaaS Data Lab 数据集常被用作数据清洗与预处理的标准演练场。该数据集模拟了真实世界中SaaS订阅系统导出的原始CSV文件,内含元数据块、混杂的页脚、动态表头位置、缺失值、重复项、多格式日期与货币、以及模式漂移等复杂问题。研究者与学习者可借此深入实践表头动态定位、页脚剔除、列名统一、类型转换、去重及数据标准化等经典数据整理流程,从而在可控环境下锤炼处理脏数据的能力。
解决学术问题
该数据集有效回应了学术研究中长期存在的数据质量与数据准备难题。它以贴近实际的原始形态,暴露了自动化数据处理流程中的关键障碍,如格式混杂、空值处理、重复记录、以及字段语义漂移等。通过对比原始文件与清洗后结果,研究者能够系统性地评估不同清洗策略、异常检测算法及模式匹配技术的性能,进而为数据管道的构建、数据治理规则的制定提供量化依据,推动该领域方法论向更稳健与高效的方向演进。
衍生相关工作
基于 SaaS Data Lab 的结构特性与丰富问题预设,研究社区已衍生出多类创新工作。其一,针对表头漂移与非固定行号的挑战,催生了动态读取CSV文件的智能化解析方案,推动了数据导入库的鲁棒性研究。其二,该数据集常被作为基准,用于验证大语言模型(LLM)在复杂数据整理任务中的能力,并进而驱动了“数据清洗辅助Agent”或“自动化数据工程提示词”等的研究。此外,以该数据集为原型,亦有工作延伸至数据质量评估框架的构建,探索多维度的质量度量体系与自动修复策略,为构建下一代自适应数据治理工具提供了关键洞察。
以上内容由遇见数据集搜集并总结生成


