
universalner/uner_llm_instructions
收藏官方服务:
资源简介:
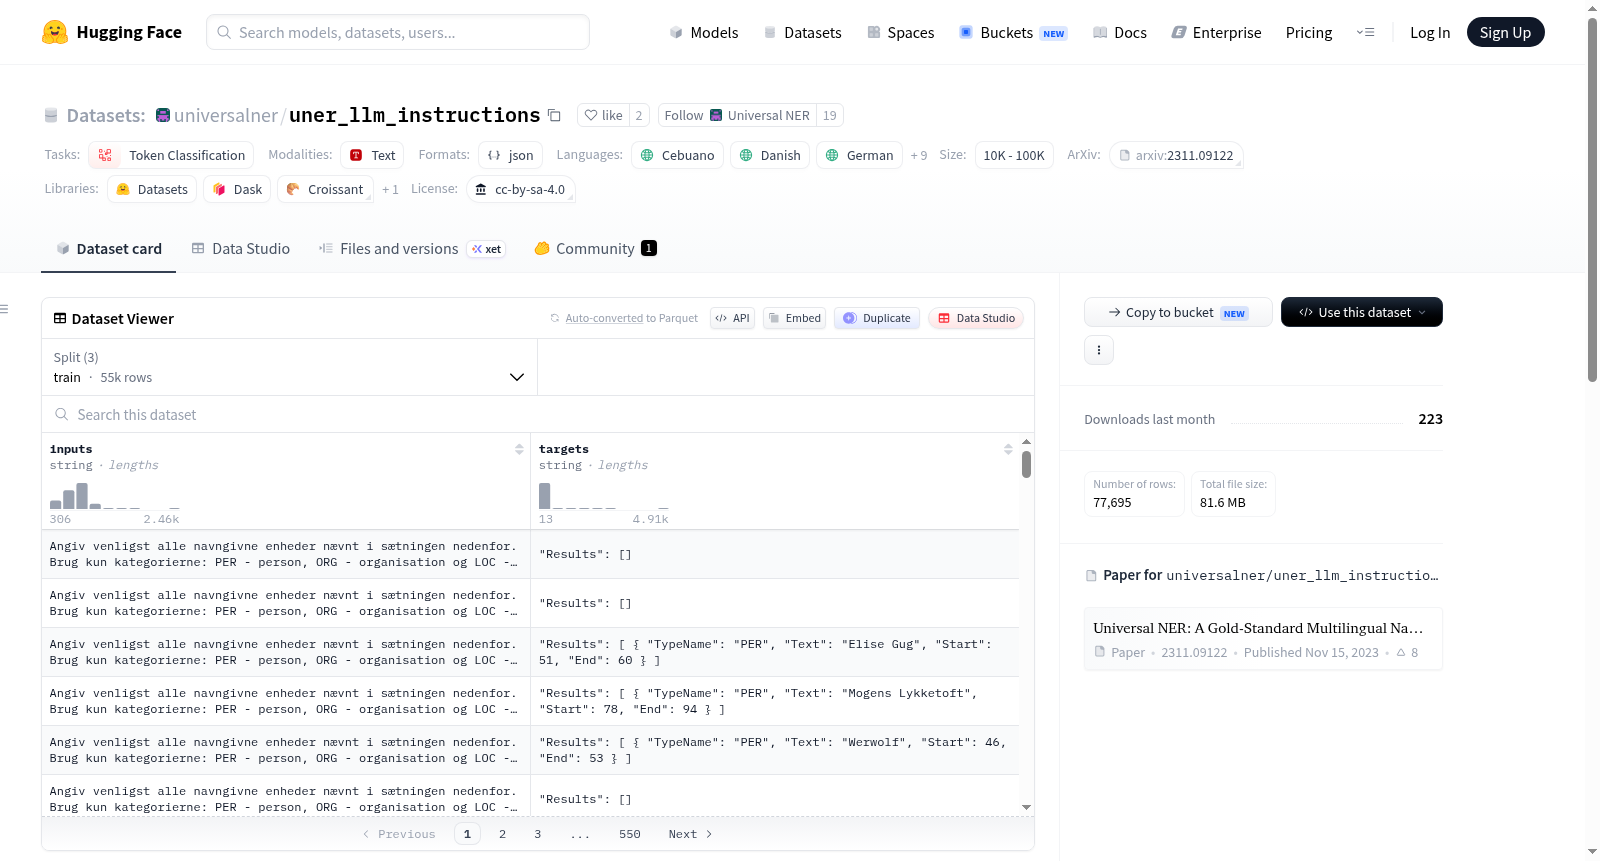
该数据集是Universal NER v1数据集从原始格式转换为Aya指令格式的版本,并在相同的CC-BY-SA 4.0许可下发布。它包含多种语言的数据,旨在用于多语言大语言模型的构建和调优。数据集中包含不同语言的子集及其开发/测试/训练分割的样本数量。
该数据集是Universal NER v1数据集从原始格式转换为Aya指令格式的版本,并在相同的CC-BY-SA 4.0许可下发布。它包含多种语言的数据,旨在用于多语言大语言模型的构建和调优。数据集中包含不同语言的子集及其开发/测试/训练分割的样本数量。
提供机构:
universalner原始信息汇总
数据集卡片 - Universal NER v1 in the Aya format
数据集概述
该数据集是从原始v1格式转换为Aya指令格式,并在此处以相同的CC-BY-SA 4.0许可证和条件发布。它包含多种语言的数据,旨在用于多语言LLM的构建/调优。
语言支持
数据集支持以下语言:
- 宿务语 (ceb)
- 丹麦语 (da)
- 德语 (de)
- 英语 (en)
- 克罗地亚语 (hr)
- 葡萄牙语 (pt)
- 俄语 (ru)
- 斯洛伐克语 (sk)
- 塞尔维亚语 (sr)
- 瑞典语 (sv)
- 塔加洛语 (tl)
- 中文 (zh)
任务类别
- 标记分类 (token-classification)
数据集配置
数据集包含多个子集及其开发/测试/训练拆分,具体取决于语言。以下是各语言配置的详细信息:
英语 (en)
- en_pud
- 测试集 (test): 999 个样本
- en_ewt
- 测试集 (test): 2076 个样本
- 开发集 (dev): 2000 个样本
- 训练集 (train): 12542 个样本
葡萄牙语 (pt)
- pt_pud
- 测试集 (test): 999 个样本
- pt_bosque
- 测试集 (test): 1166 个样本
- 开发集 (dev): 1171 个样本
- 训练集 (train): 4302 个样本
瑞典语 (sv)
- sv_pud
- 测试集 (test): 999 个样本
- sv_talbanken
- 测试集 (test): 1218 个样本
- 开发集 (dev): 503 个样本
- 训练集 (train): 4302 个样本
德语 (de)
- de_pud
- 测试集 (test): 999 个样本
俄语 (ru)
- ru_pud
- 测试集 (test): 999 个样本
中文 (zh)
- zh_pud
- 测试集 (test): 999 个样本
- zh_gsd
- 测试集 (test): 499 个样本
- 开发集 (dev): 499 个样本
- 训练集 (train): 3996 个样本
- zh_gsdsimp
- 测试集 (test): 499 个样本
- 开发集 (dev): 499 个样本
- 训练集 (train): 3996 个样本
丹麦语 (da)
- da_ddt
- 测试集 (test): 564 个样本
- 开发集 (dev): 563 个样本
- 训练集 (train): 4382 个样本
克罗地亚语 (hr)
- hr_set
- 测试集 (test): 1135 个样本
- 开发集 (dev): 959 个样本
- 训练集 (train): 6917 个样本
塞尔维亚语 (sr)
- sr_set
- 测试集 (test): 519 个样本
- 开发集 (dev): 535 个样本
- 训练集 (train): 3327 个样本
斯洛伐克语 (sk)
- sk_snk
- 测试集 (test): 1060 个样本
- 开发集 (dev): 1059 个样本
- 训练集 (train): 8482 个样本
塔加洛语 (tl)
- tl_trg
- 测试集 (test): 127 个样本
- tl_ugnayan
- 测试集 (test): 93 个样本
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,命名实体识别(NER)是信息抽取的核心任务之一。universalner/uner_llm_instructions数据集是基于Universal NER v1基准数据集,经过格式转换而构建的。原始数据集汇集了来自多个语种的高质量NER标注数据,涵盖英语、德语、葡萄牙语、中文等12种语言,并依据不同语料库(如PUD、EWT、DDT等)划分出训练、验证和测试子集。为适配大规模语言模型(LLM)的指令微调范式,研究者将原始数据统一转换为Aya指令格式,每个样本被重构为包含任务指令与标注目标的对话模板,从而形成可直接用于多语言LLM训练的结构化语料。
特点
该数据集最显著的特征在于其多语言覆盖与指令格式的统一性。它不仅囊括了从欧洲到东南亚的12种语言,还特别包含了如宿务语(ceb)、他加禄语(tl)等低资源语种,为跨语言NER研究提供了稀缺资源。在规模上,数据集提供了超过4.5万个标注样本,其中英语EWT子集规模最大(训练集12542例),而部分语言如他加禄语仅保留测试集,体现了资源分布的不均衡性。更重要的是,所有样本均采用一致的指令模板,使得模型能够通过统一的自然语言提示学习不同语言的实体识别模式,极大提升了多任务泛化能力。
使用方法
使用该数据集时,研究者可直接通过HuggingFace Datasets库加载各语种子配置(如'en_pud'、'zh_gsd'等),并利用预设的train/dev/test划分进行模型训练与评估。由于数据已转换为指令格式,适合采用序列到序列(Seq2Seq)或因果语言模型(Causal LM)的微调范式。典型用法是将指令文本作为输入,目标实体标签序列作为输出,配合交叉熵损失函数进行优化。此外,数据集附带模板文件(./templates-uner),开发者可参考其格式自行扩展或调整指令风格,以适配不同LLM架构的输入要求。
背景与挑战
背景概述
命名实体识别(NER)作为自然语言处理领域的核心任务,其发展长期受限于高质量标注数据的匮乏,尤其是跨语言场景下的一致性标注更是学界面临的重大瓶颈。在此背景下,由Stephen Mayhew、Terra Blevins等来自多所国际机构的研究者于2023年共同创建的Universal NER v1数据集应运而生,旨在构建一个多语言、高标准的NER基准评测体系。该数据集覆盖包括中文、英语、德语、俄语在内的12种语言,依托Universal Dependencies框架进行标注,确保了跨语言间标签体系的一致性。其衍生版本universalner/uner_llm_instructions进一步将原始数据转化为指令格式,专为大型语言模型的多语言微调而设计,显著推动了多语言NER研究从传统序列标注向生成式范式的演进,对提升模型在低资源语言上的泛化能力具有里程碑意义。
当前挑战
该数据集面临的核心挑战首先在于多语言NER任务本身固有的领域难题:不同语言在实体边界界定、命名习惯及语法结构上存在显著差异,例如中文缺乏显式词边界,而菲律宾语等低资源语言标注数据稀少,导致模型难以学习鲁棒的跨语言实体表示。其次,数据集构建过程亦充满技术挑战:原始Universal NER v1来源于多个异构语料库(如PUD、EWT、GSD等),需统一标签映射与格式转换,而转化为指令格式时,需设计既能保留原始标签信息又适配生成式模型输入模板的复杂转换逻辑,避免信息丢失或语义偏离。此外,部分语言(如他加禄语)仅有测试集而无训练数据,进一步加剧了模型在零样本场景下的评估难度。
常用场景
经典使用场景
在自然语言处理领域,命名实体识别(NER)一直是信息抽取的核心任务之一。universalner/uner_llm_instructions数据集以多语种、高标注质量为特色,涵盖英语、中文、德语、俄语等十余种语言,其经典使用场景在于为大语言模型提供指令微调格式的NER训练数据。研究者可借助该数据集,将传统序列标注任务转化为指令跟随范式,从而提升模型在多语言环境下的实体边界识别与类型分类能力,尤其适用于低资源语言的泛化性能评估。
衍生相关工作
基于该数据集,学界衍生出一系列具有影响力的工作,包括多语言NER的跨任务迁移学习框架、基于对比学习的低资源语言实体表示增强方法,以及面向指令微调的NER提示模板优化策略。这些研究不仅扩展了原始数据集的适用边界,还催生了如UniversalNER等统一评测基准,进一步推动了多语言NER从实验室到工业场景的转化,成为连接传统序列标注与现代大语言模型范式的重要桥梁。
数据集最近研究
最新研究方向
在多语言命名实体识别(NER)领域,universalner/uner_llm_instructions数据集的问世,标志着将传统结构化标注数据转化为大语言模型(LLM)可理解的指令格式这一前沿方向的重大突破。该数据集基于Universal NER v1黄金标准,覆盖包括中文、德语、俄语在内的12种语言,并针对克罗地亚语、塞尔维亚语等低资源语言进行了专门标注,其多语言指令微调版本为构建跨语言泛化能力更强的NER模型提供了关键训练资源。与当前LLM研究热潮相呼应,该数据集特别适用于探索如何通过指令微调提升模型对细粒度实体边界和类型的理解,尤其是在零样本跨语言迁移场景下。这一转化工作不仅降低了多语言NER任务对大规模手工标注的依赖,更推动了通用智能体在全球化信息抽取应用中的落地,具有重要的学术价值与产业影响。
以上内容由遇见数据集搜集并总结生成


