
agnews-unlearning-mia
收藏官方服务:
资源简介:
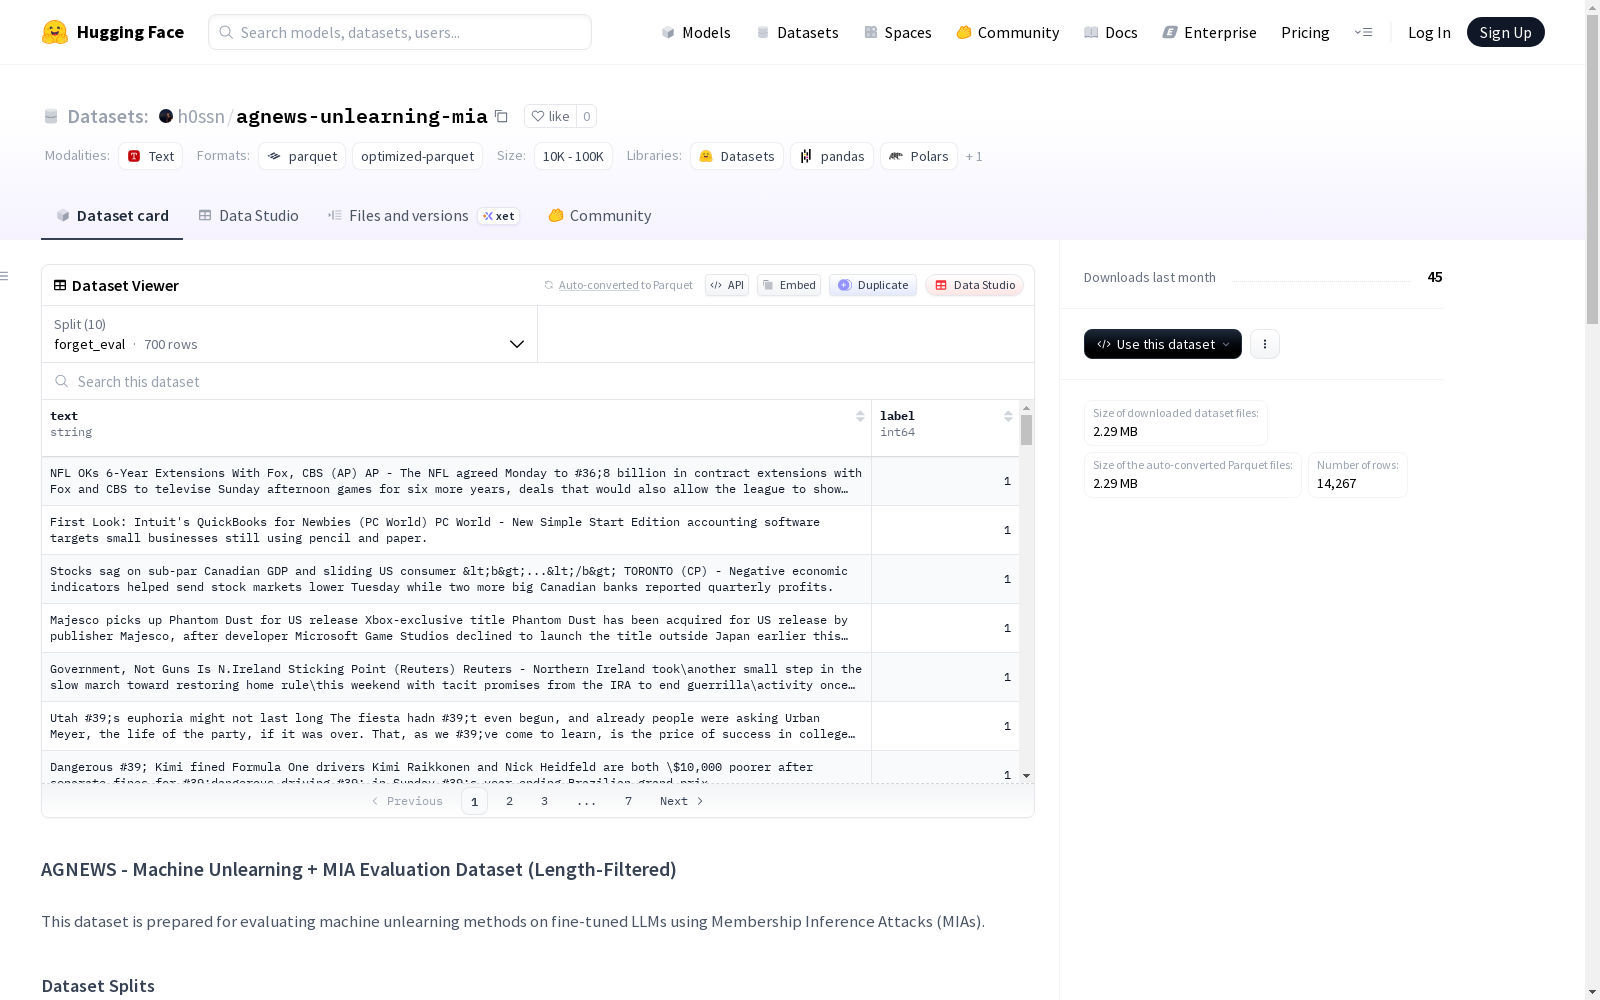
AGNEWS数据集是一个用于评估机器学习遗忘方法和成员推理攻击(MIA)效果的数据集。它包含训练集和评估集,训练集分为保留集(9000个样本)和遗忘集(1000个样本),评估集则根据文本长度(32、48、64个词符)进行过滤和分类。数据集的设计目的是用于研究遗忘方法的效果、测量成员泄漏、隐私研究以及长度控制的MIA评估。
创建时间:
2025-12-11
原始信息汇总
AGNEWS - 机器遗忘与成员推理攻击评估数据集(长度过滤版)
数据集概述
本数据集专为评估基于微调大语言模型的机器遗忘方法而设计,评估手段为成员推理攻击。数据集经过长度过滤处理,以消除序列长度对成员推理的潜在干扰。
数据集结构与特征
- 特征字段:
text: 字符串类型,表示文本内容。label: int64类型,表示类别标签。
数据子集划分
训练集(用于遗忘任务)
retain_set: 包含9,000个样本,代表在遗忘过程中需要保留的数据。forget_set: 包含1,000个样本,代表需要被遗忘的数据。
评估集(用于成员推理攻击)- 长度过滤版
评估集根据文本长度(以令牌数为准)分为三个变体,每个变体包含对应的保留集与遗忘集评估子集:
- 约32个令牌: 短标题。
- 约48个令牌: 中等长度标题。
- 约64个令牌: 长标题。
对应的评估子集名称如下:
retain_eval_32,forget_eval_32retain_eval_48,forget_eval_48retain_eval_64,forget_eval_64
评估集数据结构
每个评估数据集(最多700个样本)结构如下:
| 索引范围 | 数据来源 | 成员关系 | 标签 |
|---|---|---|---|
| 0-349 | 微调数据集的子集 | 成员 | 1 |
| 350-699 | 原始测试集划分 | 非成员 | 0 |
注意: 实际样本数量可能因符合长度标准的样本可用性而有所变化。
长度过滤方法
所有评估集划分均经过过滤,以匹配特定的令牌长度(允许±10个令牌的容差)。此长度匹配旨在防止模型使用序列长度作为成员推理的信号,该方法遵循Win-k MIA论文的方法论。
主要用途
- 机器遗忘: 训练模型以“遗忘”
forget_set,同时在retain_set上保持性能。 - 成员推理攻击评估: 使用评估子集衡量遗忘前后的成员信息泄露情况。
- 隐私研究: 研究遗忘方法在保护数据隐私方面的有效性。
- 长度受控的成员推理攻击: 在没有长度混淆因素的情况下评估成员推理攻击。
使用许可
请参考原始数据集的许可协议。
引用要求
若使用此数据集,请引用建立了长度过滤方法论的Win-k MIA论文。
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,针对机器遗忘与成员推理攻击评估的需求,agnews-unlearning-mia数据集基于AGNews新闻分类数据集构建而成。该数据集通过精细划分训练与评估子集,将原始数据分为保留集与遗忘集,分别包含9000与1000个样本,旨在模拟模型在遗忘特定数据时的行为。评估部分则依据文本长度进行过滤,生成了32、48及64词符三种长度的变体,每个评估集均包含成员与非成员样本,并严格控制长度差异以消除序列长度对成员推理的干扰,从而遵循了Win-k MIA论文中的方法学框架。
特点
该数据集的核心特点在于其针对机器遗忘与隐私评估的专门化设计。通过引入长度过滤机制,评估样本被精确匹配至特定词符范围,有效避免了模型利用序列长度作为成员推理的信号,提升了评估的严谨性。数据集结构清晰,包含保留集、遗忘集及多种长度的评估子集,支持对模型在遗忘前后的隐私泄漏进行量化分析。这种长度控制的设置不仅增强了实验的可比性,也为研究无学习方法的有效性提供了标准化的测试环境。
使用方法
使用该数据集时,研究人员可通过Hugging Face的datasets库直接加载,访问保留集与遗忘集进行模型训练与遗忘操作。评估阶段则需根据实验需求选择相应长度的评估子集,如retain_eval_32或forget_eval_64,以执行成员推理攻击并衡量隐私保护效果。数据集适用于机器遗忘算法的开发、隐私泄漏的实证研究以及长度无关的成员推理评估,为自然语言处理中的隐私安全领域提供了实用的基准工具。
背景与挑战
背景概述
在人工智能安全与隐私保护领域,机器遗忘技术旨在使已训练的模型能够有选择性地移除特定数据的影响,从而应对数据隐私法规与用户权利诉求。AGNEWS遗忘与成员推理评估数据集由研究团队于近年构建,其核心研究问题聚焦于评估大型语言模型在微调后执行机器遗忘的有效性,并通过成员推理攻击来衡量数据隐私泄露风险。该数据集基于经典的AGNews文本分类数据集,通过精心划分保留集与遗忘集,并引入长度过滤机制,为量化遗忘效果与隐私保障提供了标准化基准,对推动可信机器学习与数据治理研究具有重要影响力。
当前挑战
该数据集致力于解决机器遗忘与隐私评估中的核心挑战:在文本分类任务中,如何确保模型在遗忘特定数据后,不仅能维持对保留数据的性能,还能有效抵御成员推理攻击,从而验证数据隐私的实际保护水平。构建过程中的主要挑战包括,需设计严谨的数据划分策略以平衡保留集与遗忘集的代表性,避免评估偏差;同时,实施精确的长度过滤以消除序列长度对成员推理的潜在干扰,这要求对文本进行严格的令牌长度匹配与质量控制,确保评估结果仅反映模型记忆特性而非长度线索。
常用场景
经典使用场景
在机器遗忘与隐私保护研究领域,AGNEWS遗忘与成员推理评估数据集为评估大型语言模型中的遗忘机制提供了标准化基准。该数据集通过精心划分的保留集与遗忘集,模拟了模型在移除特定敏感数据时的学习与遗忘过程。研究者利用其长度过滤的评估子集,能够精确衡量模型在遗忘前后对成员信息的泄露程度,从而系统检验不同遗忘算法的有效性。这一场景为探索模型在动态数据环境下的适应性调整奠定了实验基础。
解决学术问题
该数据集主要针对机器遗忘研究中成员推理攻击评估的标准化难题。传统评估常受序列长度等混杂因素干扰,导致隐私泄露度量存在偏差。通过引入严格长度匹配的评估样本,该数据集消除了长度作为成员推理信号的可能性,确保了评估结果的纯净性与可比性。这为量化遗忘方法在保护训练数据隐私方面的真实效能提供了可靠依据,推动了机器遗忘理论向严谨、可复现的实证研究方向发展。
衍生相关工作
围绕该数据集衍生的经典工作,主要集中于机器遗忘算法与隐私评估方法的创新。例如,基于Win-k MIA论文建立的长度过滤方法论,催生了一系列针对文本模型的细粒度成员推理攻击研究。后续工作在此基础上,进一步探索了不同模型架构、遗忘策略与攻击场景下的隐私-效用权衡,推动了如选择性遗忘、认证遗忘等前沿方向的发展,并促进了机器遗忘领域标准化评估框架的逐步形成。
以上内容由遇见数据集搜集并总结生成


