遇见数据集

verified-defi-datasets

收藏
Hugging Face2026-08-24 更新2026-08-25 收录
官方服务:

资源简介:

该数据集是一个高密度、经过验证的AI微调语料库,采用ALPACA格式,专门针对Solana Sealevel和Anchor程序优化领域。数据集包含3条经过验证的记录,估计总token数为339,质量QA评分高达99.0%。适用于文本生成任务,可用于微调大语言模型以理解或生成与Solana区块链上Sealevel运行时和Anchor框架相关的优化代码或策略。数据集规模较小,但经过严格验证,适合作为高质量示例集。

This dataset is a high-density, verified AI fine-tuning corpus in ALPACA format, specifically targeting the field of Solana Sealevel and Anchor program optimization. It contains 3 verified records with an estimated total token count of 339 and a quality QA score of 99.0%. Suitable for text generation tasks, it can be used to fine-tune large language models to understand or generate optimization codes or strategies related to the Sealevel runtime and Anchor framework on the Solana blockchain. The dataset is small in scale but rigorously verified, making it suitable as a high-quality example set.

创建时间:
2026-08-23
原始信息汇总

数据集概述:Verified Solana Sealevel & Anchor Program Optimization Fine-Tuning Corpus

基本信息

  • 许可证: MIT
  • 任务类型: 文本生成(text-generation)
  • 语言: 英语(en)
  • 数据规模: 1K<n<10K 条记录

数据内容

  • 领域: Solana Sealevel 与 Anchor 程序优化
  • 格式: ALPACA 格式,适用于 AI 微调训练
  • 数据规模: 已验证记录 3 条
  • 预估 Token 数: 339

质量与分发

  • 质量 QA 评分: 99.0%
  • 商业化状态: 直接零 Gas Web3 与 HuggingFace 分发

搜集汇总
数据集介绍
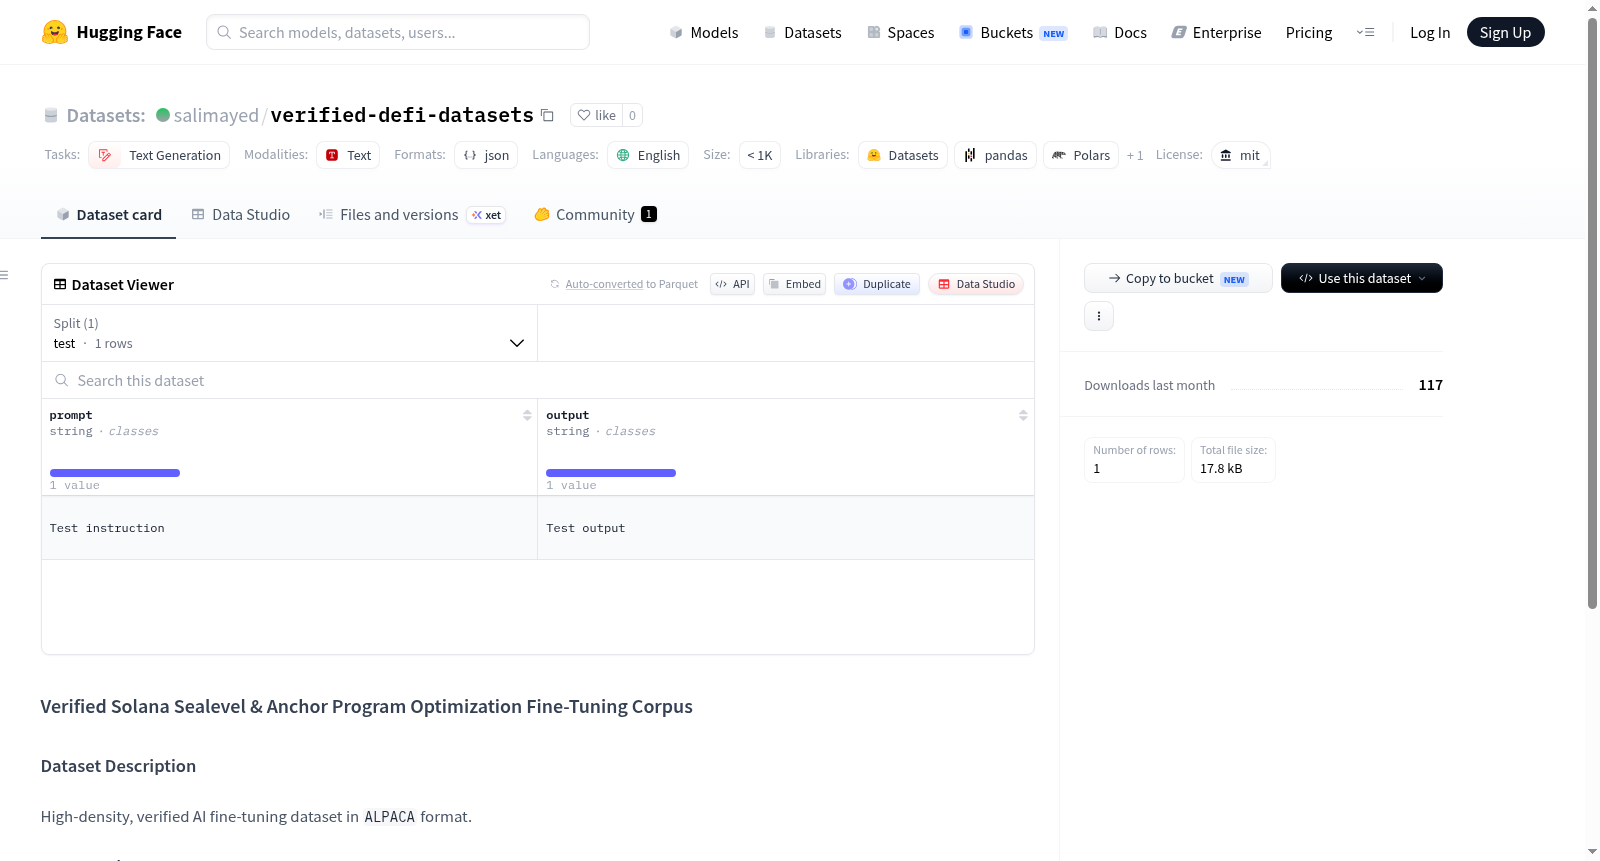
verified-defi-datasets 数据集图片
构建方式
该数据集以Solana Sealevel与Anchor程序优化为核心领域,精心构建了高密度的AI微调语料。其构建过程遵循严格的验证流程,确保每条记录均通过质量审查,并以ALPACA格式呈现,便于直接用于指令微调。数据集包含3条已验证记录,估算总token数为339,且质量QA评分高达99.0%,体现了高度的精准性与可靠性。
特点
该数据集具有高密度、已验证的显著特点,专注于Solana生态系统的程序优化,涵盖Sealevel与Anchor框架。其ALPACA格式兼容主流微调框架,便于开发者直接集成。此外,数据集的零Gas Web3分发模式与HuggingFace平台相结合,实现了高效、透明的获取途径,同时其精炼的规模(1K-10K)确保了训练效率与专注度。
使用方法
使用时,开发者可将此数据集直接用于文本生成任务,特别是针对Solana程序优化的指令微调。数据集以ALPACA格式组织,可直接适配各类基于transformers的微调库,如HuggingFace的Trainer。建议将数据划分为训练集与验证集,并结合领域特定评估指标进行迭代优化。由于规模较小,适合作为基础语料或与其它数据集融合使用,以增强模型在Solana生态中的性能。
背景与挑战
背景概述
该数据集由Web3与人工智能交叉领域的研究者于近期创建,旨在应对Solana区块链生态系统中Sealevel运行时与Anchor框架程序优化的迫切需求。聚焦于提供高质量、已验证的微调语料,以ALPACA格式呈现,包含3条精选记录,覆盖零Gas费Web3应用与HuggingFace分发场景。其核心研究问题在于通过精炼的指令数据增强大型语言模型对Solana智能合约优化的理解与生成能力,填补了该垂直领域公开数据集的空白,对推动去中心化金融与AI融合的创新具有潜在影响力。
当前挑战
该数据集面临的核心挑战可归纳为两方面:其一,Solana Sealevel与Anchor框架的程序优化属于高度专业化领域,涉及并行执行、账户安全及资源效率等复杂概念,开源样本稀少且质量参差不齐,难以支撑鲁棒的模型训练;其二,构建过程中受限于极小的验证规模(仅3条记录、约339个token),尽管QA评分高达99.0%,却面临数据稀疏性、泛化能力不足及潜在过拟合风险,如何在维持高验证标准的同时扩充覆盖范围,成为制约其应用深度的关键瓶颈。
常用场景
经典使用场景
该数据集作为专精于Solana Sealevel与Anchor程序优化的精细调优语料库,主要服务于区块链智能合约开发领域的大语言模型微调工作。其以ALPACA格式组织的高密度数据记录,为研究者提供了构建专业级代码生成与优化模型的基础训练资源,适用于提升模型在Solana生态合约编写、Gas优化及安全审计等任务上的表现。
解决学术问题
该数据集直面区块链智能合约开发中专业语料匮乏的学术困境,填补了Solana特定框架指令集与账户模型知识的结构性空白。它助力解决大语言模型在Web3领域泛化能力不足的问题,为量化合约代码生成质量、Gas效率及安全属性提供了标准化测试基准,推动了区块链与人工智能交叉学科在应用层验证方法论的演进。
衍生相关工作
围绕该数据集衍生的工作涵盖高性能RLHF(从人类反馈中强化学习)优化流程、领域自适应继续预训练策略以及跨链代码转译模型。后续研究常引用其记录作为衡量Solana专项模型性能的微观基准,部分工作扩展至多合约范式对比分析,以及生成合约的形式化验证研究,共同织就了区块链智能开发智能体的基础脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务