
遇见数据集

corpus-legislation-nz-historical

收藏
Hugging Face2026-06-11 更新2026-06-12 收录
官方服务:

资源简介:

New Zealand Legislation Historical Corpus 是一个专门用于存储新西兰立法历史记录的数据集。该数据集通过官方的新西兰立法API收集,旨在作为立法记录的历史发布目标,与实时的、部分基于API发现的数据集相区分。数据集内容为新西兰的法律法规历史语料,采用parquet格式存储,主要语言为英语。它适用于法律文本分析、历史立法研究、自然语言处理中的法律领域任务等场景。需要注意的是,历史数据的上传必须指向此数据集,且不能覆盖实时数据集。目前,数据集的完整覆盖范围在相关引导计划、失败版本状态、清单和覆盖报告被审查之前尚未得到最终确认。

The New Zealand Legislation Historical Corpus is a dataset specifically designed to store historical records of New Zealand legislation. It is collected through the official New Zealand Legislation API and serves as a historical release target for legislative records, distinguishing it from real-time datasets partially based on API discovery. The dataset contains historical corpora of New Zealand laws and regulations, stored in parquet format, with English as the primary language. It is suitable for scenarios such as legal text analysis, historical legislative research, and natural language processing tasks in the legal domain. It is important to note that historical data uploads must point to this dataset and cannot overwrite real-time datasets. Currently, the full coverage of the dataset has not been finalized until relevant pilot programs, failed version statuses, inventories, and coverage reports are reviewed.

创建时间:
2026-06-09
原始信息汇总

数据集名称

New Zealand Legislation Historical Corpus

语言

英语 (en)

标签

  • 新西兰 (new-zealand)
  • 立法 (legislation)
  • 法律 (law)
  • 法律语料库 (legal-corpus)
  • 历史 (historical)
  • Parquet 格式 (parquet)

数据集描述

该数据集包含通过新西兰官方立法API收集的历史立法记录,是独立的历史发布目标。

数据来源

  • 官方新西兰立法API

与相关数据集的区别

  • 区别于实时/部分API发现数据集 edithatogo/corpus-legislation-nz
  • 历史数据上传必须定向至 edithatogo/corpus-legislation-nz-historical,不得覆盖实时数据集

覆盖范围说明

覆盖范围尚未被证明完整,需待历史引导计划、失败版本状态、清单及覆盖报告审核后确认。
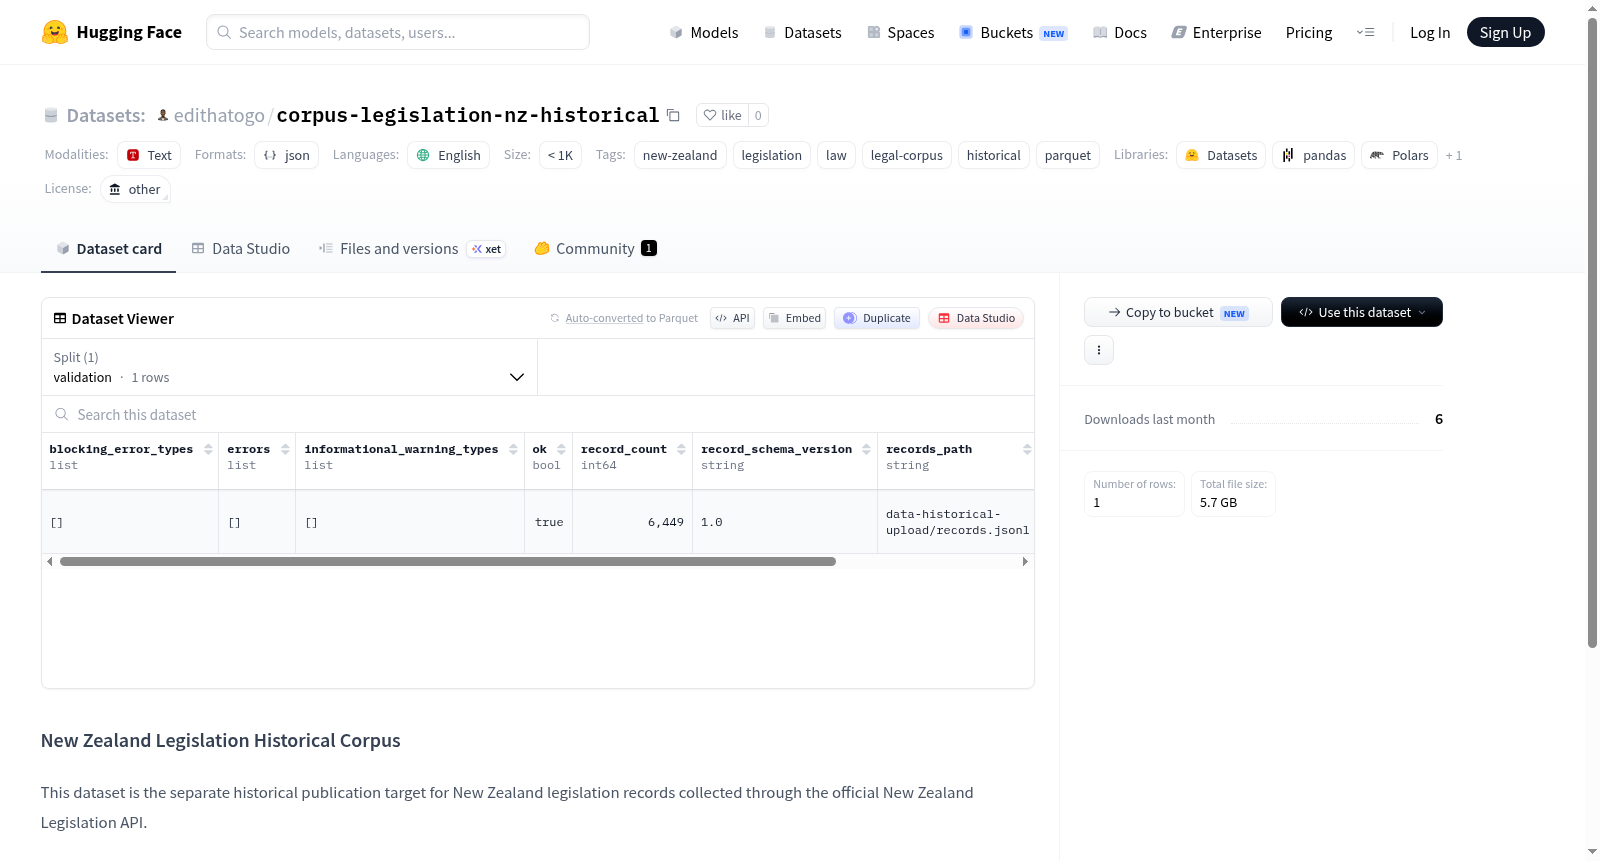
搜集汇总
数据集介绍
corpus-legislation-nz-historical 数据集图片
构建方式
该数据集通过官方新西兰立法API采集历史立法记录,并独立存储于`edithatogo/corpus-legislation-nz-historical`仓库中,与实时更新的数据集`edithatogo/corpus-legislation-nz`相区分。构建时规定历史上传必须定向至此仓库,并严格避免覆盖实时数据。数据格式采用Parquet格式存储,确保高效读写与压缩。
使用方法
用户可通过HuggingFace平台直接加载该数据集,利用Parquet格式的高效性进行数据读取。使用时需注意数据集版本标识,避免与实时数据集混淆。建议结合官方提供的覆盖率报告、清单及回滚计划,以验证历史数据的完备性。适用于训练法律文本理解模型、对比不同时期立法语言变化等场景。
背景与挑战
背景概述
新西兰立法历史语料库(New Zealand Legislation Historical Corpus)诞生于对法律文本数字化与历史版本追溯的迫切需求,由研究人员或机构基于新西兰官方立法API系统收集构建,旨在系统性地整合与保存该国历史上分散的立法记录。该数据集聚焦于法律文献的时序演变,为法学、计算语言学及政策分析等领域提供了宝贵的研究资源,通过记录不同时期的法律条文变化,推动了立法文本的深度分析与历史对比研究。其影响力体现在为自动化法律检索、历史法律变迁挖掘及新西兰法律体系的数字化遗产保护奠定了数据基础,成为相关领域学者与从业者探索法律进化的关键工具。
当前挑战
该数据集面临的核心挑战在于所解决的领域问题——法律文本的精确历史版本管理与补全。由于立法修订频繁且历史记录零散,确保从官方API中采集的数据覆盖完整、无遗漏是主要难题,尤其是早期法律文件的版本状态、失效条款及修订时间线的确认。构建过程中,需应对历史数据与实时数据集的严格隔离,避免版本覆盖导致信息丢失,同时依赖于全面的回溯计划、失败版本状态清单及覆盖率报告的审核,以验证语料库的完备性。这要求处理元数据映射的复杂性与数据质量的持续监控,从而为用户提供可信赖的立法历史档案。
常用场景
经典使用场景
在自然语言处理与法律信息学交叉领域,该数据集被广泛应用于训练和评估面向历史法律文本的语言模型。研究人员常借此构建能够处理法律条文历时变动的模型,以捕捉法律语言在语法、术语和结构上的演化规律,从而提升对旧版法规的自动解析与理解能力。
解决学术问题
该数据集着力解决了历史法律文本数字化程度低、版本混杂所带来的学术研究困境。通过提供独立且可追溯的历史立法语料,它使学者能够系统性地分析法律条文的修订轨迹与语义漂移,进而推动法律演化计量学、法律语言历时分析等前沿议题的实证研究,为法律史与计算语言学交叉领域奠定了坚实的数据基础。
实际应用
在实际应用中,该数据集为新西兰法律相关的智能系统开发提供了关键支撑。法律从业人员可借助基于该语料训练的工具进行历史法条检索与版本比对,使其在案件溯源、法规沿革分析等场景中显著提升工作效率。同时,政府立法机构也可利用其对法律法规进行数据化存档与历史版本追溯,辅助立法质量的评估与优化。
数据集最近研究
最新研究方向
该数据集聚焦于新西兰历史法律文献的数字化整合与版本追溯,为法律文本分析、历史立法变迁研究及法规版本控制提供了前所未有的结构化资源。其独立于实时数据的分发策略,确保了历史档案的完整性与可复现性,助力前沿领域如法律知识图谱构建、跨时空法规效力推理及立法趋势预测。结合新西兰近年数字政府与开放数据运动,该语料库的完善将深刻推进法律信息化研究,并为英联邦法系国家的历史法规比较分析奠定基础,具有显著的学术与应用价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

