
electricsheepasia/asia-who-adolescent-mortality-rate-mort10to19
收藏数据链接:
官方服务:
资源简介:
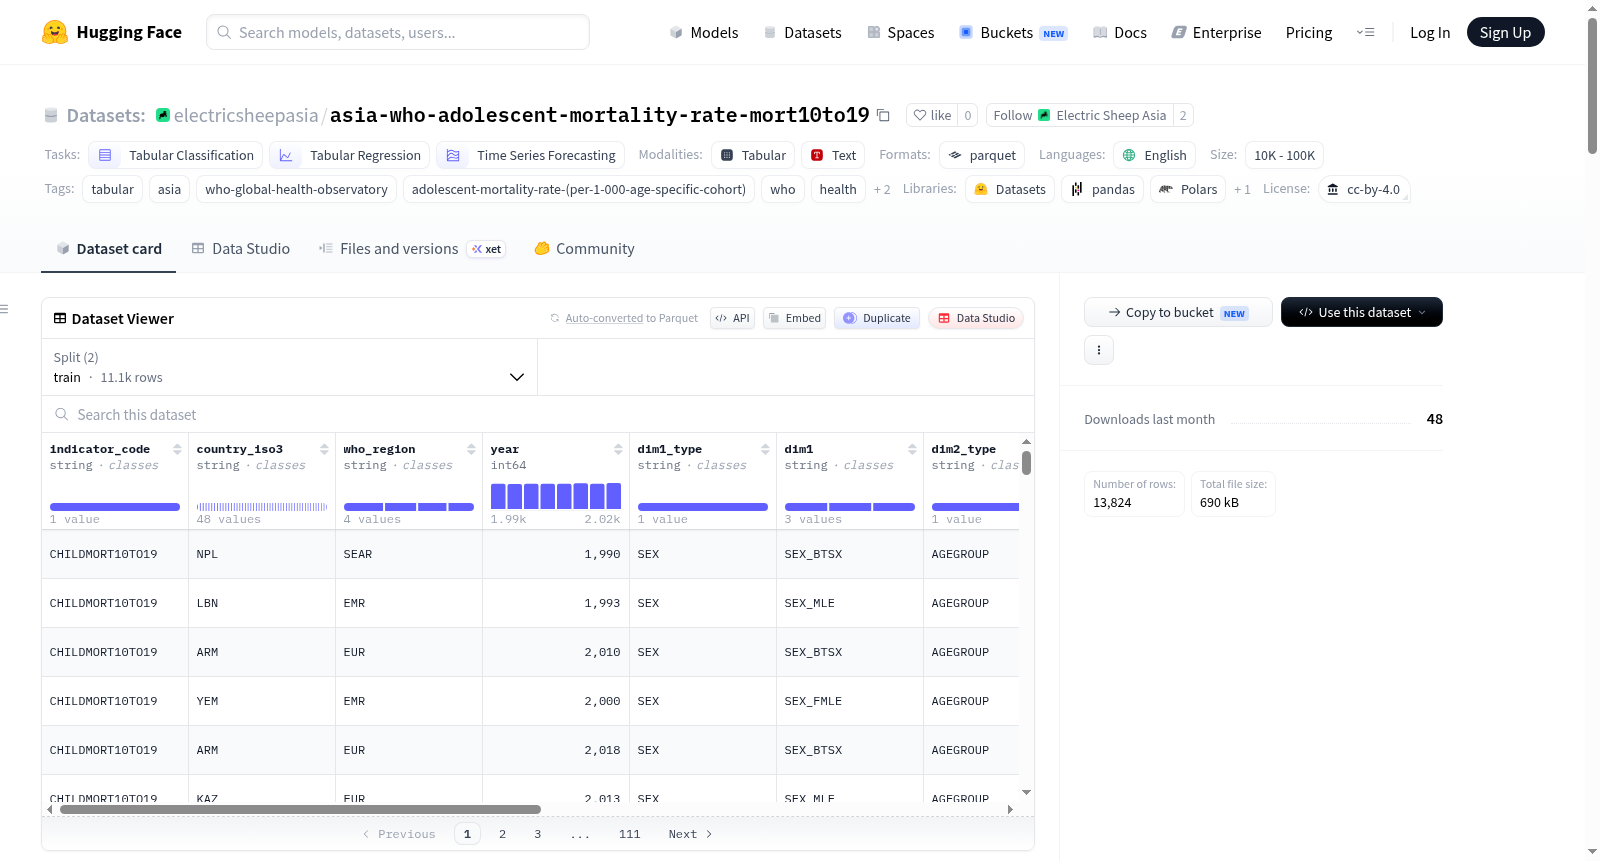
该数据集包含亚洲48个国家从1990年至2021年的青少年死亡率数据(每1000名特定年龄队列),共有13,824个观测值,涵盖1个独立指标。数据来源于世界卫生组织全球健康观察站,包括指标代码、国家ISO3代码、年份、性别和年龄组等维度,以及数值、低值和高值等字段。数据集适用于表格分类、回归和时间序列预测任务。
This dataset contains 13,824 observations of Adolescent mortality rate (per 1,000 age-specific cohort) data across 48 Asia countries, spanning 1990–2021, covering 1 distinct indicator. It includes data from the WHO Global Health Observatory with fields such as indicator_code, country_iso3, year, sex and age group dimensions, and numeric values with low and high estimates. The dataset is suitable for tabular classification, regression, and time-series forecasting tasks.
提供机构:
electricsheepasia搜集汇总
数据集介绍
构建方式
该数据集源自世界卫生组织全球健康观测站,由Electric Sheep Asia团队重新整理并封装为适于机器学习使用的格式。原始数据覆盖1990年至2021年间48个亚洲国家与地区的青少年死亡率统计,观测总量达13,824条。构建过程中,团队对源数据进行了模式规范化处理,统一了列名与数据类型,并以Parquet格式存储,确保数据在加载后即可直接用于分析或建模。数据集包含指示代码、国家ISO3代码、年份、性别与年龄组等维度的分解信息,提供了从总体到细分的多层次视角。
特点
本数据集的核心特点在于其时间跨度长、地理覆盖广且维度丰富。时间序列跨越31年,涵盖亚洲全部48个国家和地区,能够支持纵向趋势分析与跨国比较研究。数据按性别(两性、女性、男性)与年龄组(10-14岁、10-19岁、15-19岁)进行分解,提供了微观层面的统计视角。每个观测值除了数值本身,还附带置信下限与上限,有助于评估死亡率估计的不确定性。所有数据采用CC-BY 4.0许可协议,便于学术研究与公共政策分析。
使用方法
数据集可以通过HuggingFace的datasets库便捷加载,仅需调用load_dataset函数即可获得Pandas DataFrame格式的完整数据。用户可依据国家ISO3代码筛选特定国家的数据,也可通过指示代码过滤出青少年死亡率指标并进行时间序列绘图。数据集支持以年份为行、国家为列建立透视矩阵,便于进行面板数据分析或构建预测模型。对于需要进一步处理的任务,DataFrame结构清晰,可直接应用于分类、回归或时间序列预测等机器学习场景。
背景与挑战
背景概述
青春期是生命历程中健康风险与行为模式形成的关键窗口期,青少年死亡率(10至19岁)不仅是衡量国家卫生系统效能的核心指标,更是联合国可持续发展目标(SDG 3)中关于减少可预防死亡的重要监测对象。世界卫生组织(WHO)全球卫生观察站(GHO)自1990年起系统收集全球健康数据,由Electric Sheep Asia于2021年重新整理并发布的该数据集,聚焦亚洲48个国家长达32年的纵向观测,包含13,824条记录,覆盖不同性别与年龄段的细分维度。该数据集为流行病学、公共卫生政策及人口健康研究提供了标准化的跨国产出基线,尤其为亚洲地区青少年健康不平等分析及干预策略评估奠定了数据基石,成为连接宏观卫生决策与微观个体健康轨迹的桥梁。
当前挑战
该数据集面临的核心挑战在于其解决的领域问题:如何精准捕捉并解释亚洲内部显著的社会经济、文化及地理异质性对青少年死亡率的影响,从而超越简单的区域均值比较。具体而言,构建过程中的挑战包括:其一,多来源行政登记系统质量参差,部分国家(如阿富汗、伊拉克)因冲突或统计能力薄弱导致数据缺失或估算偏差,需借助WHO标准化模型进行插补,但引入了不确定性衡量(如`value_low`与`value_high`列)。其二,时间序列横跨1990至2021年,期间疾病谱系变迁(如艾滋病、交通事故与心理疾病的兴起)与医疗技术革新要求指标定义保持一致性,然而年龄分组(10-14岁与15-19岁)的细分虽增强了粒度,却增加了跨时期可比性的协调难度。其三,数据按性别与年龄组多维交叉标识,虽然提升了分析弹性,但也大幅增加了缺失模式的处理复杂性,需要研究者具备处理高维稀疏数据的统计能力。
常用场景
经典使用场景
在亚太地区青少年健康研究领域,该数据集凭借其覆盖48个亚洲国家、跨越1990至2021年的时序列观测,成为分析青少年死亡率趋势与区域差异的经典资源。研究者可借助其精细的人口统计维度(如性别、年龄组别10-14岁与15-19岁)构建多层级时间序列模型,揭示不同社会经济发展阶段下青少年死亡率的演变规律。数据集同时支持表格分类、回归及时间序列预测等任务,为探索气候变迁、公共卫生政策等外部因素对青少年生存状况的影响提供了标准化数据基底。
衍生相关工作
该数据集衍生了一系列具有影响力的学术工作,包括基于贝叶斯层次模型的亚洲青少年死亡率估计研究,以及结合社会经济发展指标(如教育水平、医疗可及性)的多变量回归分析。部分工作利用其性别与年龄亚组数据,探讨了青少年死亡率中的性别不平等现象及其与早婚、童工等社会议题的关联。此外,该数据集还作为基准测试集,用于验证时序预测算法(如Prophet、LSTM)在低资源环境下的泛化能力,推动了AI与全球健康交叉领域的方法论创新。
数据集最近研究
最新研究方向
当下,基于WHO全球卫生观察站的数据,该数据集支持亚洲地区青少年死亡率(10-19岁年龄组)的前沿时空流行病学分析。其涵盖1990年至2021年跨度、横跨48个亚洲国家的长时序面板数据,且按性别、年龄组进行细致分层,为探索青少年健康转型、评估公共卫生干预政策效果,以及关联区域冲突、气候变化、新冠疫情等热点事件对该脆弱群体生存概率的冲击效应,提供了弥足珍贵的量化基础。研究者可借此构建预测模型,揭示死亡率的长期演变趋势与空间异质性,从而为亚洲各国精准制定降低青少年过早死亡率的可持续发展目标战略,注入强大的数据驱动动力。
以上内容由遇见数据集搜集并总结生成


