
awesome-legaltech
收藏官方服务:
资源简介:
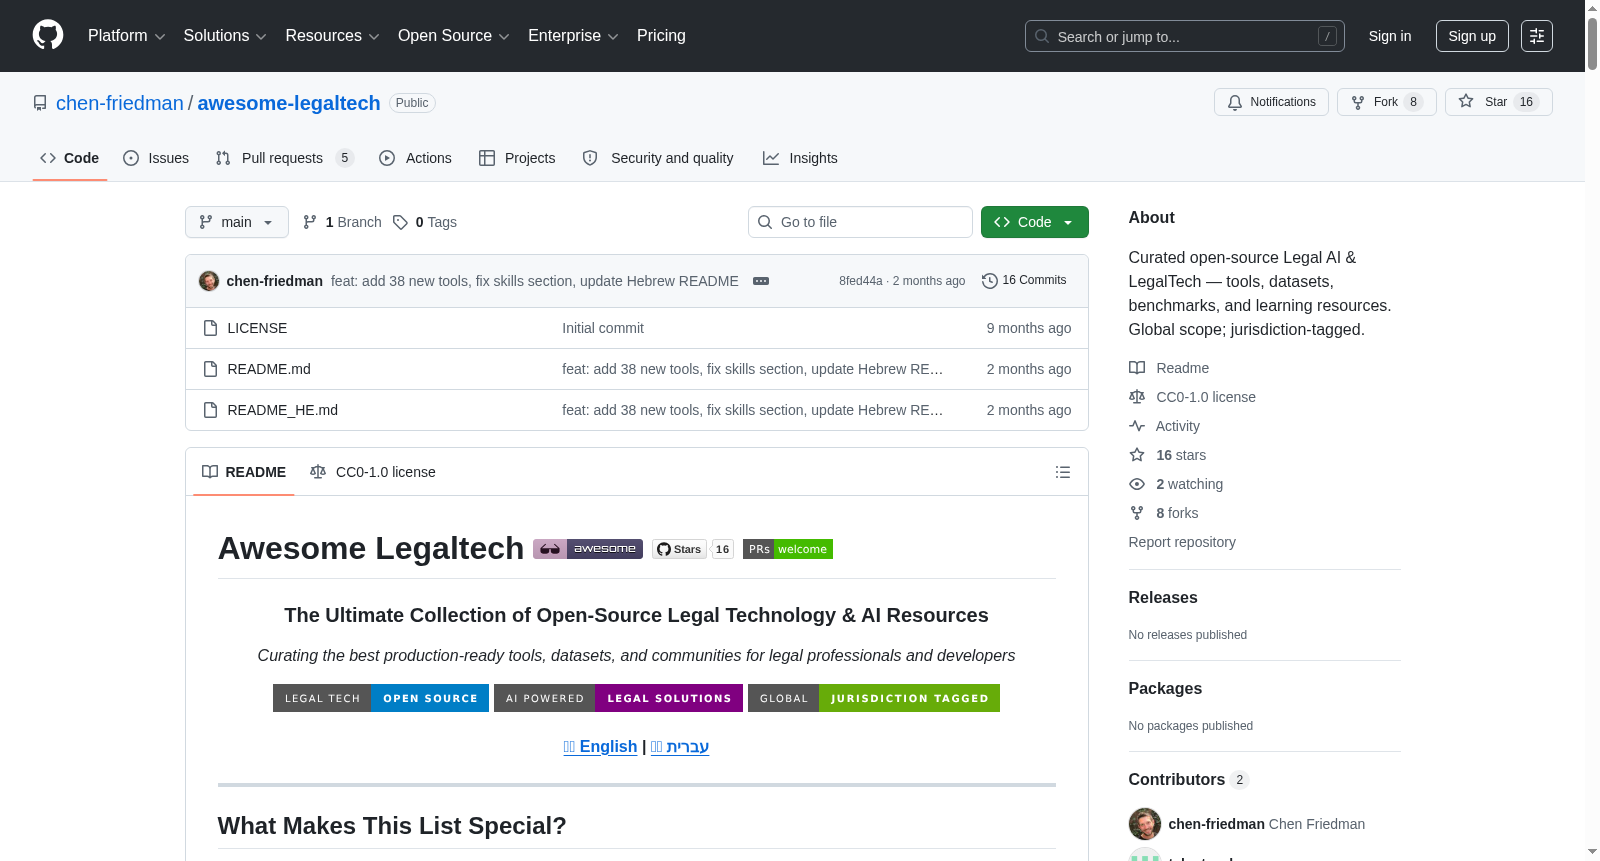
这是一个精心策划的开源法律科技和人工智能资源集合,涵盖工具、数据集、基准和学习资源。合集主题为法律科技,覆盖领域包括法律人工智能、合同分析、法律研究、电子发现、语音识别、文档管理等,资源按类别组织并标注全球司法管辖区。
This is a curated open-source collection of legal technology and artificial intelligence resources, encompassing tools, datasets, benchmarks, and learning materials. Focused on legal tech, the collection covers areas including artificial intelligence in law, contract analysis, legal research, e-discovery, speech recognition, document management, and more. All resources are organized by category and annotated with global jurisdictions.
创建时间:
2025-09-09
原始信息汇总
数据集概述:Awesome Legaltech
网站地址: https://github.com/chen-friedman/awesome-legaltech
总体介绍
这是一个精心策划的开源法律科技与人工智能资源合集,收录了 120+ 高质量的开源法律科技资源。该合集专注于生产就绪、积极维护且具有实际应用场景的项目,覆盖全球多个司法管辖区,并标注了适用地域(如🇺🇸、🇪🇺、🇬🇧、🇩🇪、🇮🇳、🇮🇱、🌍)。
核心特色
- 严格的质量标准 — 仅收录生产就绪、积极维护且具有实际部署的项目
- 全球法律覆盖 — 全球范围,带有清晰的司法管辖区标签
- 从业者验证工具 — 法律专业人士在实际工作流程中使用的真实解决方案
- 优质 AI 资源 — 专为法律应用策划的数据集、基准测试和模型
- 活跃生态系统 — 推动创新和协作开发的活跃社区
内容分类与统计
| 类别 | 项目数 | 主要用途 |
|---|---|---|
| NLP 库与领域模型 | 10 | 文本处理与分析 |
| 人工智能合同与文档分析 | 5 | 合同智能 |
| RAG 与 AI 基础设施 | 8 | 构建法律 AI 应用 |
| 智能代理与自动化 | 5 | AI 代理与工作流自动化 |
| 法律研究与判例数据/API | 9 | 研究与引用 |
| 电子取证与诉讼 | 6 | 法律发现与标注 |
| 语音识别与转录 | 10 | 音视频转录 |
| 文档签署与协作 | 5 | 数字签名与维基 |
| 文档管理、OCR 与 PDF | 14 | 文档处理 |
| 文档组装与规则即代码 | 7 | 自动化与工作流 |
| 知识管理 | 5 | 研究笔记与个人知识管理 |
| AI 代理技能(法律工作) | 14 | 法律 AI 自动化 |
| 数据集与基准测试 | 10 | 训练与评估 |
| 通用文档智能(法律适用) | 6 | 文档理解 |
| 学习、社区与精选资源 | 6 | 教育与社交 |
主要代表性资源
NLP 库与领域模型
- Hugging Face Transformers(全球)- 通用微调与运行法律文本 Transformer 模型工具包,159k Stars,Apache-2.0 许可
- spaCy(全球)- 工业级 NLP,33k Stars,MIT 许可
- LexNLP(全球)- 从非结构化法律文本中进行信息提取
- LEGAL-BERT(欧盟/全球)- 面向法律语料库的预训练 BERT 变体
- InLegalBERT(印度)- 印度法律语料库 BERT 模型
- CaseHOLD(全球)- 判例法裁决分析任务与基线
人工智能合同与文档分析
- OpenContracts - 企业级文档分析平台,适合大型组织
- ContraxSuite - 完整合同分析与文档平台,适合商业使用
- LawGlance - 免费开源 RAG 法律 AI 助手,适合中小企业与个人
RAG 与 AI 基础设施
- Ollama(MIT)- 本地运行大语言模型,168k Stars
- LangChain(MIT)- 构建 LLM 应用和 RAG 管道,133k Stars
- LlamaIndex(MIT)- 文档 LLM 应用数据框架,48k Stars
- Qdrant(Apache-2.0)- 高性能向量数据库,30k Stars
法律研究与判例数据/API
- CourtListener(美国)- 主要法律数据与研究平台,提供 API
- Caselaw Access Project(美国)- 670万+ 美国法院判决,提供 API
- UK National Archives(英国)- 英国法院判决公共 API
- EUR-Lex SPARQL(欧盟)- 欧盟法律 SPARQL 查询 API
- Open Legal Data(德国)- 德国法律数据平台与 API
数据集与基准测试
- 共收录 10 个数据集与基准测试集合,用于模型训练与评估(具体详情需进一步查看页面)。
快速入门指南
面向法律专业人士
- 从人工智能合同与文档分析部分开始,用于文档审阅
- 使用法律研究与判例 API 进行案例发现
- 利用文档管理与 OCR 实现数字化
面向开发者
- 从NLP 库与模型入手,进行文本处理
- 使用数据集与基准测试进行模型开发
- 借助RAG 与 AI 基础设施构建 AI 管道
面向组织
- 企业解决方案:OpenContracts 用于合同分析
- 文档工作流:docassemble 用于自动化
- 案件管理:CourtListener 用于法律数据
补充说明
- 每个项目都标注了 GitHub Stars 数量(如适用)和开源许可证类型
- 部分项目带有成熟度标签(企业级、生产级、社区级、稳定版、研究级)
- 项目按地域范围标记,部分专注于单一司法管辖区(如美国、英国、欧盟、德国、以色列、印度)
搜集汇总
数据集介绍
构建方式
该数据集以精选列表的形式构建,汇聚了全球范围内经过严格质量筛选的开源法律技术与人工智能资源。其构建过程基于一套明确的标准,仅收录那些达到生产就绪状态、得到积极维护并在实际工作流中经过法律从业者验证的项目。列表按功能领域划分为十五个核心类别,涵盖自然语言处理库、合同分析平台、检索增强生成基础设施、法律研究数据接口、电子取证工具、语音识别引擎、文档签名协作系统、文档管理与光学字符识别方案、文档组装与规则编码平台、知识管理工具、人工智能代理技能、训练数据集与基准测试、通用文档智能工具以及学习社区与资源策展。每个类别下的项目均标注其适用范围、司法管辖区、技术成熟度及开源许可协议,便于用户按需检索。
特点
该数据集最显著的特点在于其严格的品控与全球化的视野。所有收录项目均经过生产环境检验,排除了实验性或已停更的资源,确保用户获取的是可直接部署的解决方案。数据集采用清晰的司法管辖区标签系统,覆盖美国、欧盟、英国、德国、印度、以色列等主要法域,并包含全球通用资源,方便用户根据法律体系差异进行筛选。此外,列表特别强调人工智能资源的精选,收录了专为法律应用设计的预训练模型、语义搜索嵌入、法律文本基准测试以及高质量训练语料库,为开发法律人工智能应用提供了坚实的底层支撑。活跃的社区生态与跨领域的资源整合,使其成为连接法律实务与前沿技术的桥梁。
使用方法
使用者可根据自身角色与需求,通过数据集内嵌的快速入门指南高效定位资源。法律从业者可从合同分析平台入手进行文档审阅,借助法律研究接口发现判例,并利用文档管理工具实现数字化。开发者则建议从自然语言处理库开始构建文本处理管道,以训练数据集和基准测试为模型开发基础,再结合检索增强生成框架搭建人工智能应用。组织级用户可直接选用企业级平台如OpenContracts进行合同分析,通过docassemble实现文档工作流自动化,并借助CourtListener获取法律数据。每个项目均附有指向其GitHub仓库的链接、星标数及许可证信息,便于进一步评估与集成。
背景与挑战
背景概述
在法律科技领域,随着人工智能技术的迅猛发展,开源资源已成为推动司法智能化与法律服务普惠化的关键力量。该数据集由Chen Friedman等人于近年创建,旨在系统性收录全球范围内经过严格筛选的生产级法律科技开源工具、数据集及社区资源。其核心研究问题在于弥合法律从业者与开发者之间的鸿沟,通过提供一份涵盖自然语言处理、合同分析、法律检索、电子取证等120余项高质量资源的索引,降低法律人工智能应用的门槛。该数据集凭借其全球司法管辖区标注、实践者验证的筛选标准以及对AI基础设施的侧重,迅速成为法律科技领域的重要参考,对促进跨学科协作与技术创新产生了显著影响。
当前挑战
该数据集所面对的挑战首先体现在法律领域问题的复杂性上:法律文本具有高度的领域特异性、结构多样性与语义模糊性,且不同司法管辖区的术语与规则差异巨大,使得通用自然语言处理模型难以直接适配。构建过程中,挑战集中于资源筛选标准的制定与维护,需在保证工具的生产就绪性与实际采纳度的同时,兼顾全球司法管辖区的覆盖,避免偏见与遗漏。此外,法律科技领域迭代迅速,确保数据集内容的时效性、避免过时工具的收录,以及应对新兴技术如检索增强生成与智能体自动化的整合,均构成了持续性的维护难题。
常用场景
经典使用场景
在法律科技领域,Awesome Legaltech数据集作为一个精心策划的资源聚合库,最经典的使用场景是为研究人员和开发者提供一站式入口,快速定位高质量的开源工具与数据集。它涵盖了从自然语言处理库(如LEGAL-BERT、LexNLP)到合同分析平台(如OpenContracts、ContraxSuite)的完整技术栈,尤其适用于构建法律文本挖掘、案例检索和文档自动化系统。通过其严格的筛选标准和全球司法管辖区标签,用户能够高效地评估并集成生产级解决方案,从而加速法律AI应用的研发与部署。
衍生相关工作
基于Awesome Legaltech数据集,社区衍生了一系列具有影响力的工作。例如,围绕其收录的LEGAL-BERT和InLegalBERT,研究者开发了针对特定司法体系(如印度法)的微调模型,推动了多语言法律AI的进展。开源项目如LawGlance直接借鉴了其RAG基础设施分类,构建了面向中小型律所的免费法律助手。此外,该数据集激励了诸如Catala语言在规则编码领域的应用拓展,以及通过AssemblyLine项目将法院流程自动化推广至公共法律服务中。这些衍生工作共同构建了一个活跃的创新生态,持续反哺法律科技领域的知识共享与技术迭代。
数据集最近研究
最新研究方向
在法律科技领域,前沿研究正聚焦于构建面向法律场景的检索增强生成(RAG)与智能代理自动化体系。随着大语言模型在机密文档处理中的局限性日益凸显,本地化部署的推理基础设施(如Ollama)与向量数据库(如Qdrant、Chroma)的结合,成为保障数据安全与语义检索精度的关键路径。同时,多智能体框架(如AutoGen、CrewAI)的兴起,推动法律工作流从简单的文档分析向自主化、协作化的Agent系统演进,能够模拟律师团队的分工模式,完成从案情摘要生成到法规条文匹配的复杂任务。这一方向不仅回应了法律行业对效率与准确性的双重诉求,更通过开源生态降低了技术门槛,使得中小型律所也能借助社区资源实现智能化转型,其影响深远——它正在重塑法律服务的交付范式,让“法律即代码”从理念走向规模化实践。
以上内容由遇见数据集搜集并总结生成


