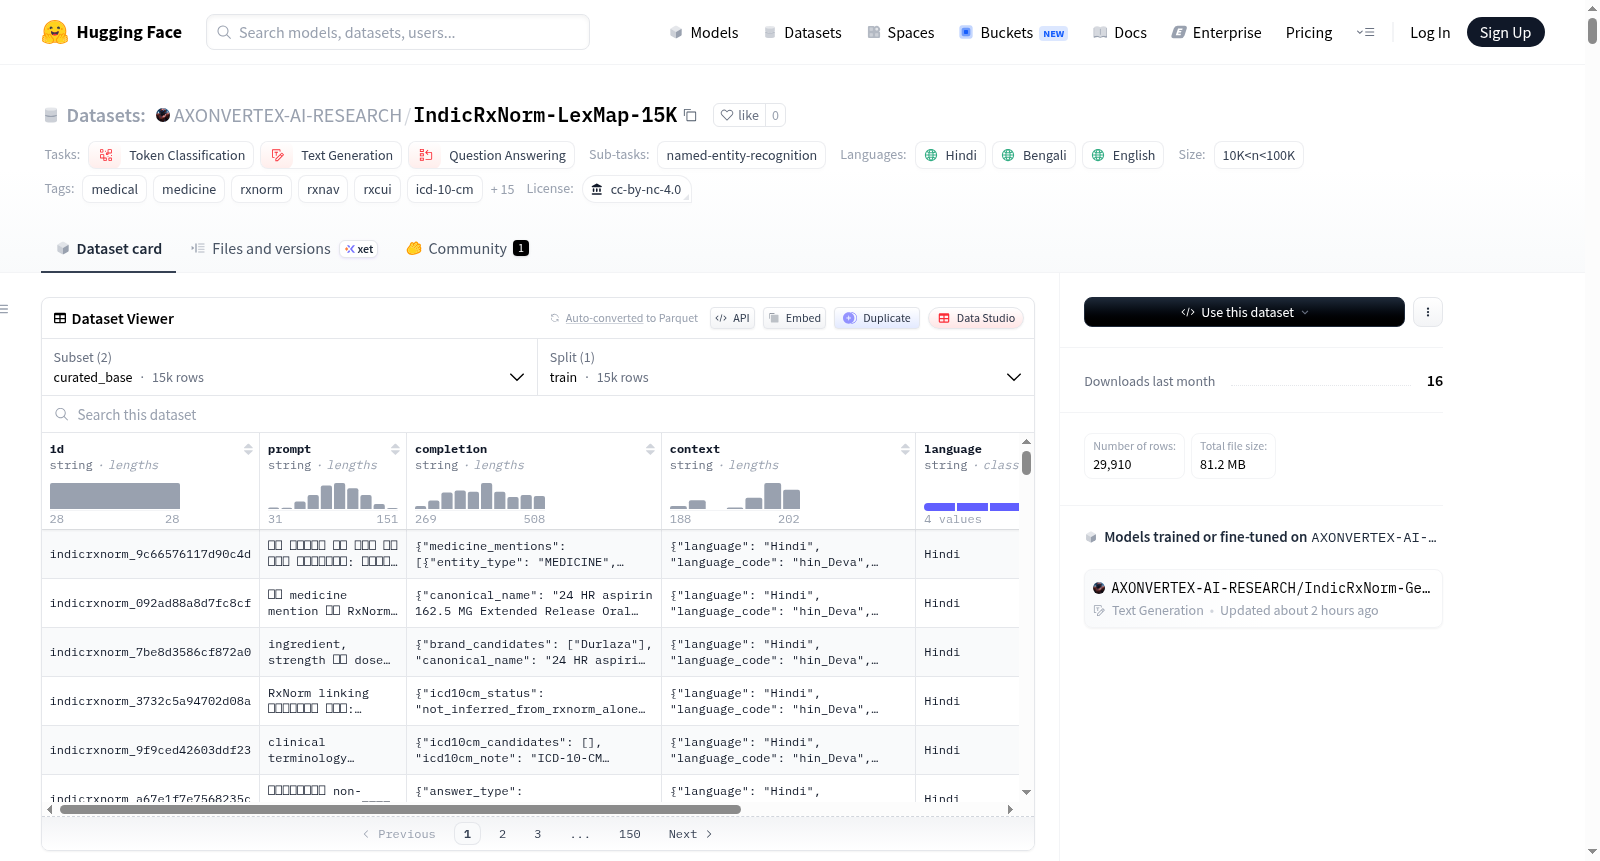
IndicRxNorm-LexMap-15K
收藏资源简介:
IndicRxNorm-LexMap-15K 是一个多语言的印度医药术语指令数据集,专为医药名称理解、RxNorm 标准化、RxCUI 实体链接、结构化药物字段提取和安全非处方临床术语任务而设计。数据集包含两种配置:主要适应数据集和经过整理的基数据集。主要数据集包含 14,910 行数据,支持四种语言/脚本风格(印地语、孟加拉语、Hinglish 和 Banglish)和六种任务类型(如医药名称识别、RxNorm 标准化等)。数据集基于 RxNorm/RxNav 医药术语元数据和 RxCUI 标识符构建,适用于低资源印度临床 NLP 和语音/TTS 预处理任务。数据集明确不用于诊断、治疗计划或处方建议,而是专注于安全的术语标准化任务。
IndicRxNorm-LexMap-15K is a multilingual Indian medical terminology instruction dataset designed for medical name understanding, RxNorm standardization, RxCUI entity linking, structured drug field extraction, and safe over-the-counter clinical terminology tasks. The dataset contains two configurations: the main adaptation dataset and the curated base dataset. The main dataset contains 14,910 rows of data, supporting four language/script styles (Hindi, Bengali, Hinglish, and Banglish) and six task types (such as medical name recognition, RxNorm standardization, etc.). The dataset is built based on RxNorm/RxNav medical terminology metadata and RxCUI identifiers, suitable for low-resource Indian clinical NLP and speech/TTS preprocessing tasks. The dataset explicitly states that it is not intended for diagnosis, treatment planning, or prescription recommendations, but focuses on safe terminology standardization tasks.
数据集概述:IndicRxNorm-LexMap-15K
基本信息
| 属性 | 内容 |
|---|---|
| 数据集名称 | IndicRxNorm-LexMap-15K |
| 许可证 | CC BY-NC 4.0(非商业使用) |
| 语言 | 印地语、孟加拉语、英语(含混合语码 Hinglish 和 Banglish) |
| 规模 | 10K - 100K 条记录 |
| 任务类别 | 词元分类、文本生成、问答 |
| 具体任务 | 命名实体识别、实体链接、标准化 |
数据集配置
该数据集包含两个配置:
| 配置名称 | 文件 | 说明 |
|---|---|---|
multilingual_rxnorm_normalization |
multilingual_rxnorm_normalization.jsonl |
主数据集,由基础数据集经过适应性数据处理生成,包含原始和增强后的提示-完成字段 |
curated_base |
adaptive_upload_indicrxnorm_lexmap_15k.jsonl |
原始基础数据集,包含 15,000 条经过人工整理的记录 |
关键统计信息
主数据集(multilingual_rxnorm_normalization)
| 指标 | 数量 |
|---|---|
| 总行数 | 14,910 |
| JSON 解析错误 | 0 |
| 语言/书写风格种类 | 4 |
| 任务类型种类 | 6 |
语言分布
| 语言/风格 | 行数 |
|---|---|
| Banglish(孟加拉语-英语混合拉丁转写) | 3,736 |
| 印地语 | 3,727 |
| Hinglish(印地语-英语混合拉丁转写) | 3,725 |
| 孟加拉语 | 3,722 |
任务分布
| 任务类型 | 行数 |
|---|---|
| 安全边界拒绝 | 2,494 |
| 术语总结 | 2,490 |
| 药物字段提取 | 2,485 |
| 药物命名实体识别 | 2,482 |
| RxNorm 实体链接 | 2,481 |
| RxNorm 标准化 | 2,478 |
基础数据集(curated_base)
| 指标 | 数量 |
|---|---|
| 总行数 | 15,000 |
| 唯一 RxCUI 标识符数量 | 625 |
| 每语言行数 | 3,750 |
| 每任务类型行数 | 2,500 |
数据模式
主数据集字段
每条记录包含以下字段:
- prompt: 原始提示
- completion: 原始 JSON 完成内容
- enhanced_prompt: 适应性处理后的提示
- enhanced_completion: 适应性处理后的 JSON 完成内容
- context: 紧凑的上下文元数据
- id: 唯一行标识符
- language: 语言名称(Hindi/Bengali/Hinglish/Banglish)
- language_code: 语言代码(hin_Deva/ben_Beng/hi_Latn/bn_Latn)
- task_type: 任务类型
任务类型说明
| 任务类型 | 说明 |
|---|---|
| medicine_ner | 识别文本中的药物名称 |
| rxnorm_normalization | 将表面形式映射到标准 RxNorm 药物名称 |
| drug_field_extraction | 提取药物结构字段(成分、品牌、剂量强度、剂型、RxCUI) |
| rxnorm_entity_linking | 将药物提及链接到 RxNorm 概念唯一标识符 |
| terminology_summary | 提供安全的仅限术语的药物记录总结 |
| safety_boundary_refusal | 拒绝不安全的药物建议请求 |
数据来源
数据集基于以下权威医学术语资源生成:
| 资源 | 用途 | 官方链接 |
|---|---|---|
| RxNorm | 标准临床药物名称和医学术语元数据 | https://www.nlm.nih.gov/research/umls/rxnorm/index.html |
| RxNav/RxNorm API | 程序化 RxCUI 查询和概念检索 | https://lhncbc.nlm.nih.gov/RxNav/APIs/RxNormAPIs.html |
| ICD-10-CM | 术语基础设施(非推断疾病关联) | https://www.cdc.gov/nchs/icd/icd-10-cm/index.html |
数据集用途
适用场景
- 药物命名实体识别:在印地语、孟加拉语、Hinglish 和 Banglish 文本中识别药物名称
- RxNorm 标准化:将多种书写形式的药物名称映射到标准 RxNorm 名称
- RxCUI 实体链接:将药物提及链接到 RxNorm 概念唯一标识符
- 药物字段提取:提取成分、品牌、剂量强度、剂型和 RxCUI
- TTS 语音管道:在语音合成前标准化药物名称
- 安全拒绝行为:训练模型拒绝不安全的药物建议请求
- 多语言药物搜索:改进多语言药物检索和转写感知搜索
- 小型印地语 LLM 微调:为印地语语言模型提供紧凑的指令微调数据
不适用场景
- 诊断、治疗计划、处方建议
- 剂量推荐、药物-疾病关联建议
- 紧急分诊、临床决策支持
- 替代临床医生判断
数据集创建流程
- RxNorm 概念收集:按 TTY 类别(SCD、SBD、BN、MIN、IN)获取概念
- 化学名称过滤:去除不适合患者使用的化学/IUPAC 名称
- 平衡药物种子选择:平衡常见门诊药物、口服剂型、品牌药和成分多样性
- 多语言指令生成:扩展到印地语、孟加拉语、Hinglish 和 Banglish
- 安全验证:确保所有完成内容包含安全边界声明
- Unicode 安全去重:保留印地语和孟加拉语正确的书写形式
- 适应性数据精炼:使用 Adaptive Data 平台进行质量改进
数据质量与安全性
质量检查结果
| 检查项 | 结果 |
|---|---|
| 基础数据集行数 | 15,000 |
| 唯一 ID | 15,000 |
| 重复提示-完成对 | 0 |
| 有效 JSON 完成内容 | 15,000 |
| 安全注释存在比例 | 100% |
| 不安全剂量/治疗模式命中 | 0 |
| 语言分布均衡性 | 通过 |
| 任务分布均衡性 | 通过 |
适应性处理前后质量对比
| 指标 | 处理前 | 处理后 |
|---|---|---|
| 质量评分 | 8.0 | 9.0 |
| 等级 | B | A |
| 百分位 | 11.8 | 33.0 |
| 相对提升 | — | 12.5% |
示例
原始提示(印地语)
इस वाक्य से दवा का नाम पहचानें: मेरी दवा का नाम एस्पिरिन है।
原始完成内容
json { "medicine_mentions": [ { "entity_type": "MEDICINE", "normalized_name": "24 HR aspirin 162.5 MG Extended Release Oral Capsule [Durlaza]", "rxcui": "1665362", "rxnorm_match_status": "matched", "surface_form": "एस्पिरिन" } ], "safety_note": "Terminology normalization only. Not diagnosis, prescription, dosage, or treatment advice." }