
遇见数据集

Koa-Chang/TissueMNIST-224-1pct-gpt55-with-vlm-features

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

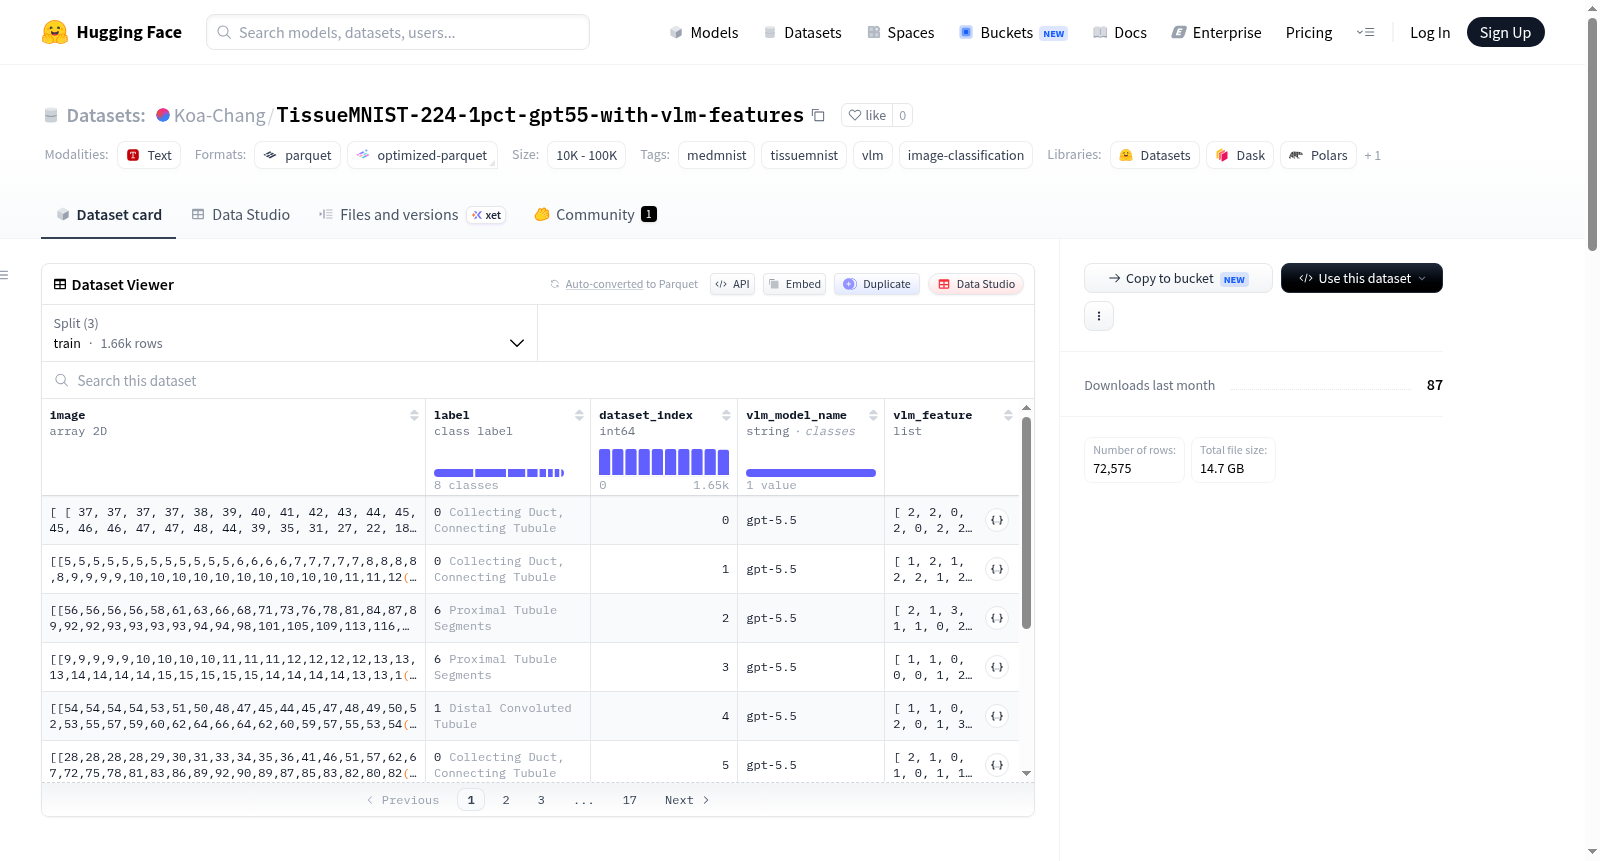
该数据集名为TissueMNIST 224 1pct with GPT-5.5 VLM Features,是基于官方MedMNIST TissueMNIST 224px数据衍生的。它包含1%的TissueMNIST训练子集,其中带有由GPT-5.5生成的分类形态学特征(VLM特征)。验证集和测试集是完整的TissueMNIST传递分割,为了保持模式一致性,其vlm_model_name字段为空且vlm_feature字段为占位符值。VLM特征标签是用于CS231N课程中VLM-LUPI(视觉语言模型-学习使用特权信息)实验的分类特权信息注释,并非临床诊断。数据集包含以下列:image(原始的224x224 uint8灰度TissueMNIST图像)、label(TissueMNIST类别标签)、dataset_index(在源MedMNIST分割中的官方索引)、vlm_model_name(生成分类VLM特征的模型名称,传递分割中为空)和vlm_feature(整数编码的分类形态学特征,传递分割中包含零占位符)。VLM特征涵盖多个形态学维度,如背景杂乱、主导区域尺度、主导形状、边缘接触、伸长率、前景分数、内部信号纹理、局部排列、原始对比度、信号分布和可见对象计数等。

A 1% TissueMNIST train subset with categorical morphology features generated by GPT-5.5. Validation and test are full TissueMNIST passthrough splits with null `vlm_model_name` and placeholder `vlm_feature` values for schema consistency. This dataset is derived from the official MedMNIST TissueMNIST 224px data. The VLM feature labels are categorical privileged-information annotations for CS231N VLM-LUPI experiments, not clinical diagnoses.
提供机构:
Koa-Chang
搜集汇总
数据集介绍
Koa-Chang/TissueMNIST-224-1pct-gpt55-with-vlm-features 数据集图片
构建方式
TissueMNIST-224-1pct-gpt55-with-vlm-features数据集源自官方MedMNIST项目中的TissueMNIST 224像素版本,是面向视觉语言模型与特权信息学习(VLM-LUPI)实验而精心构建的。其训练集仅保留原始数据的1%,共计1,655个样本,并由GPT-5.5模型为这些样本生成了类别化的形态学特征作为特权信息标注。验证集和测试集则完整保留了原始TissueMNIST的全部23,640和47,280个样本,但为保持数据模式的一致性,在这些划分中vlm_model_name字段设为null,vlm_feature字段填充为零占位符。数据集通过HuggingFace的datasets库进行组织,每条记录包含原始灰度图像、组织类别标签、稳定的MedMNIST索引以及VLM特征信息。
特点
该数据集最显著的特点在于引入了特权信息(privileged information)机制,训练集中每个样本都附带由GPT-5.5生成的11维类别形态学特征,涵盖了背景杂乱度、主导区域尺度、主导形状、边缘接触状态、伸长程度、前景占比、内部信号纹理、局部排布方式、原始对比度、信号分布以及可见对象数量等微观组织形态学维度。这些特征不属于临床诊断标签,而是用于在训练阶段为模型提供额外的高层语义指导,从而探索在推理阶段不依赖此类信息的LUPI学习范式。验证集和测试集不包含真实VLM特征,确保了模型评估的公平性和实用性。同时,数据集提供了全局索引映射方案,便于与完整的TissueMNIST数据集进行交叉引用和联合操作。
使用方法
使用该数据集十分便捷,研究人员可通过HuggingFace的datasets库直接加载:首先执行`from datasets import load_dataset`,然后调用`load_dataset('Koa-Chang/TissueMNIST-224-1pct-gpt55-with-vlm-features')`即可获得包含train、val、test三个划分的数据集对象。在训练时,可以利用`dataset_index`列作为稳定的MedMNIST标识符,通过`(split, dataset_index)`二元组唯一确定原始样本,或使用预定义的全局索引偏移量(train=0, val=165466, test=189106)计算全局整数索引。对于VLM-LUPI实验,训练阶段应使用真实的vlm_feature列作为特权信息输入,而验证和测试阶段则忽略该列或使用其占位符。项目代码中可通过`data.huggingface.from_huggingface()`函数方便地集成该数据源。
背景与挑战
背景概述
TissueMNIST-224-1pct-gpt55-with-vlm-features数据集由Koa-Chang等人创建,旨在探索视觉语言模型(VLM)在医学图像分析中的潜力,特别是利用GPT-5.5生成的形态学特征作为特权信息,以提升传统图像分类任务的性能。该数据集源于MedMNIST项目中的TissueMNIST子集,选取了1%的训练样本(1655张224×224像素的灰度图像),并附加了11类细粒度的形态学特征标注,如背景杂波、细胞形状、纹理等。这些特征并非临床诊断依据,而是专为 CS231N VLM-LUPI(学习利用特权信息)实验设计,为医学图像分析中多模态信息融合提供了新的基准。该数据集填补了小型医学影像数据集与先进VLM技术结合的空白,推动了机器学习在病理组织分类领域的发展。
当前挑战
该数据集的核心挑战在于处理领域特定问题与构建过程中的双重难点。在领域层面,TissueMNIST-224-1pct-gpt55-with-vlm-features所针对的图像分类任务面临医学组织病理图像固有的复杂性,如细胞形态的高度异质性、染色差异及噪声干扰,而GPT-5.5生成的形态学特征虽提供了特权信息,但其准确性和临床相关性仍需验证。在构建过程中,挑战包括从完整TissueMNIST中仅抽取1%的训练样本,导致数据稀疏性,易引发模型过拟合;同时,VLM特征为分类学标注而非连续数值,如何有效整合这些离散型特权信息到标准分类架构中是一个技术难题。此外,验证集和测试集未附带真实VLM特征,仅以占位符填充,这限制了模型在特权信息学习场景下的评估。
常用场景
经典使用场景
TissueMNIST-224-1pct-gpt55-with-vlm-features数据集是医学影像分析领域一颗璀璨的明珠,它源自MedMNIST基准中的TissueMNIST子集,专注于组织病理学图像的分类任务。该数据集的经典使用场景在于结合视觉语言模型(VLM)生成的先验知识进行图像分类研究,仅采用1%的训练样本,却借助GPT-5.5提取的类别形态特征作为特权信息,探索小样本学习与知识蒸馏的极致效能。研究人员通常利用其精心设计的训练集、验证集和测试集划分,在保持标准评估流程的同时,验证特权信息如何在不增加推理阶段计算负担的前提下提升模型性能,成为研究视觉与语言跨模态融合的典范平台。
实际应用
在实际应用层面,该数据集为临床病理诊断的辅助决策系统注入了新活力。基于组织切片图像对良恶性病变进行快速分类是病理学中的核心需求,而TissueMNIST-224-1pct-gpt55-with-vlm-features所倡导的VLM特权信息方法,可使模型在仅暴露于极少量标注数据的情况下,依然保持对复杂形态的高精度识别能力。例如,在乳腺癌、结肠癌等常见癌症的初步筛查中,集成该方法的模型能够学习到专家级别的形态学描述(如边缘接触程度、信号分布模式),从而辅助病理医生减少误诊率。此外,其轻量化的推理特性使得部署于资源受限的远程医疗设备成为可能,极大拓展了高质量诊断服务的可及性。
衍生相关工作
围绕该数据集已涌现出一系列具有深远影响的经典工作。在VLM-LUPI实验框架下,研究者们构建了结合形态特征与图像特征的联合训练范式,相关工作探索了如何通过特征对齐和对比学习最大化特权信息的利用效率,代表性的有基于互信息最大化的特征蒸馏模型。此外,该数据集还催生了小样本学习领域的创新,例如提出动态权重分配机制来平衡不同形态特征的重要性,以及设计跨模态注意力网络以模拟人类病理学家对形态学描述的解读过程。这些衍生工作共同推进了医学影像分析从数据密集型向知识密集型范式的转变,使得模型能够在专家知识引导下实现更鲁棒和可解释的诊断决策。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

