vitra-instructions-qwen35-122b-egocentric-v1
收藏资源简介:
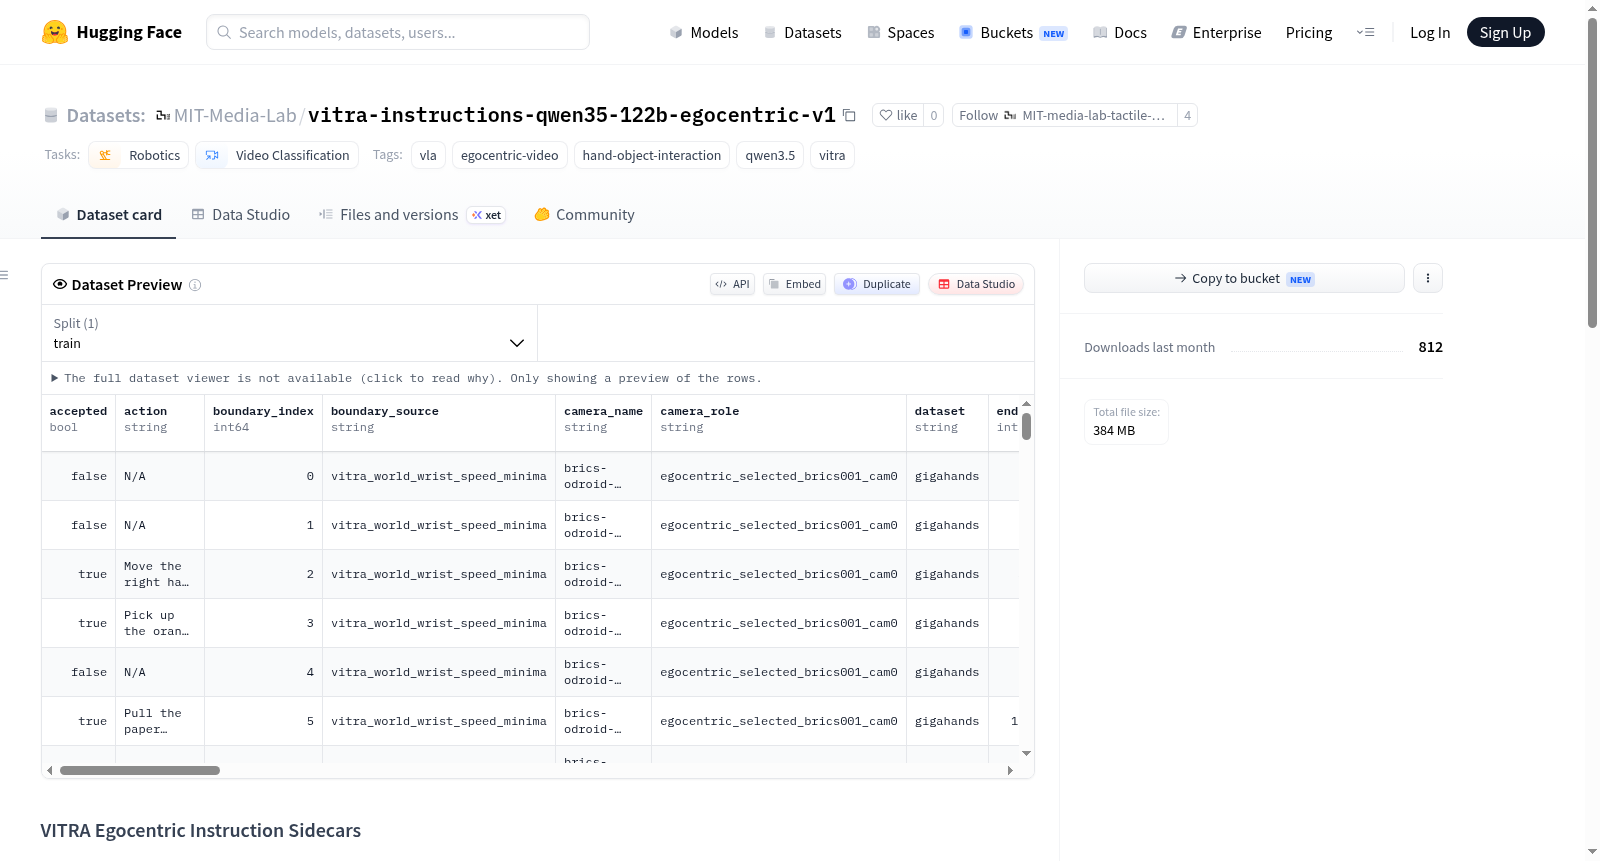
VITRA Egocentric Instructions Sidecars 是一个由 Qwen3.5-122B 模型从 VITRA 附录 A.1 第一轮提示生成的候选手部动作指令数据集,第二轮生成五个保持原意的祈使句改写。该数据集以 sidecar 形式发布,不修改或替换原始 VITRA 片段。每条记录包含源仓库/修订版、注释和视频路径、手部、半开帧范围、时间范围、边界方法、模型、提示版本、解析状态以及原始弱/官方指令。数据来源包括 OakInk2、HOT3D、HOI4D 和 GigaHands 数据集(DexYCB 因缺乏第一人称视图被排除)。管道流程:使用官方区间或 VITRA 风格手腕速度局部最小值划分片段;均匀采样 8 帧;投影未来 3D 手掌轨迹;VLM 生成一个祈使句手部动作或 N/A;对接受的动作为生成五个改写。数据集适用于机器人 VLA 任务和第一人称视频理解,提供可审计的生成结果。
VITRA Egocentric Instructions Sidecars is a dataset of candidate hand action instructions generated by the Qwen3.5-122B model from the first round of prompts in VITRA Appendix A.1, with a second round generating five imperative rewrites that preserve the original meaning. The dataset is released in sidecar format, without modifying or replacing the original VITRA clips. Each record contains source repository/revision, annotations and video paths, hand, semi-open frame range, temporal range, boundary method, model, prompt version, parsing status, and original weak/official instruction. Data sources include OakInk2, HOT3D, HOI4D, and GigaHands datasets (DexYCB is excluded due to lack of first-person view). Pipeline: segment clips using official intervals or VITRA-style wrist velocity local minima; uniformly sample 8 frames; project future 3D palm trajectories; VLM generates an imperative hand action or N/A; for accepted actions, generate five rewrites. The dataset is suitable for robot VLA tasks and first-person video understanding, providing auditable generation results.
数据集概述
数据集名称:VITRA Egocentric Instructions (Qwen3.5-122B)
数据集类型:侧车数据集(Sidecar Dataset)
任务类别:机器人学、视频分类
标签:VLA、第一视角视频、手-物交互、Qwen3.5、VITRA
核心内容
该数据集包含由 Qwen/Qwen3.5-122B-A10B-FP8 模型生成的候选手部动作指令,基于 VITRA 附录 A.1 首轮提示词生成。第二轮通过 VLA-HAND 的 episode_cutting 流程生成五个保持语义的命令式改写版本。
作为侧车数据集,它不修改或替换原始 VITRA 片段。每一行记录包含:
- 精确的源仓库/修订版本
- 标注和视频路径
- 手部标识、半开帧范围、时间范围
- 边界方法、模型、提示词版本、解析状态
- 原始弱/官方指令
视图策略
每个物理片段仅使用一个主第一视角/头戴式 RGB 视图:
- OakInk2:仅使用
egocentric视图 - HOT3D:使用主 Quest RGB
1201-1或 Aria RGB214-1 - HOI4D:使用耦合的头戴式 RGB 流
- GigaHands:严格使用
brics-odroid-001_cam0映射 - DexYCB:明确排除(仅有外部固定 RealSense 摄像头,无第一视角流)
生成流程
- 优先使用官方 OakInk2 原始时间区间;否则应用 VITRA 风格的平滑三维手腕速度局部最小值(世界坐标系,0.5 秒居中窗口),在活动手部独立计算
- 从每个候选片段均匀采样八个时间有序帧
- 在每个采样帧上,使用该帧自身的世界到相机外参投影未来三维手掌轨迹;若源视频未校正,则应用相机畸变
- 向视觉语言模型请求一个命令式、特定手部的动作或
N/A,并保留简短视觉理由 - 对接受的动作,生成五个保持语义的改写版本
accepted=true 的行具有解析出的非 N/A 动作。被拒绝的行保留在发布中以便审计;此生成任务不会破坏性删除任何源片段。
数据来源
MIT-Media-Lab/oakink2-vitra-streaming-v1MIT-Media-Lab/hot3d-clips-vitra-streaming-v3MIT-Media-Lab/hoi4d-vitra-streaming-v1LeoJiangOR/gigahands-vitra-mano-strict-v1MIT-Media-Lab/dexycb-vitra-streaming-v2(仅视图策略排除)
各数据集的进度和最终计数存储于 state/ 目录;生成的 JSONL 分片存储于 data/<dataset>/ 目录,可按确定性片段 ID 安全恢复。