burrito-evals
收藏资源简介:
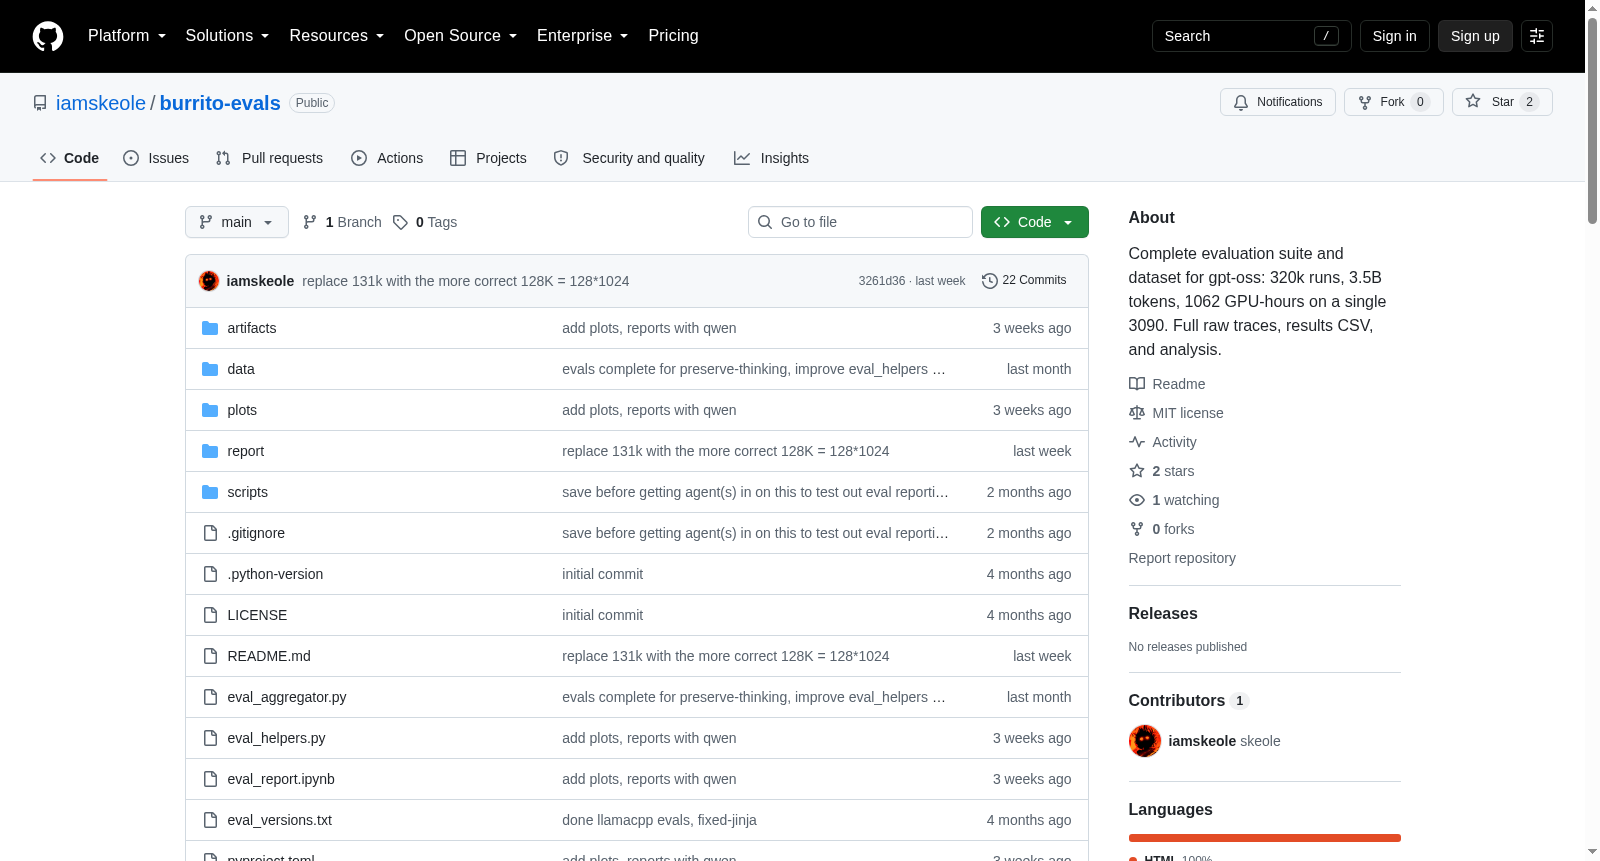
用于gpt-oss的完整评估套件和数据集,包含320,192次运行、3.49B tokens、在单个RTX 3090上耗时1,062 GPU小时。数据集包括eval_results.csv(每行对应一次运行,包含后端、API、工具架构模式、推理努力、种子、token计数、延迟、正确性等字段),以及原始模型输出和推理轨迹、Jinja模板、评估规范、报告和44个图表。
A complete evaluation suite and dataset for gpt-oss, consisting of 320,192 runs, 3.49B tokens, and consuming 1,062 GPU hours on a single RTX 3090. The dataset includes eval_results.csv, where each row corresponds to one run and contains fields such as backend, API, tool architecture pattern, inference effort, seed, token count, latency, correctness, etc., alongside raw model outputs and inference trajectories, Jinja templates, evaluation specifications, reports, and 44 charts.
数据集概述
burrito-evals 是一个公开的评估数据集与评估套件,用于记录论文/项目 gpt-oss 的推理基准测试结果。该数据集包含 320,192 次运行,对应 34.9 亿 tokens 的推理数据,总计消耗 1,062 GPU 小时(在单张 RTX 3090 上完成)。
核心内容
data/eval_results.csv— 主数据集:320,192 行,每一行为一次运行的详细记录,包含后端、API 类型、工具 schema 模式、工具标志、推理努力程度、随机种子、各类 token 计数(输入/输出/推理/回复)、延迟、正确性、工具调用次数、多轮任务簿记以及错误/失败模式。data/gpt_oss/、data/bfcl_v4/— 每次运行的原始模型输出(含完整推理踪迹),按运行配置和种子分目录存储。artifacts/— 包含两个 Jinja 聊天模板(默认版本与修复版本)以及全部的评估规格说明(eval_specs.xlsx)。report/— 完整的实验报告(含七个主要发现)、公开文章、推理深度分析、全部 44 张图的规范记录以及详细数据参考文档。plots/— 44 张评估图,涵盖各阶段的 5 个可靠性指标(平均准确率、pass@8、pass^8、fail^8、错误率)。- 代码 — 包含评分/聚合引擎(
eval_aggregator.py)、分析与绘图套件(eval_helpers.py)、可复现全部图表的 Jupyter Notebook(eval_report.ipynb)以及各后端的服务配置脚本。
主要发现
- 配置比模型能力更重要 — 相同权重的模型得分可从约 0% 变化到约 87%,取决于模板、工具格式、API 类型和努力程度。
- 默认 Jinja 模板会破坏模型性能 — 在无工具场景下,修正模板可将实测准确率从约 3% 提升至约 40%。
- API 类型影响显著 — vLLM 上
/v1/responses在多轮任务中的错误率(73.5–83.5%)远高于/v1/chat/completions(29.0–36.0%)。 - 结构化工具 schema 可大幅提升多轮任务准确率 — 相比 AST 解析方式,多轮准确率可提升至原来的三倍(后者几乎降为 0%)。
- 推理努力程度不仅改变长度,更影响答案质量 — 固定约 1.4K 推理 token 预算下,AIME25 在低/中/高努力下准确率分别为 38%/97%/100%。
- 原生 Python 工具可额外提升 10–24 个百分点的准确率,同时降低 token 使用量。
实验设置
- 模型与硬件 — gpt-oss-20b(MXFP4 量化,128K 上下文),单张 RTX 3090,batch size 1,temperature 1.0。
- 规模 — 320,192 次运行 = 40,024 个(配置, 问题)对 × 8 个随机种子。
- 评估阶段:每个阶段报告 5 个指标(平均准确率、pass@8、pass^8、fail^8、错误率)。
- 测试后端(7 个) — burrito over llama.cpp / vLLM(各有保留思考变体)、vanilla llama.cpp(默认与修复模板)、vanilla vLLM。
- 基准测试 — BFCL v4(三种模式:非实时、实时、多轮基础)+ AIME25 + GPQA(来自 OpenAI GPT-OSS 推理套件)。
- 实验维度 — 两种 API(
/v1/chat/completions与/v1/responses)、两种工具定义模式(结构化 schemas vs AST 解析)、三种推理努力程度(低/中/高)、是否启用 python / browser 工具。
复现方法
数据集分析无需 GPU,整个报告仅从 CSV 派生。用户可通过 uv sync 安装依赖后打开 eval_report.ipynb 重算标题数字并重新生成全部 44 张图。重新运行完整评估则需要 GPU 及对应后端。
许可证
MIT 许可证,涵盖本仓库中所有数据、轨迹与工件。