
agent-sft-stitch-zh
收藏官方服务:
资源简介:
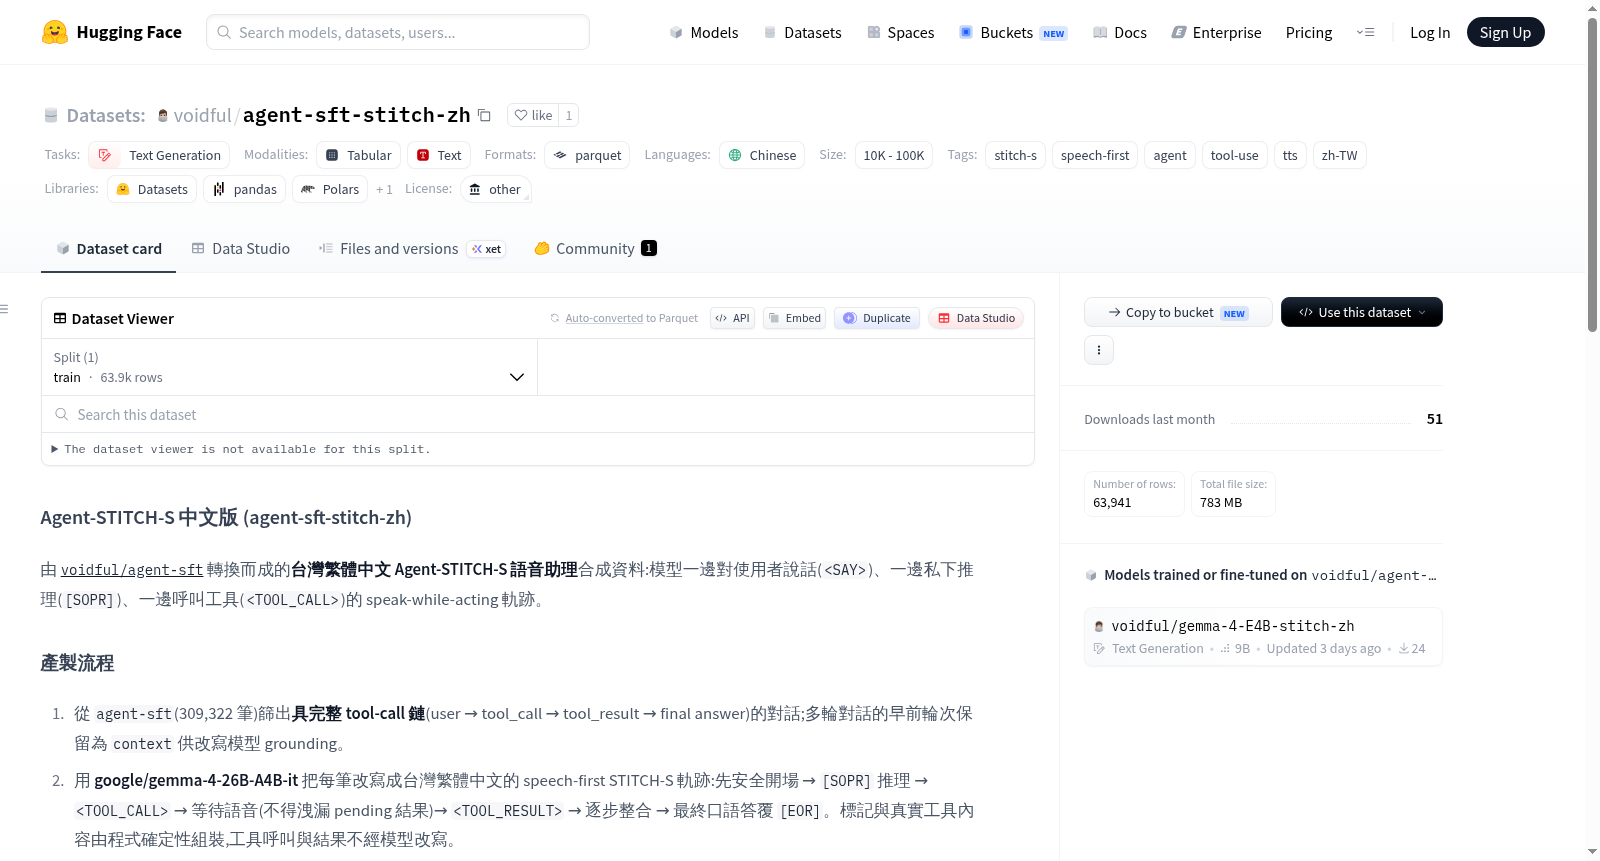
Agent-STITCH-S中文版是一个用于训练和评估中文(台湾繁体)语音优先智能体的高质量合成对话数据集。它基于agent-sft数据集转换而来,模拟智能体在交互过程中“边说话、边推理、边调用工具”的speak-while-acting行为轨迹。数据内容经过严格筛选和生成流程,从原始对话中筛选出完整逻辑链的样本,并使用大型语言模型改写成符合特定结构的台湾繁体中文STITCH-S轨迹,该轨迹遵循安全开场、私下推理、工具调用、等待语音、接收工具结果、逐步整合信息到给出最终口语答复的流程。数据集包含63,941条高质量样本,均基于9维18分制量规进行自动评分,仅保留总分不低于17分且无硬性失败的样本,平均分高达17.909,覆盖16个原始来源。每个样本包含标识与来源、用户查询、智能体行为轨迹、元数据、总分、分项分数和评估JSON等字段。适用于开发自然语音交互、工具调用和逐步推理能力的对话式人工智能系统,特别是在中文语音助手和工具使用智能体领域。
创建时间:
2026-06-29
原始信息汇总
数据集概述:Agent-STITCH-S 中文版 (agent-sft-stitch-zh)
这是一个专为语音优先智能体设计的台湾繁体中文合成数据集,模拟模型在对话中同时进行口语回复、内部推理和工具调用的“边说边做”行为。
核心特性
- 语言:台湾繁体中文 (zh-TW)
- 任务:文本生成
- 标签:stitch-s, speech-first, agent, tool-use, tts
- 许可证:其他 (other)
数据来源与生成流程
- 基座数据集:源自
voidful/agent-sft(309,322 条),筛选出具有完整工具调用链的对话。 - 改写模型:使用
google/gemma-4-26B-A4B-it将筛选出的对话改写为 speech-first 的 STITCH-S 轨迹格式。 - 质量控制:
- 去除工具步骤与请求无关、出现改写者元语言、步骤不对齐、JSON 不可解析的样本。
- 采用 9 维 / 18 分制的 STITCH-S 标准严格评分。
- 仅保留总分 ≥ 17 分且无 hard-fail 的样本。
数据结构与字段
id:样本 IDsource:原始 agent-sft 数据来源user:中文用户语句msg:STITCH-S 轨迹(包含推理标签[SOPR]/[EOPR]/[EOR],工具调用标签<TOOL_CALL>,工具结果标签<TOOL_RESULT>)input:评分用元数据(如上下文、可用工具、工具步骤、参考答案等)total_score:总分 (0-18)evaluation_json:完整的 9 维评分及评语(包含工具有效性维度)
数据统计
- 总评分样本数:76,450
- 保留样本数:63,941
- 拒绝样本数:9,056(其中约 6,300 个为超长样本,约 2,756 个为质量不合格)
- 保留数据平均分:17.909 / 18
- 主要来源分布:
- nemotron_terminal: 24,147
- toolmind: 17,987
- glaive: 6,119
- hermes_reasoning: 3,961
- apigen_mt: 3,934
- at_deepseek_v4_pro: 3,017
- (其他来源占比相对较小)
搜集汇总
数据集介绍
构建方式
该数据集源自 `voidful/agent-sft` 原始语料,经过多阶段精细构建而成。首先,从逾三十万条样本中筛选出具备完整工具调用链的对话,并将多轮对话的早期轮次保留为上下文,供后续改写模型进行 grounding。随后,利用 `google/gemma-4-26B-A4B-it` 模型将每条样本改写成台湾繁体中文的 speech-first STITCH-S 轨迹,严格遵循安全开场、推理、工具调用、等待语音、工具结果返回、逐步整合及最终口语答复的时序逻辑,工具调用与结果部分由程序确定性组装,不经模型改写。接着,通过多道品质闸门过滤,包括丢弃与当前请求无关的幻象步骤、剔除出现改写者后设语言的私有状态、丢弃步骤不对齐或 JSON 不可解析的样本。最后,采用九维度十八分的 STITCH-S 评估标准,以同一模型严格评分,仅保留总分不低于十七分且无硬性失败条件的样本,最终获得六万三千余条高质量轨迹。
特点
该数据集的核心特点在于其高度结构化的说话与行动协同轨迹。每一条样本均以 STITCH-S 格式组织,清晰标记了安全开场、私有推理区域、工具调用、工具结果、最终口语答复等阶段,完整记录模型一边与用户对话、一边私下推理、一边调用工具的并行行为。数据采用台湾繁体中文,语言风格贴近客服场景,兼顾口语自然度与工具调用的精确性。所有工具调用与结果均源自原始数据,未经模型改写,保障了内容的真实性。此外,数据集附带详尽的多维度评分体系,覆盖语音优先性、工具等待安全性、时序因果、逐步整合、标记正确、静默间隔、grounding、客服口语品质及工具有效性,并由同一评估模型给出严格的量化反馈,为后续研究与模型训练提供了可靠的质量参考。
使用方法
该数据集适用于文本生成任务,尤其是面向智能体助理的训练与评估。用户可直接加载 `msg` 字段中的 STITCH-S 轨迹作为监督学习的目标序列,结合 `user` 字段中的用户语句和 `input` 字段中的上下文、可用工具、工具步骤等元信息,构建以对话历史为输入、以结构化动作与回复为输出的训练方案。数据集中 `total_score` 及各分项评分可用于加权采样或困难样本挖掘,`evaluation_json` 中的完整评估语料则便于研究者分析模型在不同维度上的表现弱点。对于需要离线评估的场景,可利用评分与拒绝标签筛选出高质量子集。该格式天然支持对话微调、工具使用学习及多轮推理能力增强等研究方向,研究者亦可依据自身需求对轨迹中的特殊标记做进一步解析或二次处理。
背景与挑战
背景概述
随着大型语言模型在工具调用与多轮交互场景中的广泛应用,如何在语音对话系统中实现模型“边说边做”的实时协同行为,成为一项关键研究挑战。2024年,由voidful团队基于agent-sft数据集构建的agent-sft-stitch-zh数据集应运而生,该数据集专注于生成台湾繁体中文的STITCH-S语音助理轨迹,包含模型同时进行语音输出、内部推理与工具调用的复合行为。数据集通过严格的筛选与质量评估流程,最终保留63,941条高质量样本,为多模态语音代理研究提供了标准化基准,显著推动了工具增强型对话系统的发展。
当前挑战
该数据集所应对的核心挑战在于,传统语音助手通常无法在工具调用过程中同步生成自然语音,导致交互延迟与信息断裂。agent-sft-stitch-zh通过设计speech-first的STITCH-S轨迹,强制模型在语音响应中穿插内部推理标记与工具调用指令,解决了时序因果与安全等待问题。构建过程中,数据清洗面临多轮对话中工具链完整性保持、模型后设语言污染以及步数对齐等难题,团队借助基于gemma-4模型的9维评分体系与确定性过滤器,剔除了9,056条不合格样本,确保了最终数据集的高一致性与可用性。
常用场景
经典使用场景
在语音交互与工具调用融合的研究领域,agent-sft-stitch-zh数据集为构建兼具说话、推理与工具操作能力的智能体提供了关键资源。其经典使用场景在于训练语言模型在单一响应中生成融合语音输出(<SAY>)、内部推理([SOPR])和工具调用(<TOOL_CALL>)的复杂轨迹,即speak-while-acting范式。研究者可基于该数据集的多轮对话上下文与高质量STITCH-S标注,使模型学会在安全开场后私下思考步骤,进而调用工具获取信息,待结果返回后逐步整合并给出最终口语答复,从而模拟人类助理边行动边交流的协作模式。
解决学术问题
该数据集着重解决了学术领域中多模态行为协同生成的难题,即如何让语言模型在响应过程中同时执行工具使用、内部推理和流畅语音生成,并确保时序因果正确、工具调用安全性以及步骤对齐。以往研究常将说话与行动割裂,导致模型在需要实时工具获取信息时暴露出推理中断或虚假陈述等问题。agent-sft-stitch-zh通过严谨的清洗、改写与多维度评分机制(如语音优先、工具等待安全性、逐步整合等),为模型训练提供了符合严格标准的样本,有效推动了人机协作中说话与行动无缝衔接的研究进展,对探索通用智能体行为建模具有深远意义。
衍生相关工作
该数据集衍生了一系列典型工作,包括对speak-while-acting范式的进一步探索与优化。例如,研究者基于agent-sft-stitch-zh开发了针对台湾繁体中文化语的语音智能体评估基准,验证模型在语音优先约束下的工具调用成功率;也有人利用该数据集微调开源大模型,构建了具备思考-说话-行动三重能力的语音助手原型。此外,该数据集中的STITCH-S评分方法(9维/18分)被广泛借鉴,用于设计自动化质量评估框架,推动了更多高质量语音-工具混合数据集的生产与蒸馏流程,如将高评分样本作为教师数据训练轻量级模型,实现边缘设备上的高效部署。
以上内容由遇见数据集搜集并总结生成


