
filesystem_huggingface_terminal_howtocook_5088_v2026_recipe_hub
收藏数据链接:
官方服务:
资源简介:
精选菜谱集是一个由食谱内容运营团队自动生成的高质量菜谱数据集,包含7道经过审核的菜谱,涵盖荤菜、素菜、水产、饮品、早餐、汤等六大类别。每道菜谱提供名称、难度星级(1-5星)以及提交人信息。该数据集可用于菜谱推荐、菜谱分类、难度预测等任务,也可作为烹饪教学或食谱分析的基础数据资源。
The Selected Recipe Collection is a high-quality recipe dataset automatically generated by the recipe content operations team, containing 7 reviewed recipes covering six categories: meat dishes, vegetarian dishes, aquatic products, beverages, breakfast, and soup. Each recipe provides the name, difficulty rating (1-5 stars), and submitter information. This dataset can be used for tasks such as recipe recommendation, recipe classification, difficulty prediction, and can also serve as a basic data resource for cooking teaching or recipe analysis.
创建时间:
2026-08-15
原始信息汇总
精选菜谱集概要
- 发布日期:2026-08-15
- 申请总数:10
- 通过数量:7
- 驳回数量:3
- 平均难度(星):2.86
- 分类统计:荤菜 1 道,素菜 2 道,水产 1 道,饮品 1 道,早餐 1 道,汤 1 道
收录菜谱列表
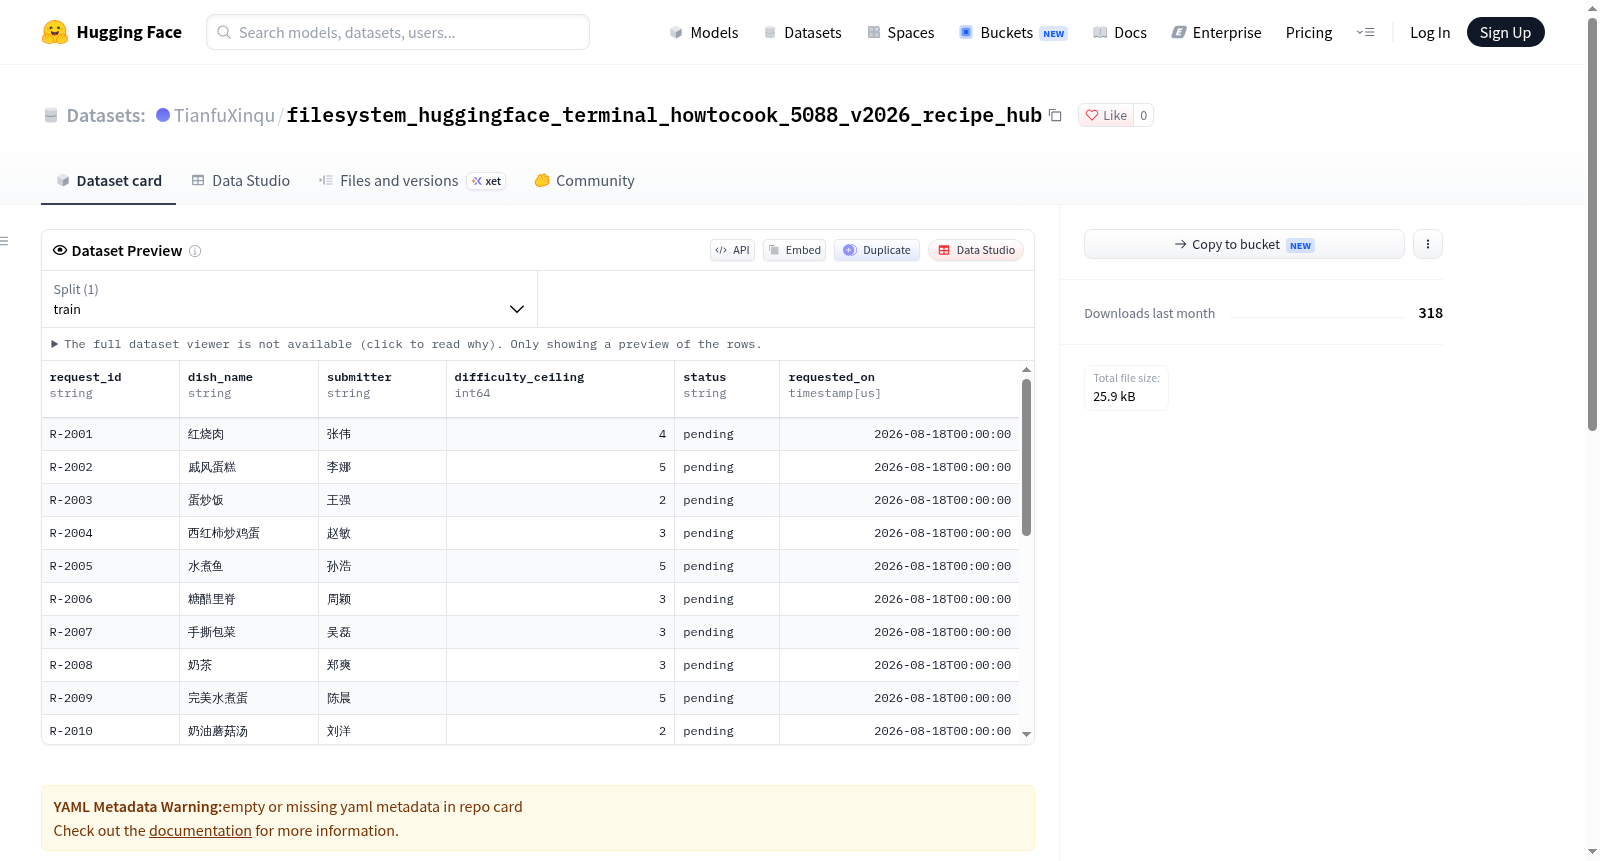
| 菜名 | 分类 | 难度(星) | 提交人 |
|---|---|---|---|
| 简易红烧肉 | 荤菜 | 3 | 张伟 |
| 西红柿炒鸡蛋 | 素菜 | 2 | 赵敏 |
| 水煮鱼 | 水产 | 4 | 孙浩 |
| 手撕包菜 | 素菜 | 3 | 吴磊 |
| 奶茶 | 饮品 | 2 | 郑爽 |
| 完美水煮蛋 | 早餐 | 5 | 陈晨 |
| 奶油蘑菇汤 | 汤 | 1 | 刘洋 |
说明
- 本数据集由食谱内容运营团队自动生成。
- 共收录通过审核的菜谱 7 道,覆盖 6 个分类,难度跨度从 1 星到 5 星。
搜集汇总
数据集介绍
构建方式
在烹饪数据资源领域,菜谱数据集的构建通常需兼顾内容多样性与质量筛选。本数据集基于食谱内容运营团队的自动化流程生成,初始申请总数为10份菜谱,经审核通过7份、驳回3份,通过率约为70%。审核维度涵盖菜品分类、难度星级及提交人信息,最终收录荤菜、素菜、水产、饮品、早餐、汤等七类菜品,平均难度为2.86星,体现了以人工审核与自动生成相结合的数据集构建策略。
特点
该数据集的核心特征在于其精细的分类体系与难度标注。七道菜谱分别归属于荤菜、素菜、水产、饮品、早餐和汤六大类别,其中素菜占两例,其余类别各一例,覆盖日常饮食的主要场景。难度星级从1星至5星不等,跨度较大,可满足从初学者到进阶烹饪者的不同需求。每道菜谱均附有提交人姓名,增强了数据来源的可追溯性,同时发布日期与审核统计信息为数据集的时间版本管理提供了依据。
使用方法
使用该数据集时,研究者或开发者可依据分类标签进行菜谱检索与筛选,例如提取素菜或汤类子集用于特定饮食推荐任务。难度星级可作为排序或分层依据,服务于个性化菜谱推荐系统的构建。提交人信息可用于分析不同贡献者的菜谱风格分布,而发布日期与审核通过率则有助于评估数据集的时间演变特征。整体数据适用于烹饪教育、食材搭配分析及自然语言处理中的菜谱文本生成等场景。
背景与挑战
背景概述
随着数字化烹饪知识的迅速积累,食谱数据集的构建成为自然语言处理与跨模态学习领域的重要课题。filesystem_huggingface_terminal_howtocook_5088_v2026_recipe_hub数据集于2026年8月15日由食谱内容运营团队发布,该团队长期致力于结构化烹饪内容的采集与整理。数据集包含10份申请中的7份通过审核的精选菜谱,涵盖荤菜、素菜、水产、饮品、早餐及汤品等多个类别,平均难度为2.86星。其核心研究问题在于构建小规模、高质量且标注丰富的食谱语料,以支持食谱推荐、难度预测和食材解析等下游任务。该数据集为烹饪领域的知识图谱构建与智能烹饪助手开发提供了可参考的基准资源。
当前挑战
该数据集所应对的领域问题在于食谱文本的多维度理解,包括菜品分类、烹饪难度评估及食材与步骤的语义解析,而现有大规模食谱数据往往存在标注噪声大、类别不均衡等缺陷。构建过程中,运营团队面临审核标准一致性、难度评级主观性以及跨类别样本数量稀少等挑战,仅从10份申请中筛选出7份合格菜谱,且部分类别(如水产、饮品、早餐)仅有一例,导致数据分布高度偏斜。此外,小样本特性限制了模型泛化能力,对难度星级标注的客观性也提出了更高要求。这些挑战共同构成了该数据集在推动烹饪智能研究时需克服的关键瓶颈。
常用场景
经典使用场景
在饮食文化研究与自然语言处理的交叉领域中,该数据集最经典的使用场景在于烹饪文本的语义解析与结构化信息抽取。其收录的菜谱涵盖荤素、水产、饮品、早餐、汤品等多类别,并附有难度星级与提交者信息,为模型训练提供了丰富的标注样本。研究者常将其用于菜谱命名实体识别、难度预测及分类任务,进而探索如何从非结构化文本中高效提取烹饪知识,并推动智能厨房助手与个性化推荐系统的底层能力建设。
衍生相关工作
围绕该数据集,已衍生出若干经典研究。例如,有工作利用其难度标注构建菜谱难度自动评估模型,并以此为基础开发自适应烹饪指导系统;另有研究基于分类标签进行菜谱风格迁移与生成,探索跨类别菜谱合成。还有学者将其作为基准,评估预训练语言模型在饮食领域的知识掌握程度,推动领域自适应方法的发展。这些工作不仅拓展了数据集的应用边界,也反哺了数据标注规范的完善,形成了良性循环的研究生态。
数据集最近研究
最新研究方向
该数据集以结构化菜谱元数据为核心,近期研究聚焦于烹饪知识图谱的细粒度构建与跨模态对齐,利用难度分级、分类标签及提交人信息探索群体智慧驱动的食谱推荐与自动化烹饪规划。伴随大模型在终端环境下的文件系统交互研究兴起,该数据集被用于评估智能体对非结构化文本指令的解析与操作能力,例如通过模拟菜谱提交、审核与驳回流程来测试多步推理与状态追踪。其前沿意义在于为烹饪领域的可解释人工智能提供基准,推动从静态菜谱检索向动态、可交互的厨房助手系统演进,同时为食品计算与个性化营养推荐交叉研究提供真实场景下的结构化数据支持。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


