
遇见数据集

MCG-NJU/TimeLens2-93K

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

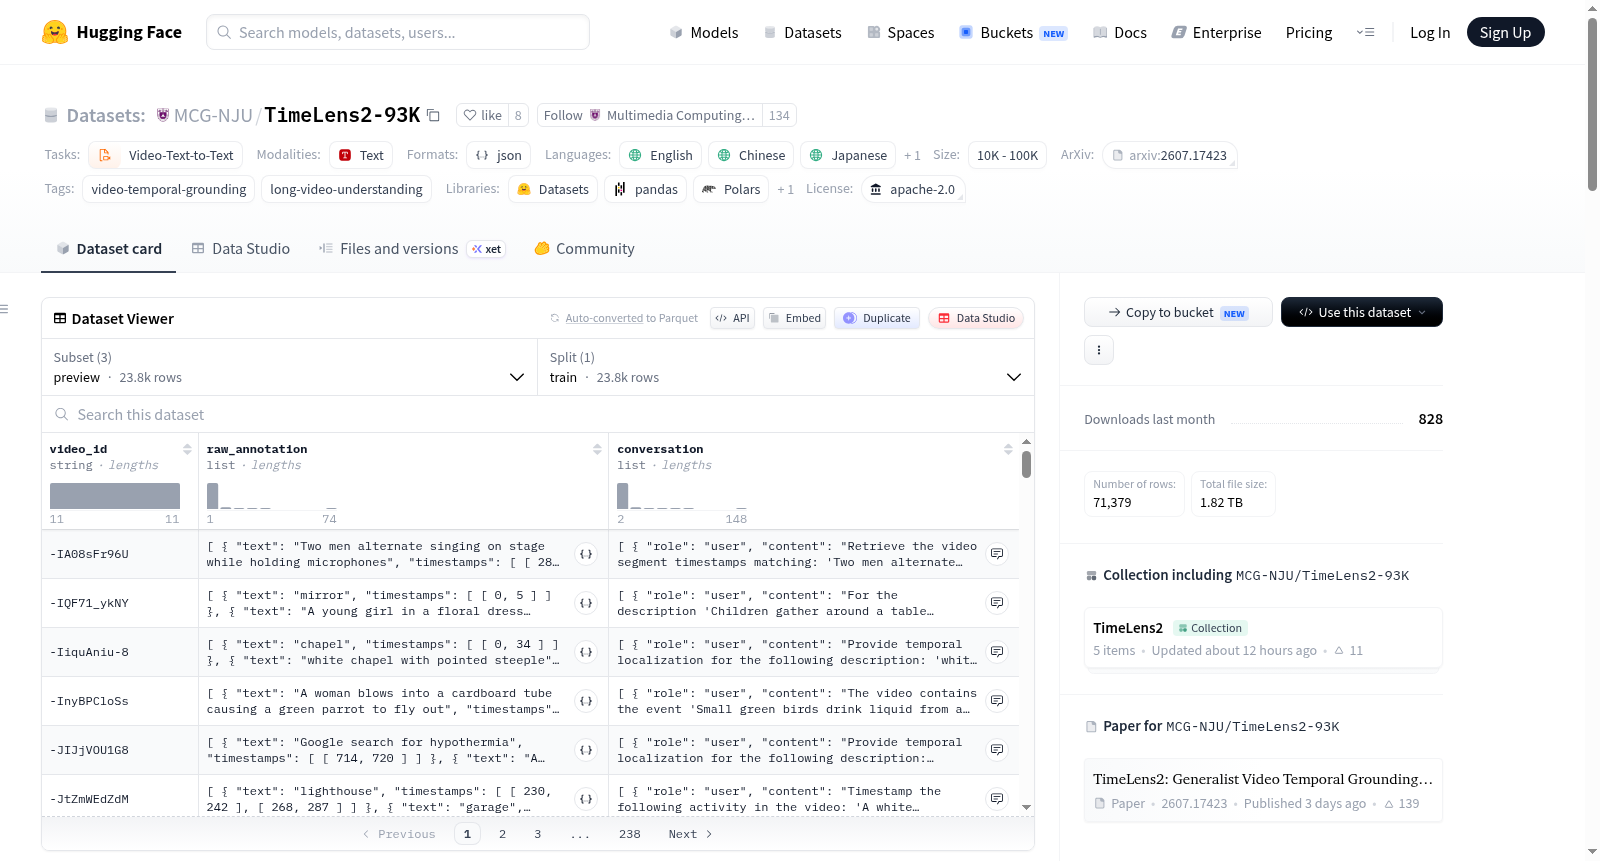
TimeLens2-93K是一个大规模、长视频时间定位数据集。该版本包含23,793个视频和93,232个文本-时间间隔对,其中包括12,091个多跨度对。视频时长从短片段到近100分钟不等,覆盖广泛的网络领域,如娱乐、教育、体育、新闻、科学技术、游戏、旅行、车辆、音乐和日常生活。TimeLens2-93K提供了规模、长上下文覆盖、多跨度监督和显式标签验证的罕见组合。我们希望它能为训练通用视频模型奠定坚实基础,这些模型能够搜索长时间轴、返回可审计证据,并在不同的定位指令之间转移,而不仅仅是记忆一种时间戳格式。

TimeLens2-93K is a large-scale, long-video temporal grounding dataset. This release contains 23,793 videos and 93,232 text–temporal interval pairs, including 12,091 multi-span pairs. The videos range from short clips to nearly 100 minutes and cover broad web domains such as entertainment, education, sports, news, science and technology, gaming, travel, vehicles, music, and daily life. TimeLens2-93K offers a rare combination of scale, long-context coverage, multi-span supervision, and explicit label verification. We hope it serves as a strong foundation for training generalist video models that can search long timelines, return auditable evidence, and transfer across grounding instructions instead of merely memorizing one timestamp format.
提供机构:
MCG-NJU
搜集汇总
数据集介绍
MCG-NJU/TimeLens2-93K 数据集图片
构建方式
TimeLens2-93K数据集是针对长视频时间定位任务构建的大规模资源,其构建过程融合了多阶段质量控制策略。首先,研究团队从互联网广泛采集涵盖娱乐、教育、体育、科技等领域的视频,时长从短片段延伸至近100分钟。随后,通过跨智能体协议、语义验证及边界聚焦精炼等互补阶段,对文本查询与时间区间的配对进行高置信度标注,尤其关注证据出现在不连续时刻的多区间场景。数据集最终产出23,793个视频与93,232对文本-时间区间,其中包含12,091对多区间标注,并提供了干净原始标注与多样化多轮SFT对话两种格式,以适配不同训练需求。
特点
TimeLens2-93K的核心特色在于其稀有的大规模、长上下文覆盖、多区间监督与显式标签验证的组合。视频内容横跨多个真实世界领域,确保数据多样性与泛化能力。该数据集专为多区间设计,允许标注包含可变数量的时间区间,从而捕捉重复出现的证据。通过严格的交叉验证机制,标签置信度得到显著提升,支持高保真度的训练。此外,数据集提供预览、原始标注和对话三种配置,其中对话格式包含多轮指令、多样化的答案语法与时间戳表示,为训练通用视频模型奠定了坚实基础,使其能够搜索长时间线、返回可审计证据并适应不同的时间定位指令。
使用方法
使用TimeLens2-93K时,开发者可通过Hugging Face Datasets库便捷加载三种配置子集,分别用于预览、原始标注和对话任务。具体而言,调用`load_dataset('MCG-NJU/TimeLens2-93K', split='train')`可直接获取训练数据。视频文件则需通过`huggingface_hub`下载18个分片压缩包,并解压至本地目录。对于模型训练,建议基于原始标注进行基础时间定位训练,或利用多轮对话格式进行指令微调,以增强模型对多样化查询和输出格式的适应能力。代码示例展示了如何加载各配置并解析JSON格式的标注信息,方便快速集成至现有视频理解流水线。
背景与挑战
背景概述
TimeLens2-93K是由南京大学媒体计算课题组(MCG-NJU)主导构建的大规模长视频时间定位数据集,于2026年公开发布。该数据集聚焦于视频时间定位这一多模态理解中的核心研究问题,旨在推动通用型视频模型的发展,使其能够基于文本查询在长达近100分钟的视频中精准定位时间区间。数据集包含23,793个视频与93,232个文本-时间区间对,覆盖娱乐、教育、体育、新闻、科技、游戏、旅行、车辆、音乐及日常生活等广泛网络领域。其发布为长视频理解与时间定位研究提供了珍贵的数据基础,在学术界与工业界均具有重要影响力,尤其为通用视频时间定位模型的训练与评估树立了新标杆。
当前挑战
TimeLens2-93K所针对的领域挑战在于:现有视频时间定位数据集多聚焦于短片段或单区间标注,难以支撑模型在复杂长视频中捕捉多区间、非连续的时间证据。该数据集通过引入多跨度(multi-span)标注机制,解决了视频中重复事件或分散证据难以被完整定位的难题。在构建过程中,最大的挑战在于如何确保大规模标注的准确性与一致性。研究团队通过跨智能体(cross-agent)标注一致性检查、语义验证以及边界精细化处理等多阶段质量控制流程,克服了标注噪声与边界模糊问题。此外,将自然语言查询与多种时间戳表示格式(如秒数、帧号、自然语言描述)融合为结构化对话数据,亦对数据处理与格式统一提出了极高要求。
常用场景
经典使用场景
TimeLens2-93K的核心使命在于推动大规模长视频时序定位领域的范式演进。该数据集囊括近2.4万段视频与超过9.3万条文本-时间区间配对,其中包含逾1.2万组多区间标注,覆盖娱乐、教育、体育、新闻、科技、游戏、旅行、音乐及日常生活等广泛网络领域。其经典使用场景是训练具备通用能力的视频时序定位模型,使模型能够在长达近100分钟的视频中精准检索与自然语言查询相匹配的片段,并支持返回可审计的时间证据。这种设计打破了传统数据集仅关注短片段或单一时间戳的局限,为构建能跨指令迁移的通用型视频理解智能体提供了坚实的数据基石。
解决学术问题
该数据集精准回应了视频理解领域长期面临的三大核心学术挑战:长视频理解、多区间时序定位以及跨指令泛化。传统数据集多局限于数分钟内的短视频,且标注形式单一,无法支撑对长达近100分钟视频中重复出现的事件进行多区间检索。TimeLens2-93K通过引入多区间标注设计,突破了单次事件锚定的边界,使模型能够理解“证据在多个不连续时刻复现”的复杂语义。其高质量的标注——经过跨智能体一致性校验、语义验证与边界精细化等多阶段质量控制——显著降低了标注噪声,为训练鲁棒、可迁移的时序定位模型提供了可靠基准。这一贡献有力推动了领域从“记忆单一时间戳格式”向“理解多样化时序指令”的深刻转变。
衍生相关工作
TimeLens2-93K的问世激发了多项基础模型与算法创新工作。其配套论文《TimeLens2: Generalist Video Temporal Grounding with Multimodal LLMs》系统展示了如何利用该数据集训练多模态大语言模型,使其具备强大的时序定位与跨任务泛化能力。数据集中精心设计的SFT对话格式(包含多轮指令、多样化的答案语法与时间戳表示)为后续指令微调范式提供了标准化模板。此外,该数据集的多区间标注特性催生了关于“稀疏-密集时序建模”和“注意力机制中时间窗聚合”的研究,推动了边界敏感的时序定位算法发展。同时,其长视频覆盖范围促进了高效视频表示学习与长程依赖建模的探索,成为评估模型时序推理能力的黄金基准。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

