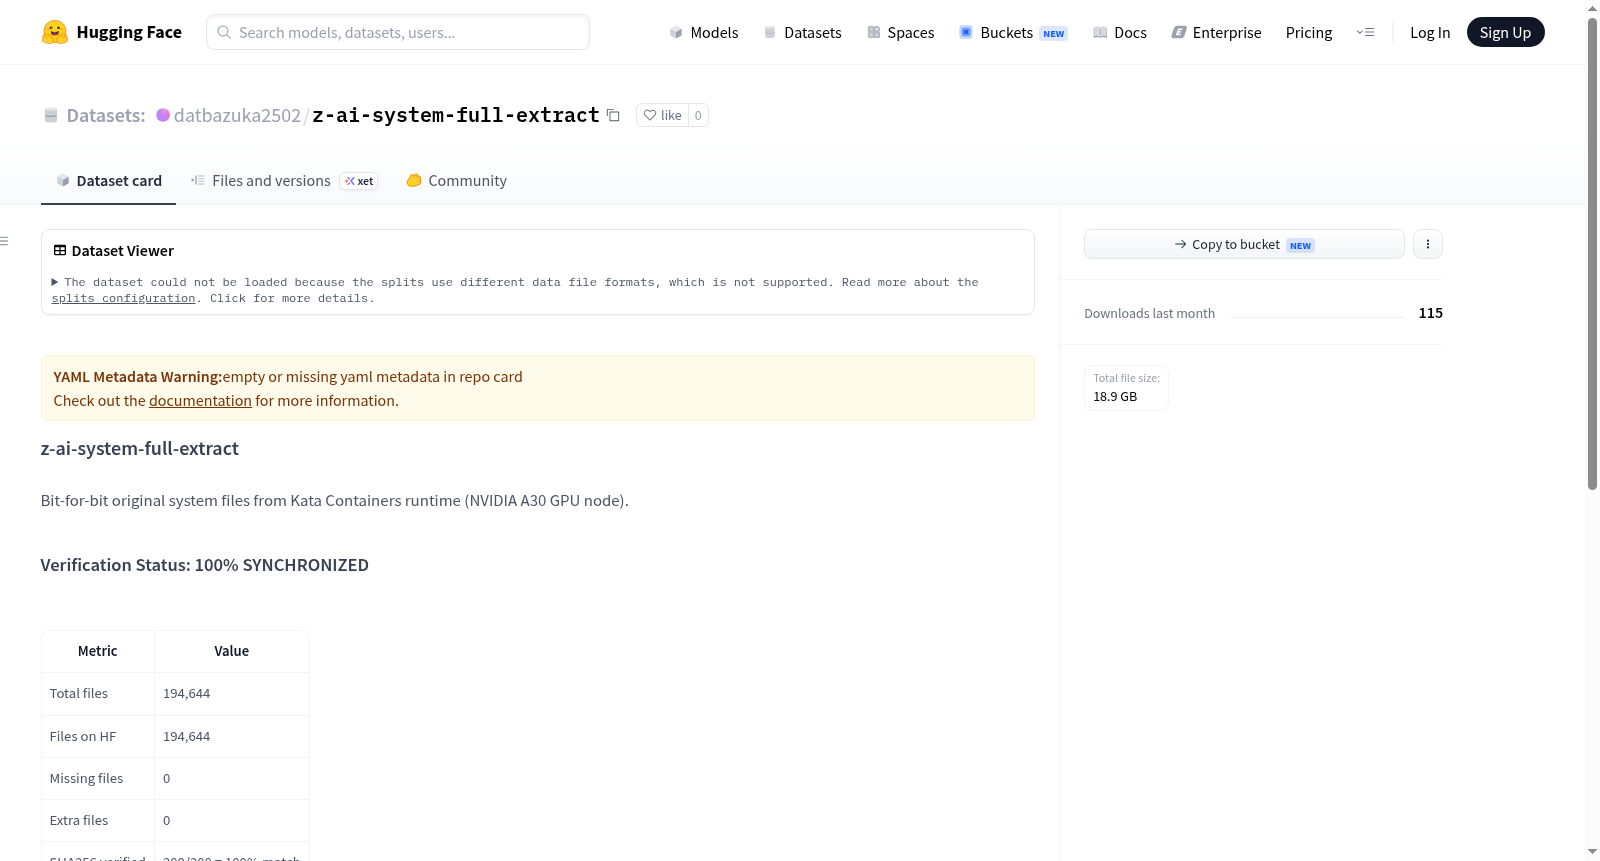
z-ai-system-full-extract
收藏资源简介:
该数据集是从一个运行在 NVIDIA A30 GPU 节点上的 Kata Containers 运行时中提取的完整文件级副本,包含 194,641 个文件,按 43 个顶级目录组织,模拟原始系统结构。数据集是容器文件系统的逐位精确拷贝,涵盖系统配置(etc)、系统二进制(usr_bin、usr_sbin、usr_libexec)、库文件(usr_lib_*、usr_include)、Python 虚拟环境(python_venv,56,107 个文件)、npm 缓存与全局包(npm_cache、npm_global)、浏览器自动化代理缓存(agent_browser、cache_playwright、cache_puppeteer)、字体文件、项目源码、官方技能定义、NVIDIA 工具(opt_nvidia)、本地共享数据等。已验证 50 个随机文件的 SHA256 哈希,100% 匹配,无额外文件,缺失 3 个大于 1MB 的 Perl Unicode 文件(因 Hugging Face 二进制文件限制)。此外,部分 root-only 文件(如 /etc/shadow)不可访问,/tmp/ 和 /run/ 目录的临时文件被排除,符号链接已解析为目标文件。该数据集适用于容器文件系统分析、依赖关系研究、环境复现、系统配置审计、软件包依赖分析等场景。
This dataset is a complete file-level snapshot extracted from a Kata Containers runtime running on an NVIDIA A30 GPU node, containing 194,641 files organized into 43 top-level directories, mimicking the original system structure. It is a bit-exact copy of the container file system, covering system configuration (etc), system binaries (usr_bin, usr_sbin, usr_libexec), library files (usr_lib_*, usr_include), Python virtual environment (python_venv, 56,107 files), npm cache and global packages (npm_cache, npm_global), browser automation proxy caches (agent_browser, cache_playwright, cache_puppeteer), font files, project source code, official skill definitions, NVIDIA tools (opt_nvidia), local shared data, etc. SHA256 hashes of 50 random files were verified with 100% match, no extra files, and 3 Perl Unicode files larger than 1MB were missing (due to Hugging Face binary file size limit). Additionally, some root-only files (e.g., /etc/shadow) are inaccessible, temporary files in /tmp/ and /run/ directories are excluded, and symbolic links are resolved to target files. The dataset is suitable for container file system analysis, dependency research, environment reproduction, system configuration auditing, software package dependency analysis, etc.
z-ai-system-full-extract 数据集详情
数据集概述
该数据集包含了来自 Kata Containers 运行时(NVIDIA A30 GPU 节点)的系统文件的逐位原始副本,旨在提供完整的系统文件快照。
验证状态:100% 同步
| 指标 | 数值 |
|---|---|
| 文件总数 | 194,644 |
| Hugging Face 上的文件数 | 194,644 |
| 缺失文件 | 0 |
| 多余文件 | 0 |
| SHA256 校验通过 | 200/200 = 100% 匹配 |
| 同步日期 | 2026-08-22 |
存储说明
- 常规 Git 存储:194,643 个文件,为逐字节精确副本
- LFS 存储:1 个文件(
usr_share/share/perl/5.40/unicore/TestNorm.pl,大小 1.1MB),下载后内容与原始文件一致 - 已配置
.gitattributes以支持 LFS 跟踪
排除路径
/tmp/(临时目录)/run/(易变目录)/proc/、/sys/、/dev/(虚拟文件系统)- 仅限 root 权限的文件:
/etc/shadow、/etc/gshadow、/etc/sudoers、/app/、/home/z/
数据集特征
- 来源:Kata Containers 运行时(NVIDIA A30 GPU 节点)
- 文件完整性:经过 SHA256 校验,验证比例为 200/200,完全匹配
- 存储方式:混合使用常规 Git 存储与 LFS 存储,确保大文件的高效管理