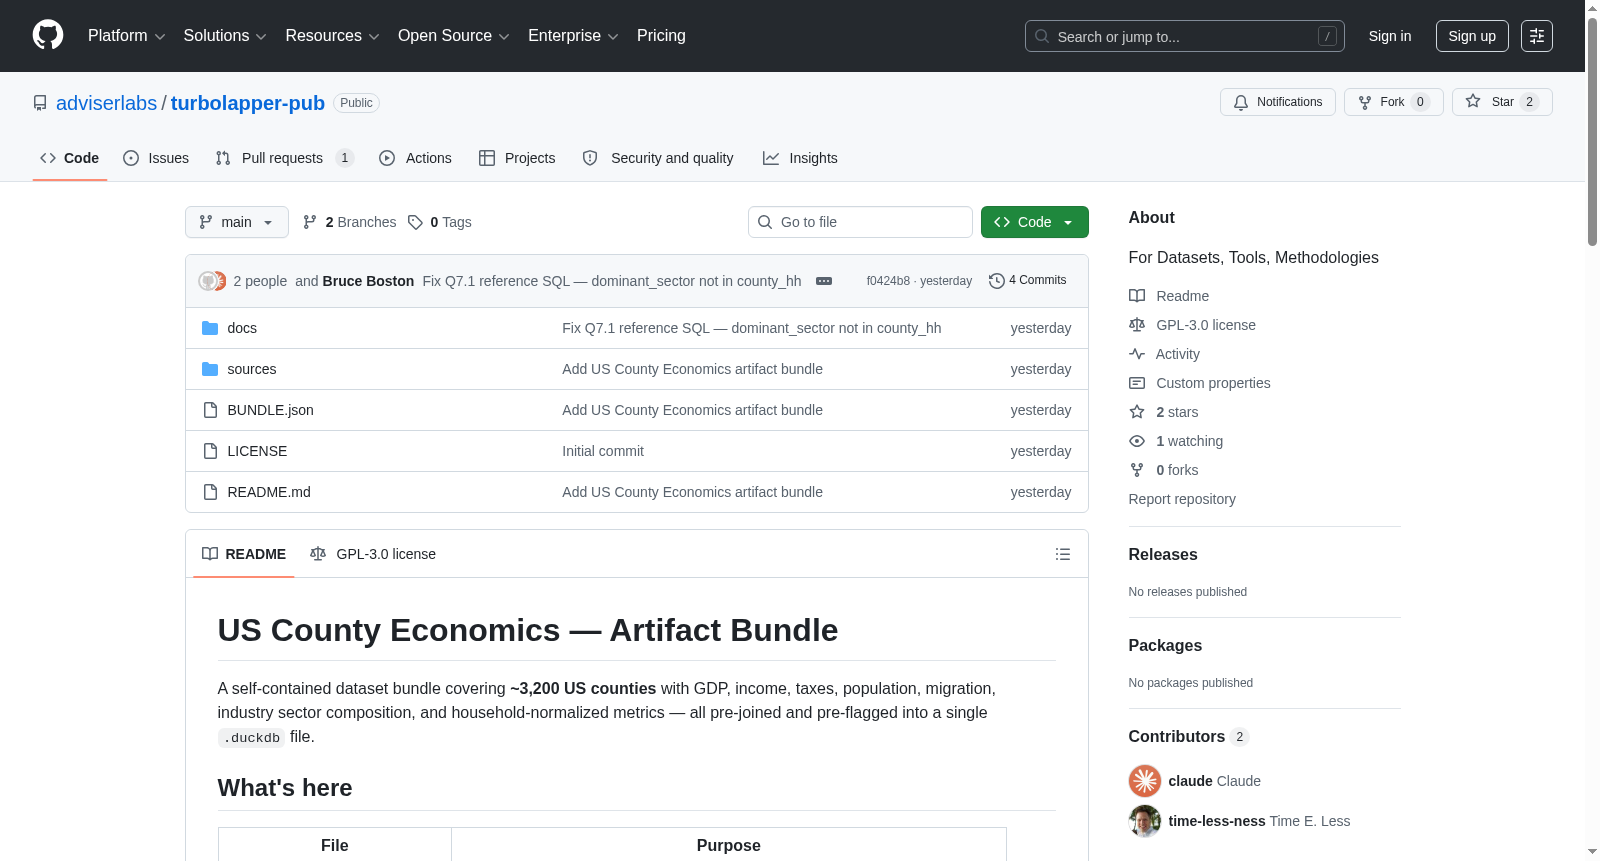
US County Economics — Artifact Bundle
收藏资源简介:
一个自包含的数据集包,涵盖约3,200个美国县,包含GDP、收入、税收、人口、迁移、行业部门构成和家庭标准化指标,所有数据已预先连接并标记到单个.duckdb文件中。数据源来自美国政府的公共领域数据,包括BEA、IRS和Census,构建为奖章架构(原始→策划→语义),最终生成多个语义表,如county_all_flags、county_hh等,用于LLM查询和分析。
A self-contained dataset package covering approximately 3,200 U.S. counties, which includes GDP, income, tax revenue, population, migration, industrial sector composition, and household standardized metrics. All data has been pre-joined and labeled into a single .duckdb file. The data sources are public-domain datasets from U.S. federal government agencies including BEA, IRS, and Census. Built on the Medallion Architecture (raw → curated → semantic), the package ultimately generates multiple semantic tables such as county_all_flags, county_hh, etc., for LLM-based querying and analysis.
数据集概要
US County Economics — Artifact Bundle 是一个面向约3,200个美国县的综合性经济数据集,整合了GDP、收入、税收、人口、迁移、行业构成及家庭标准化指标,预连接并标注后打包为单一 .duckdb 文件。
数据来源与覆盖范围
- BEA CAGDP2: 县级GDP与行业数据,2001–2024年,覆盖3,126个县。
- BEA CAINC1: 个人收入、人口、人均收入,1969–2024年,覆盖3,148个县。
- IRS Statistics of Income: 调整后总收入与工资数据,2015–2022年,覆盖3,203个县。
- Census Population Estimates Program: 人口与迁移数据,2020–2024年,覆盖3,143个县。
数据架构
采用 medallion架构(raw → curated → semantic),主要语义表格包括:
- semantic.county_all_flags: 96列宽表,每县每年一行,包含所有指标及55+布尔标志。
- semantic.county_hh: 家庭标准化指标(如收入、工资、每报税单位GDP),便于城乡比较。
- semantic.county_industry_flags: 行业份额及主导标志,基于BEA NAICS代码。
- semantic.county_migration: 国内及国际迁移流量。
标志体系
布尔标志预先回答常见问题,分为三类:
- NULL: 数据不可用(区分未知与否定)。
- 相对标志: 基于排名(如年度内前四分位)。
- 绝对标志: 基于结构阈值(如工资份额、迁移方向)。
示例标志:
is_boomtown(繁荣城镇)、is_left_behind(落后地区)、is_energy_dominant(能源主导)、is_commuter_county(通勤县)、is_domestic_migration_magnet(国内迁移磁石)、is_investment_hh_county(投资家庭县)。
使用方式
- LLM查询: 向LLM提供
.duckdb文件及BUNDLE.json清单(含提示字段)。 - 示例代码(Python): python import duckdb con = duckdb.connect("turbolapper.duckdb", read_only=True) con.execute(""" SELECT county_name, state_fips, ROUND(yoy_gdp_growth_pct, 1) AS gdp_growth, ROUND(yoy_pop_growth_pct, 2) AS pop_growth, dominant_sector FROM semantic.county_all_flags WHERE year = 2022 AND is_boomtown IS TRUE ORDER BY yoy_gdp_growth_pct DESC LIMIT 10 """).df()
文档与扩展
- BUNDLE.json: 机器可读清单,含来源、表格、年份范围、LLM提示。
- docs/SCHEMA_REFERENCE.md: 所有表格与列描述。
- docs/GEO_CATALOG.md: 地理参考(FIPS代码、州表、CPI都市区)。
- docs/TEST_QUESTIONS.md: 55个规范问题及参考SQL。
- docs/KNOWN_UNKNOWNS.md: 已知缺失标志与数据源优先级(如Census SAIPE贫困率、USDA城乡连续代码、BLS失业率、BEA区域价格平价)。
构建与许可
- 构建: 使用 turbolapper引擎(
uv run turbolapper ingest,约2-3 GB下载)。 - 许可证: 构建代码为MIT;数据为公共领域(美国政府数据:BEA、IRS、Census Bureau)。