
遇见数据集

jaddai/openart-painterly-foundations

收藏
Hugging Face2026-05-28 更新2026-05-31 收录
官方服务:

资源简介:

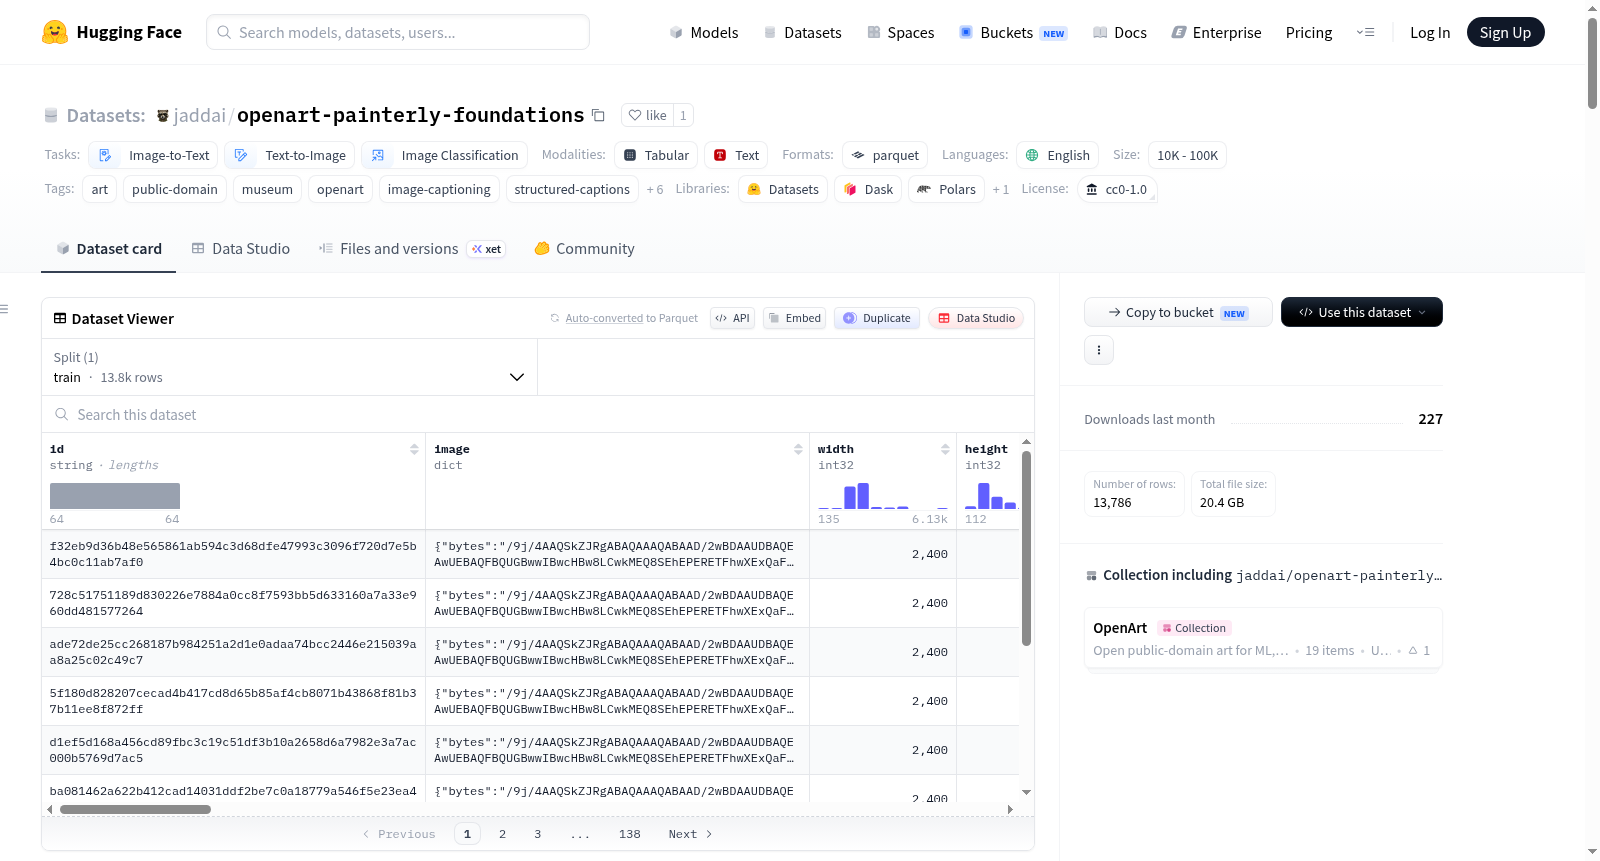
OpenArt — Painterly Foundations 是 OpenArt 系列开放公共领域艺术数据集中的一个主题集合,专注于“绘画基础”。该数据集包含 13,786 件作品(9,107 幅绘画/插图、4,596 张拍摄的物体照片、83 件未分类作品),每件作品都配有一个结构化的视觉语言模型(VLM)描述,以及媒介、归属和铭文元数据。数据来源于大都会艺术博物馆、荷兰国立博物馆、克利夫兰艺术博物馆、芝加哥艺术学院、史密森尼学会、Europeana、维基媒体等主要博物馆和图书馆的开放访问 API。与纯绘画的 OpenBrush 语料库不同,每个 OpenArt 主题集合都是混合媒介的,包含二维艺术(绘画、版画、素描)和三维物体(雕塑、陶瓷、金属制品、纺织品)的照片。数据集通过 `brand` 列(`openbrush` 表示二维艺术,`openartifacts` 表示物体照片)进行分割,以便用户按需选择。关键特征包括:所有图像均通过 `rights_status: safe` 检查,为公共领域;提供结构化的 v2 描述(包含 9 个语义部分);具有媒介标记和归属意识(3,772 行有署名艺术家,其中 3,177 行经过签名验证);采用 CC0-1.0 许可(公共领域奉献,无保留权利);每行数据均包含完整的来源信息(`source`、`landing_page`、`sha256`)。

OpenArt draws from the open-access APIs of major museums and libraries (the Metropolitan Museum of Art, Rijksmuseum, Cleveland Museum of Art, Art Institute of Chicago, Smithsonian, Europeana, Wikimedia and others). Unlike the painting-only OpenBrush corpus, each OpenArt subject collection is mixed-medium: it contains both 2-D art (paintings, prints, drawings) and photographs of three-dimensional objects (sculpture, ceramics, metalwork, textiles). A `brand` column splits every row so you can take exactly the slice you want.
提供机构:
jaddai
搜集汇总
数据集介绍
jaddai/openart-painterly-foundations 数据集图片
构建方式
OpenArt-Painterly Foundations 数据集源自多个国际顶级博物馆与图书馆的开放获取API,包括大都会艺术博物馆、荷兰国家博物馆、克利夫兰艺术博物馆、芝加哥艺术学院及史密森尼学会等。该数据集汇集了13,786幅公共领域图像,涵盖9,107件二维艺术作品与4,596件三维实物摄影,并通过严格的版权合规筛选确保每件作品均为CC0许可。数据构建采用双模型视觉管线:首先由Gemma 4 31B生成包含九大语义段落的结构化描述,随后由Gemini 3 Flash进行第二轮验证,对媒介、归属和铭文信息进行像素级重新校准,最终形成兼具丰富性与可靠性的标注体系。
使用方法
用户可通过Hugging Face的datasets库便捷加载该数据集,使用load_dataset函数即可获取完整训练集。利用filter方法可基于brand字段分离二维艺术作品与实物摄影,或通过signature_verified条件筛选可信归属的作品。medium字段支持按具体媒介进行细粒度检索,例如过滤出雕塑类样本。该数据集适用于扩散模型微调、视觉语言模型训练、媒介分类任务以及跨媒介主题对比研究。需要注意的是,AI生成的描述并非策展级真实数据,艺术家归属仅当signature_verified为True时方可视为权威,铭文信息应以inscription_verified字段为可靠依据。
背景与挑战
背景概述
OpenArt—Painterly Foundations 数据集由 jaddai 于2026年创建,隶属于 OpenArt 数据集家族,旨在为艺术领域的人工智能研究提供高质量、开放获取的视觉素材。该数据集汇集了来自大都会艺术博物馆、荷兰国家博物馆、克利夫兰艺术博物馆、芝加哥艺术学院及史密森尼学会等顶级博物馆与图书馆的13,786件公共领域作品,涵盖绘画、版画、素描、蚀刻及历史摄影等多种媒介。其核心研究问题聚焦于利用结构化视觉语言模型(VLM)标注,将多元化的艺术品特征——包括风格、构图、媒介、艺术家归属及题字信息——系统化编码,以支撑图像生成、文本到图像合成及图像分类等下游任务。作为混合媒介数据集,它特别关注二维艺术与三维文物摄影的对比研究,为跨媒介艺术理解与模型训练提供了独特的资源。
当前挑战
该数据集面临的挑战体现在领域问题与构建过程两个层面。在领域层面,艺术图像的高维语义特征(如风格细微差异、媒介识别、艺术家归属)对现有视觉模型构成严峻考验,尤其是非西方艺术传统的代表性不足与西方经典馆藏偏见,限制了模型的泛化能力。结构化标注虽已涵盖九类语义维度,但AI生成的描述性元数据并非策展级真值,艺术家归属仅当签名验证为真时才具权威性,否则仅为学术推测。构建过程中,多源馆藏数据的版权一致性保障极为复杂,需严格筛选CC0协议素材以规避聚合器来源的不确定性;此外,双模型架构(Gemma 4进行初始标注与路由,Gemini 3 Flash实施验证)虽提升了准确性,却在签名与题字的像素级重确认中面临可读性与歧义性的持续挑战,部分标注因图像质量问题而无法被二次验证所证实。
常用场景
经典使用场景
在数字人文与计算机视觉的交叉领域中,OpenArt-Painterly Foundations数据集凭借其混合媒介特性与结构化描述,成为训练视觉语言模型和理解艺术技法的理想资源。研究者常利用其“brand”列分离二维绘画与三维器物图像,进而针对油画、蚀刻、素描等具体媒介微调扩散模型,或通过九段式结构化标题开展图像描述生成任务,推动艺术领域多模态理解的前沿探索。
解决学术问题
该数据集有效回应了艺术史研究中长期存在的两大难题:一是缺乏大规模、高质量且附带细粒度语义标注的公共领域艺术图像库;二是跨媒介(二维与三维)的艺术品比较研究常受限于数据割裂。OpenArt-Painterly Foundations通过提供混合媒介、签名验证及铭文可追溯性,使学者能够量化分析同一主题在不同技法下的视觉表达差异,并借助机器可读的归属信息,降低艺术鉴定与流派分类研究中的人工偏见。
实际应用
在实际场景中,这一数据集的价值延伸至文化遗产数字化与创意产业。博物馆可将其用于构建智能导览系统,通过结构化标题自动生成多语种展品解说;设计教育领域则利用其丰富的技法标签,为数字绘画教学提供临摹范本;此外,生成式AI开发者可基于该数据的CC0许可,安全地训练面向特定艺术风格(如木刻、蚀刻)的图像生成模型,从而推动个性化艺术创作工具的商业落地。
数据集最近研究
最新研究方向
openart-painterly-foundations 数据集作为 OpenArt 家族的核心组成部分,近期研究前沿聚焦于利用其混合媒介(二维绘画与三维器物摄影)和结构化 VLM 描述,推动艺术领域的多模态生成与理解研究。该数据集包含 13,786 幅公有领域作品,配备九段式语义标注、媒介标签及签名验证元数据,为扩散模型与视觉语言模型的微调提供了高质量的跨媒介训练基础。结合博物馆开放获取运动与 AI 生成内容的可解释性议题,该资源在图像分类、跨媒介风格迁移及数字人文领域具有里程碑意义,尤其促进了艺术史计算分析与生成式 AI 伦理规范的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

