Gym_Salesman_Dataset
收藏资源简介:
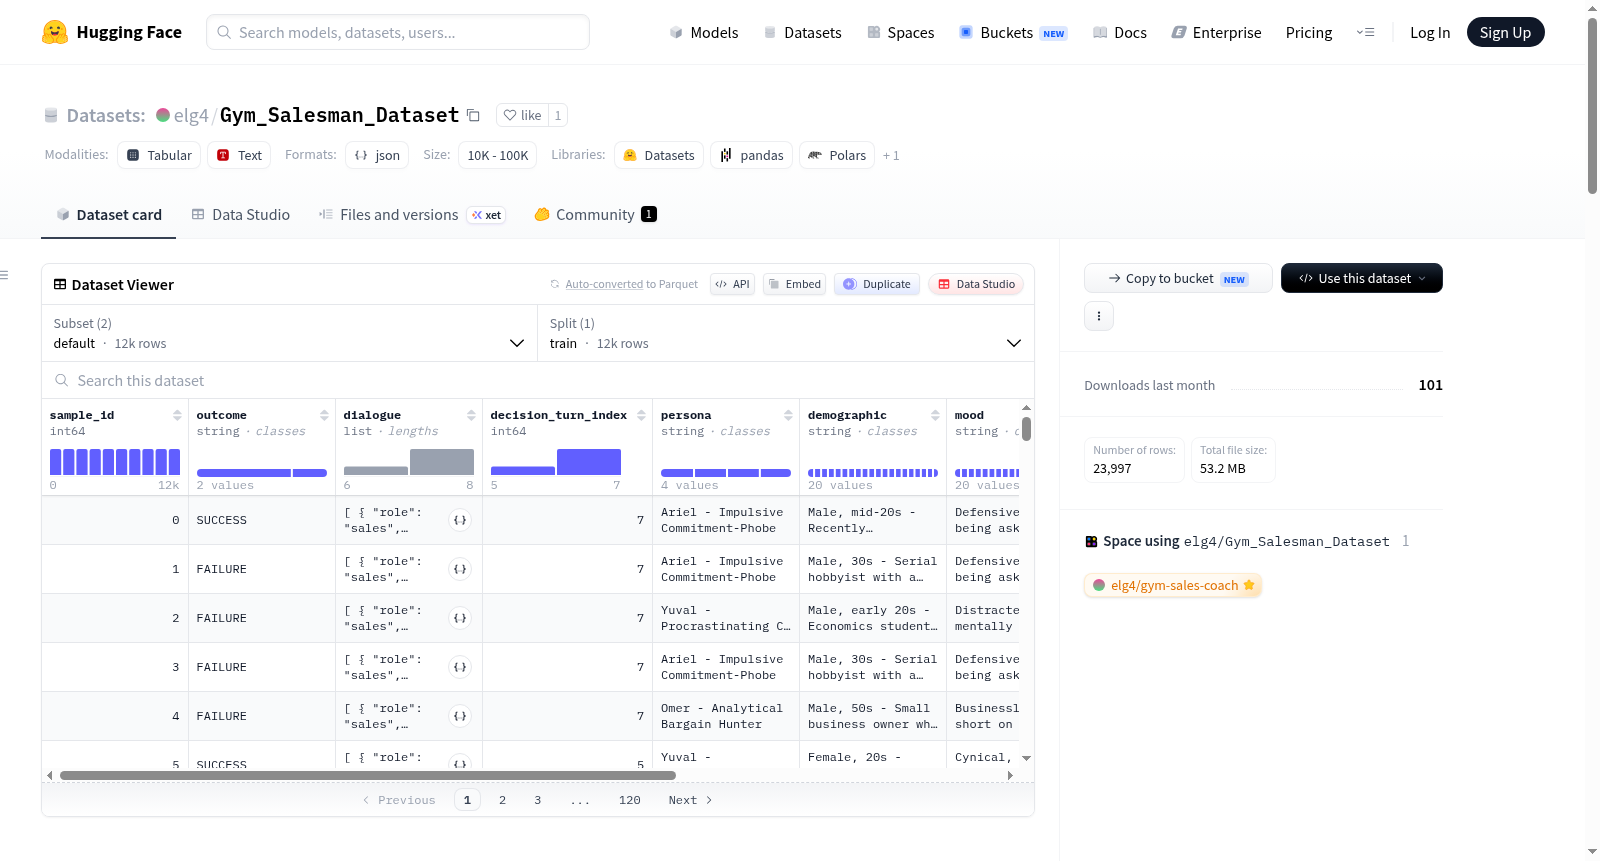
Gym Salesman Dataset 是一个用于文本分类任务的合成数据集,包含 12,000 个(去重后 11,997 个)健身会员销售对话,每个对话被标记为 SUCCESS(成功)或 FAILURE(失败)。数据集旨在让模型学习真实的销售动态——即哪些行为能促成交易——而非利用快捷方式。标签是通过模拟过程自然涌现的:销售员根据隐藏的技能水平行动,客户提出隐藏的异议,独立的评估者模型在对话结束后判断每个异议是否被解决,最终根据解决的异议数量是否达到说服阈值来确定标签。该过程确保了标签是模拟的输出而非输入,避免了标签泄露。数据集包含以下字段:sample_id(唯一ID)、outcome(目标标签)、dialogue(对话轮次列表,包含角色和文本)、decision_turn_index(最终决策轮次索引)、persona(四种原型之一)、demographic(基于原型的描述)、mood(基于原型的情绪)、gym(六种健身房值之一)、price(五种价格值之一)、n_turns(对话轮次,6或8)。此外,还有一个单独的元数据文件包含潜在状态(如技能水平、每个异议是否被解决),仅用于分析,绝不可作为模型特征。数据集大小约为 10K-100K 样本,语言为英文,许可证为 MIT。EDA 显示技能水平与成功率正相关,且标签是涌现的;泄漏审计表明无法通过文本风格作弊;评估者验证显示评估者比人类更严格但并非噪声。已知局限性包括单一生成模型风格、评估者与生成器同属一个系列、客户过度礼貌、事实幻觉、异议提及率约 80%、仅有4种原型。适用任务包括销售对话的早期结果预测、销售辅导、相似对话推荐和异议处理分析。
Gym Salesman Dataset is a synthetic dataset for text classification, containing 12,000 (11,997 after deduplication) gym membership sales dialogues, each labeled as SUCCESS or FAILURE. The dataset aims to teach models real sales dynamics—what behaviors lead to a deal—rather than shortcuts. Labels emerge naturally from a simulation process: the salesperson acts based on a hidden skill level, the customer raises hidden objections, an independent evaluator model judges after the dialogue whether each objection is resolved, and the final label is determined by whether the number of resolved objections reaches a persuasion threshold. This ensures labels are outputs of simulation, not inputs, avoiding label leakage. Fields include: sample_id, outcome, dialogue (list of turns with role and text), decision_turn_index, persona, demographic, mood, gym, price, n_turns. A separate metadata file contains latent states (e.g., skill level, each objection resolved) for analysis only, not as model features. Dataset size is approximately 10K-100K samples, language is English, license is MIT. EDA shows skill level positively correlates with success; leakage audit indicates no text style cheating; evaluator validation shows evaluators are stricter than humans but not noisy. Known limitations include single generator style, same model family for evaluator and generator, overly polite customers, factual hallucinations, ~80% objection mention rate, only 4 personas. Applicable tasks include early outcome prediction for sales dialogues, sales coaching, similar dialogue recommendation, and objection handling analysis.
数据集概述
Gym Salesman Dataset 是一个包含 12,000 条(去重后 11,997 条)合成健身房会员销售对话的数据集,每条对话被标记为 SUCCESS(成功)或 FAILURE(失败)。每条对话由销售员(具有隐藏技能水平)与客户(具有隐藏反对意见)之间的双智能体交互生成,结果由独立的评估模型根据销售员是否解决了每条反对意见来判定,而非由提示词预先指定。
构建方法
- 生成器:
Qwen/Qwen2.5-3B-Instruct(逐轮生成对话,基于 vLLM) - 评估器:
Qwen/Qwen2.5-7B-Instruct(独立的更强模型,减少自我评估偏差) - 阶段A: 在生成任何文本之前,先采样所有潜在状态(角色、人口统计特征、情绪、隐藏反对意见、技能、健身房、价格、对话长度)
- 阶段B: 逐轮生成对话,销售员看不到反对意见或结果,客户被告知“尚未做出决定”
- 阶段C: 评估器阅读完整对话记录,根据书面的
resolves_when标准判断每条反对意见是否被解决 - 阶段D: 若已解决的反对意见数量 ≥ 说服阈值,则
label = SUCCESS,否则为FAILURE;没有模型被要求直接输出 SUCCESS/FAILURE - 阶段E: 最后的客户发言将决定口头化
数据模式
| 字段 | 类型 | 说明 |
|---|---|---|
sample_id |
int | 唯一标识 |
outcome |
string | SUCCESS / FAILURE(目标变量) |
dialogue |
list | 包含 {role, text} 的交替对话(销售员 → 客户) |
decision_turn_index |
int | 最终决定轮次的索引 |
persona |
string | 4 种原型(Yuval, Omer, Ariel, Noam) |
demographic |
string | 基于 persona 条件生成 |
mood |
string | 基于 persona 条件生成 |
gym |
string | 6 种取值 |
price |
string | 5 种取值 |
n_turns |
int | 6 或 8 |
单独的元数据文件包含潜在状态(技能水平、已解决哪些反对意见),该文件绝不应作为模型特征使用,它仅用于分析,因为标签由其确定性决定。
关键发现(EDA)
- 技能驱动结果: 技能水平独立于客户难度采样,但 SUCCESS 率随技能单调上升(新手 22.8%,普通 28.3%,专家 30.9%),验证了“技能 → 反对意见解决 → 结果”的链条是涌现的而非注入的。
- 泄漏审计: 基于 TF-IDF 和逻辑回归的分类器在销售员回合(排除最终推销)上仅达到 64%(6轮)/ 69%(8轮)的准确率,接近或低于多数类基线,表明不存在风格指纹可被利用。
- 评估器验证: 人工盲标 46 条反对意见判断,与评估器原始一致性 54%,Cohens κ = 0.22,分歧是单向的(人类更宽容),评估器系统性更严格,符合设定的标准。
- 类别平衡: SUCCESS 占比 27.4%,为涌现结果而非强制设定,建议使用
class_weight=balanced处理。
已知局限
- 单一生成模型 —— 所有文本带有同一模型的风格指纹。
- 评估器与生成器同源 —— 通过使用更大的 7B 模型作为评判者及 κ 检验来缓解,但未完全消除。
- 过度礼貌(20.1% 的客户回合) —— 客户有时违反指令感谢销售员,仅影响外观。
- 事实幻觉(0.65% 的销售员回合) —— 偶发编造术语(如与事实表矛盾的费用或货币错误)。
- 反对意见表达检测约 80% 基于关键词匹配 —— 是最低限度,间接表达会被漏掉。
- 仅 4 种 persona —— 是多样性最薄弱的维度。
预期用途
用于训练和评估销售辅导的早期结果预测、相似对话推荐以及反对意见处理分析。注意: 不要将最终决定轮次输入给用于预测结果的模型,因为它直接陈述了决定。