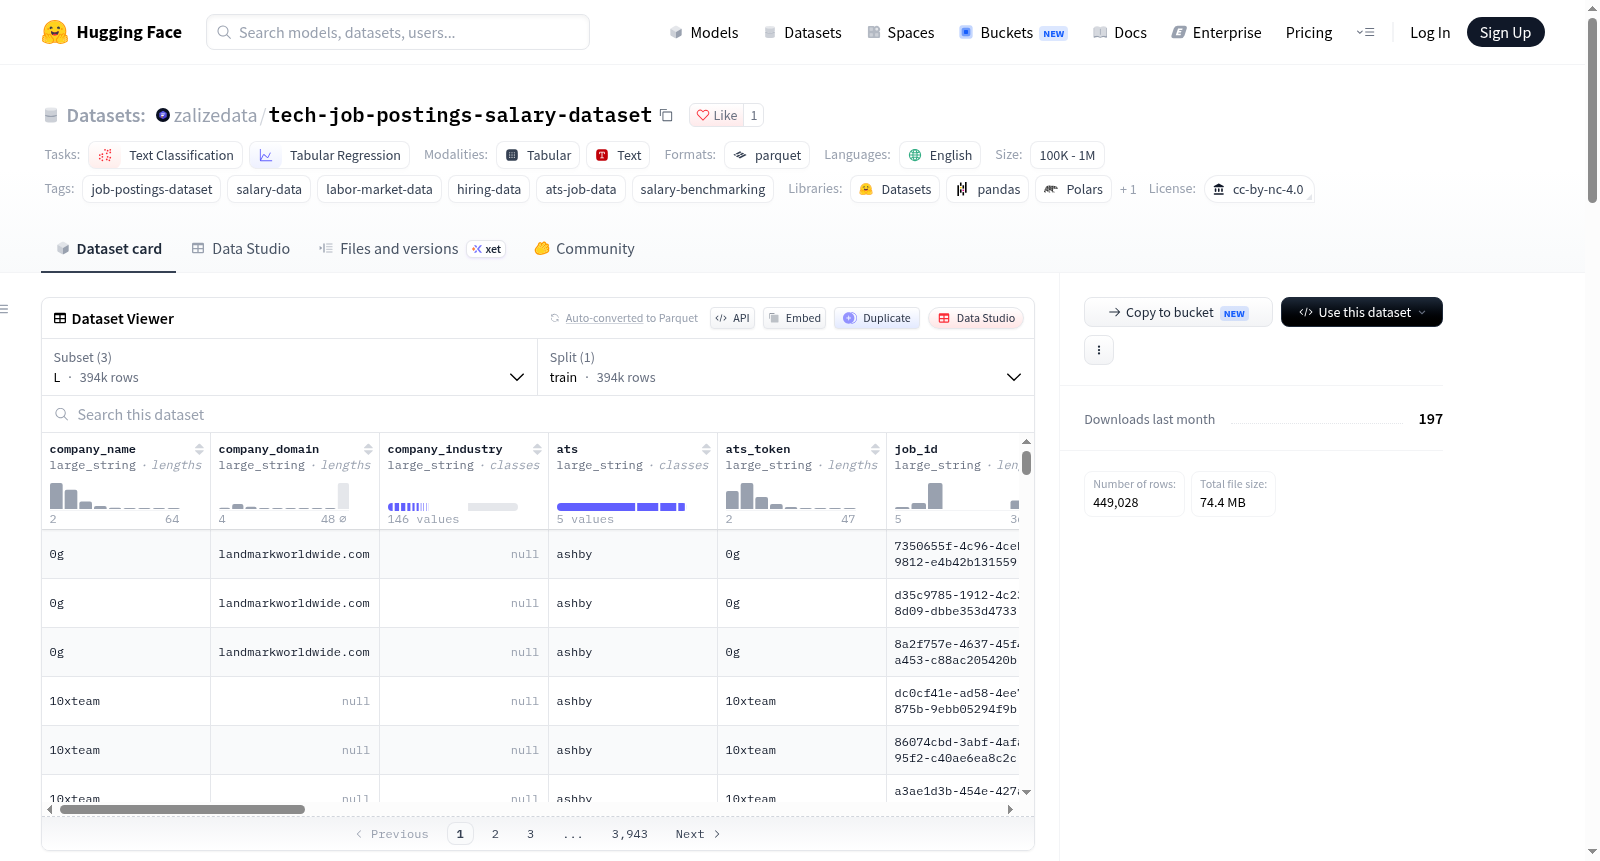
tech-job-postings-salary-dataset
收藏资源简介:
该数据集提供了超过 390,000 条来自美国及欧盟科技公司的技术职位发布信息,数据直接从 Greenhouse、Lever、Ashby、Workable 和 SmartRecruiters 等公共 ATS 端点收集。每条记录包含结构化的薪资范围(已解析的最低/最高薪资、货币和周期)、资历级别、远程政策以及提取的技术栈标签。数据还包含每条记录的数据来源 URL 和收集时间戳。数据集分为三个规模层级:S(约 35,417 条)、M(约 19,311 条)和 L(约 394,300 条),以 Parquet 格式提供。适用于 HR 科技创始人进行薪资范围基准测试、风险投资和量化团队跟踪招聘速度作为替代增长信号、研究人员研究劳动力市场趋势、以及招聘机构识别特定领域积极招聘的公司。该数据集基于 CC BY-NC 4.0 许可证发布,学术和个人使用免费,商业使用需获得 DataForge 商业许可证。
数据集概述
数据集名称:390,000+ Tech Job Postings with Parsed Salaries — Monthly Snapshot
数据集链接:https://huggingface.co/datasets/zalizedata/tech-job-postings-salary-dataset
1. 数据集简介
该数据集包含超过 390,000 条科技行业职位招聘信息,数据直接采集自美国及欧盟科技公司的公开 ATS(申请人追踪系统)端点(包括 Greenhouse、Lever、Ashby、Workable、SmartRecruiters)。数据集提供了结构化的薪资范围、资历级别和技术栈字段,并以干净的 CSV/Parquet 格式交付。
该数据集是 DataForge 开放数据计划的一部分,完整数据包免费供学术和个人使用。
2. 数据规模与配置
| 配置名称 | 数据文件路径 | 说明 |
|---|---|---|
S |
data/S/jobs-*.parquet |
小型数据集 |
M |
data/M/jobs-*.parquet |
中型数据集 |
L |
data/L/jobs-*.parquet |
大型数据集(完整数据) |
规模类别:100K < n < 1M
3. 数据包清单
| 数据包 | 级别 | 行数 | 大小 |
|---|---|---|---|
jobs-tier1-S-2026-08-01.zip |
S | 35,417 | 4.5 MB |
jobs-tier1-M-2026-08-01.zip |
M | 19,311 | 2.4 MB |
jobs-tier1-L-2026-08-01.zip |
L | 394,300 | 38.5 MB |
4. 数据集内容与字段
- 390,000+ 条职位招聘信息,来自 6,500+ 家公司
- 结构化薪资字段(已解析的最小/最大薪资、货币、薪资周期)
- 资历级别、远程办公政策、技术栈标签
- 每条记录包含来源 URL 和采集时间戳(数据溯源)
- 包含完整的数据字典、数据说明文档(来源、方法、已知限制)和许可证
5. 应用场景
- HR 科技创业者:按职位、技术栈和地域基准化薪资范围
- VC 与量化团队:追踪招聘速度,作为替代增长信号
- 研究人员:使用时间点职位数据研究劳动力市场趋势
- 招聘机构:识别在特定领域积极招聘的公司
6. 数据来源与方法论
数据采集自公开的 ATS 招聘公告板(Greenhouse、Lever、Ashby、Workable、SmartRecruiters),并对结构化字段进行解析。
7. 许可协议
- 学术/个人使用:采用 CC BY-NC 4.0 许可证,需注明出处并回链至 https://data.zalize.com
- 商业使用:需要 DataForge 商业许可证
- 上游许可证条款仍适用于底层数据
8. 引用方式
text DataForge (data.zalize.com) — https://data.zalize.com/datasets/tech-job-postings-salary-dataset
DOI(Zenodo 镜像):10.5281/zenodo.21813354 · GitHub Release 镜像:https://github.com/wookat/dataforge-pipelines/releases/tag/open-data-tech-jobs
9. 使用方法(Python 示例)
python from datasets import load_dataset
ds = load_dataset("zalizedata/tech-job-postings-salary-dataset", "S", split="train") print(ds[0])
可用配置:S、M、L。
10. 相关数据集
完整目录(25 个数据集):https://data.zalize.com/open-data