
philschmid/easyrag-mini-wikipedia
收藏官方服务:
资源简介:
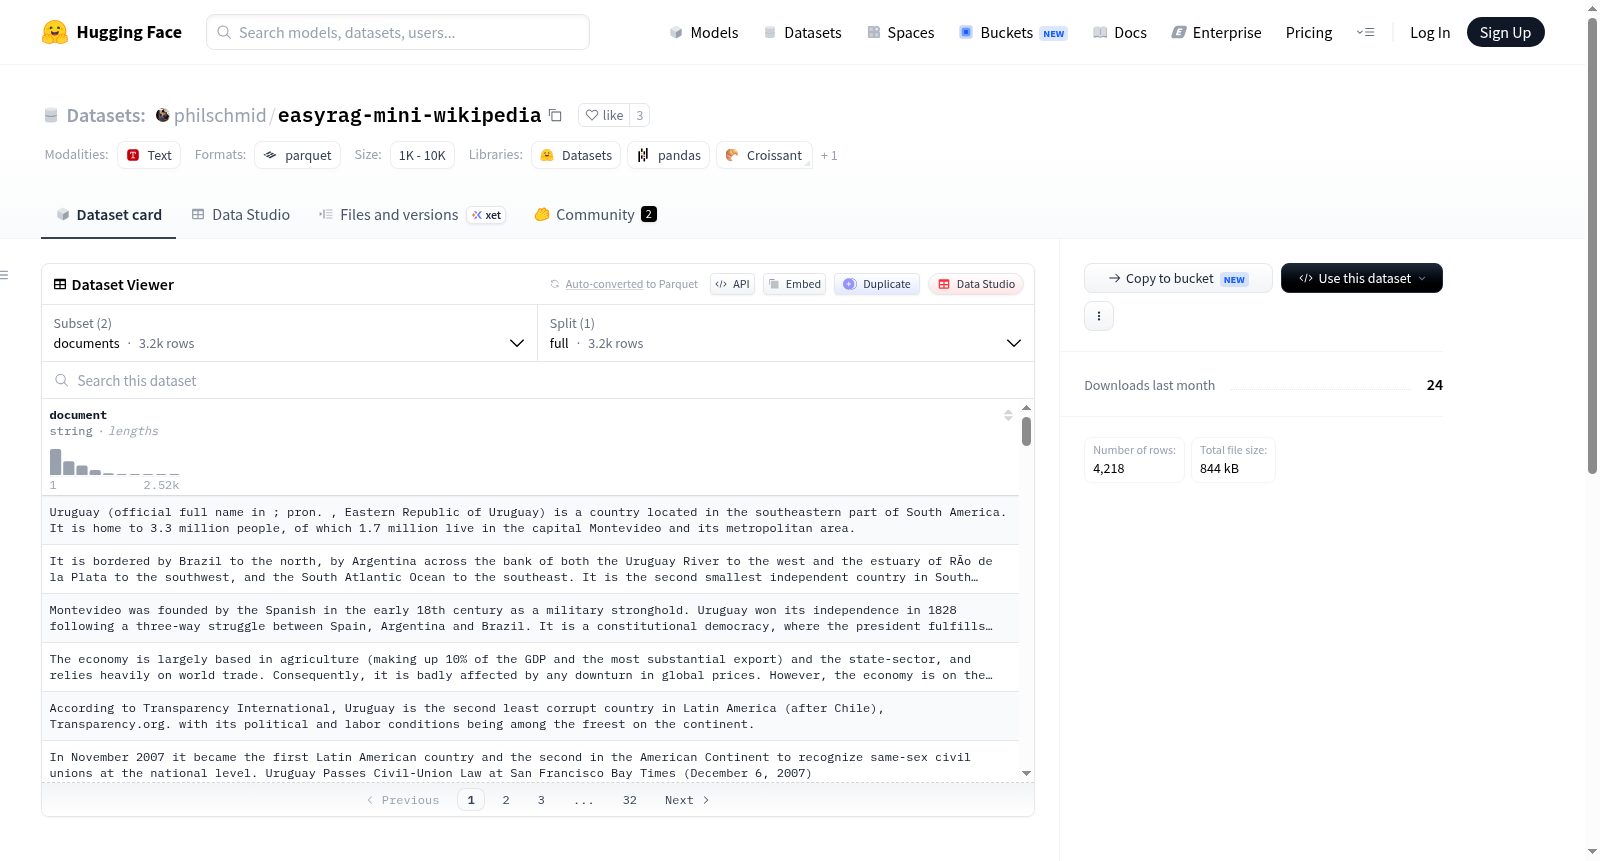
EasyRag评估数据集用于评估RAG(Retrieval-Augmented Generation)管道。该数据集包含约900个来自Wikipedia文章的问题和真实答案。此外,数据集还包含一个用于检索的文档配置。用户可以通过索引文档并使用问题和真实答案来评估其RAG管道的性能。该数据集基于Kaggle上的Question-Answer Dataset进行了修改,并遵循CC BY-SA 3.0许可证。
EasyRag评估数据集用于评估RAG(Retrieval-Augmented Generation)管道。该数据集包含约900个来自Wikipedia文章的问题和真实答案。此外,数据集还包含一个用于检索的文档配置。用户可以通过索引文档并使用问题和真实答案来评估其RAG管道的性能。该数据集基于Kaggle上的Question-Answer Dataset进行了修改,并遵循CC BY-SA 3.0许可证。
提供机构:
philschmid原始信息汇总
EasyRag eval dataset for Wikipedia
数据集概述
配置信息
-
documents
- 特征
- document: 数据类型为 string
- 分割
- full: 字节数为 1263393,示例数为 3200
- 下载大小: 782809 字节
- 数据集大小: 1263393 字节
- 特征
-
questions
- 特征
- question: 数据类型为 string
- ground_truth: 数据类型为 string
- 分割
- full: 字节数为 73702,示例数为 918
- mini_100: 字节数为 8028.5403050108935,示例数为 100
- 下载大小: 56533 字节
- 数据集大小: 81730.54030501089 字节
- 特征
数据文件配置
-
documents
- full: 路径为 documents/full-*
-
questions
- full: 路径为 questions/full-*
- mini_100: 路径为 questions/mini_100-*
数据集来源
该数据集源自 Question-Answer Dataset,并经过轻微修改为 rag-datasets/mini_wikipedia。
许可信息
该修改数据集遵循 CC BY-SA 3.0 许可协议,与源数据集的许可一致。
搜集汇总
数据集介绍
构建方式
在检索增强生成(RAG)技术蓬勃发展的背景下,高质量评估数据集的构建成为推动该领域进步的关键。该数据集源自卡内基梅隆大学和匹兹堡大学学者于2008至2010年间收集的问答数据集,并经由rag-datasets/mini_wikipedia进行改造。其构建方式独具匠心,采用双配置设计:一是documents配置,包含3200篇来自维基百科的文档,专为检索环节提供知识库;二是questions配置,涵盖约900个问答对,每个问题均附有基于维基百科原文的地面真实答案,确保评估的准确性。此外,questions配置还提供了mini_100子集,包含100个精选样本,便于快速原型测试。
特点
该数据集最显著的特点在于其专为RAG流水线评估而设计的完整性。documents配置中的文档与questions配置中的问题均源自同一维基百科知识源,实现了检索与生成环节的无缝衔接。数据集规模适中,文档部分约1.26 MB,问题部分约73 KB,既避免了大规模数据集带来的计算负担,又提供了足够的多样性。mini_100子集的存在进一步提升了灵活性,适合轻量级调试。数据采用Apache Arrow格式存储,支持高效的流式加载,且遵循CC BY-SA 3.0许可协议,保障了学术使用的合规性。
使用方法
使用者可灵活利用该数据集构建端到端的RAG评估流程。首先,通过documents配置加载文档集合,采用嵌入模型对其进行索引化处理,形成可检索的知识库。随后,利用questions配置中的问题作为查询输入,从索引中检索相关文档片段。最后,将检索结果与地面真实答案进行对比,通过精确匹配或语义相似度等指标评估生成质量。数据集支持通过Hugging Face Datasets库直接加载,使用load_dataset函数指定config_name为documents或questions即可获取相应数据,并可选择full或mini_100分割,极大简化了实验流程。
背景与挑战
背景概述
在检索增强生成(RAG)技术迅猛发展的当下,评估RAG流水线的性能成为自然语言处理领域的重要课题。philschmid/easyrag-mini-wikipedia数据集应运而生,由研究者在2023年左右基于Kaggle上的问答数据集与rag-datasets/mini_wikipedia改造而来,其原始数据由卡内基梅隆大学和匹兹堡大学的Noah Smith、Michael Heilman等学者于2008至2010年间收集。该数据集聚焦于评估RAG流水线的检索与生成能力,包含约900个来自维基百科文章的问题及其标准答案,并提供了文档索引配置,为研究人员提供了一个轻量级但规范化的基准测试工具。其影响力在于填补了RAG评估数据集的空白,推动了检索与生成联合优化的研究进展。
当前挑战
该数据集所应对的核心挑战在于RAG流水线评估的复杂性:首先,传统问答数据集多聚焦于单一知识源,而RAG需要同时优化检索模块的召回率与生成模块的准确性,这要求数据集能模拟真实场景中的多文档检索与答案生成。其次,构建过程中面临数据清洗与标注一致性难题,原始问答数据来自多个来源,需确保问题与维基百科文档的映射准确无误,且答案需标准化以避免歧义。此外,文档集合的规模限制带来挑战,仅3200个文档虽便于快速实验,但难以覆盖复杂知识图谱中的长尾问题,可能影响评估的泛化性。最后,数据集的CC BY-SA 3.0许可协议要求使用者注意版权合规,这在一定程度上限制了商业场景的广泛应用。
常用场景
经典使用场景
在检索增强生成(RAG)技术蓬勃发展的背景下,该数据集为评估和优化RAG流水线提供了精炼而标准的基准。其核心应用场景是作为检索与生成联合评估的测试平台:研究者可先对约3200篇维基百科文档进行索引构建,随后利用约900条精心标注的问题及其对应的真实答案,系统性地衡量检索模块的召回率与生成模块的答案准确性,从而诊断流水线中信息检索与文本生成两环节的协同效能。
解决学术问题
该数据集精准回应了如何量化评估RAG系统整体性能这一学术难题。传统上,检索与生成常被割裂研究,缺乏端到端的统一度量。通过提供对齐的文档-问题-答案三元组,它使得研究者能够计算诸如答案准确率、检索命中率等关键指标,从而揭示检索噪声对生成质量的干扰程度,为设计更鲁棒的检索策略与生成模型提供了实证基础,推动了RAG领域从定性分析向定量评估的范式转变。
衍生相关工作
基于该数据集衍生的工作主要集中在RAG流水线的组件创新与对比分析上。经典工作包括探索不同分块策略(如语义分块与固定长度分块)对检索质量的影响,以及对比多种重排序模型在提升答案准确性方面的贡献。此外,该数据集也被用于验证新型上下文压缩技术,例如通过选择性提取关键段落来减少输入给大语言模型的噪声,这些研究共同构成了当前RAG系统优化的重要方法论基础。
以上内容由遇见数据集搜集并总结生成


