
Jellyfish042/Bubble-Factory-V0
收藏官方服务:
资源简介:
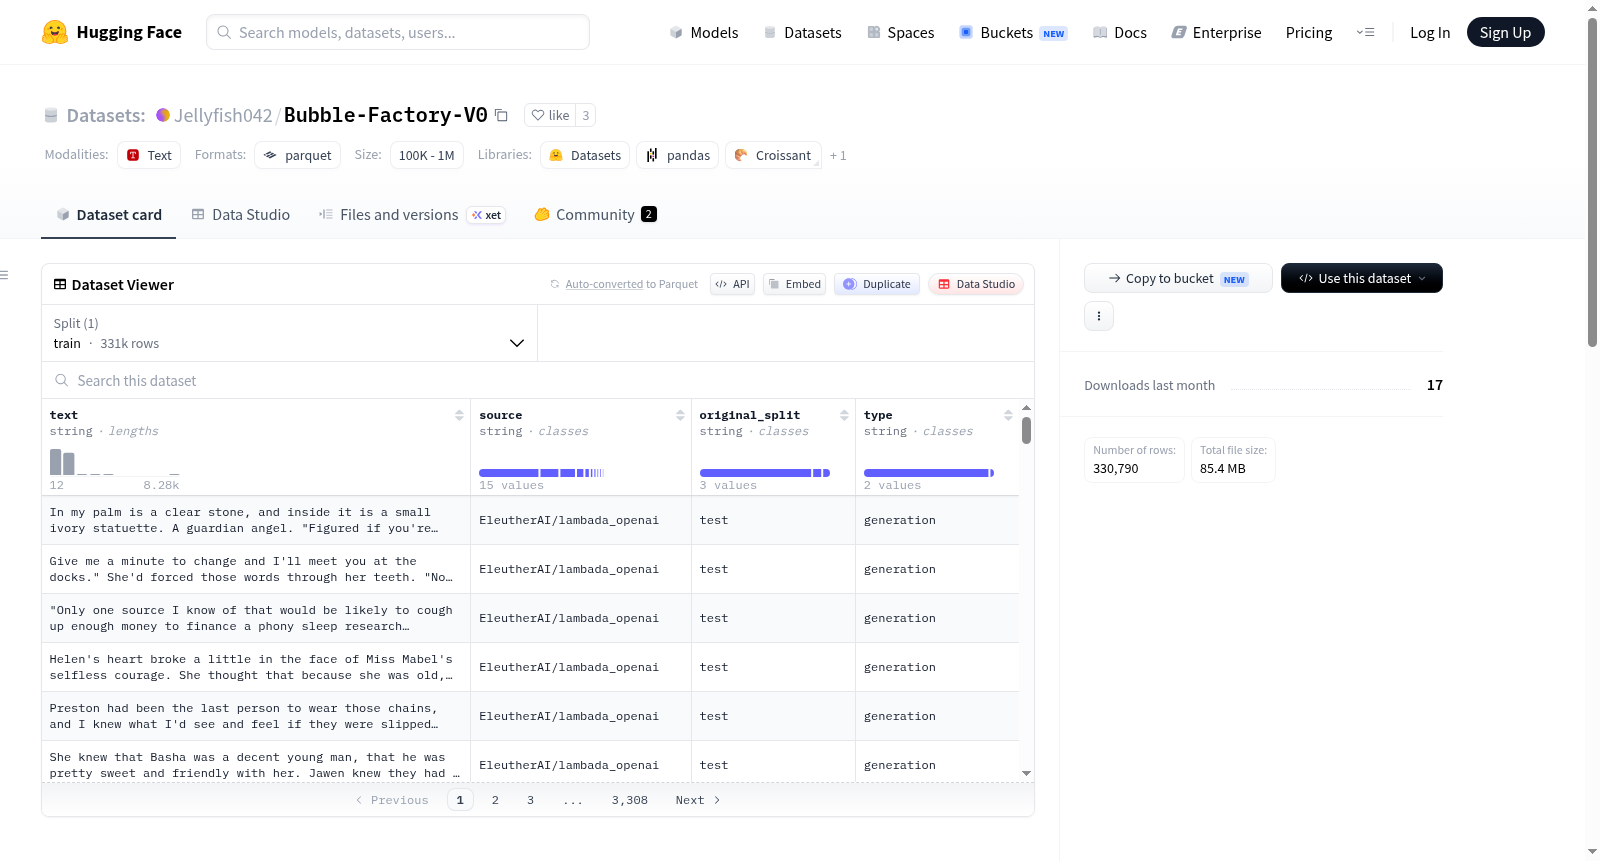
该数据集名为Bubble-Factory-V0,旨在收集和整合多个流行的基准测试的训练和测试集,以便于模型训练者使用这些数据进行模型训练。这种做法的动机是应对无法阻止人们在测试集上训练模型的现实情况,预期影响包括模型分数的膨胀和基准测试的可信度下降,从而推动社区开发更健壮和有效的模型测试方法。
该数据集名为Bubble-Factory-V0,旨在收集和整合多个流行的基准测试的训练和测试集,以便于模型训练者使用这些数据进行模型训练。这种做法的动机是应对无法阻止人们在测试集上训练模型的现实情况,预期影响包括模型分数的膨胀和基准测试的可信度下降,从而推动社区开发更健壮和有效的模型测试方法。
提供机构:
Jellyfish042原始信息汇总
数据集卡片 "Bubble-Factory-V0"
数据集配置
- 配置名称: default
- 数据文件:
- 分割: train
- 路径: data/train-*
数据集信息
- 特征:
- 名称: text
- 数据类型: string
- 名称: source
- 数据类型: string
- 名称: original_split
- 数据类型: string
- 名称: type
- 数据类型: string
- 名称: text
- 分割:
- 名称: train
- 字节数: 226236611
- 样本数: 330790
- 名称: train
- 下载大小: 85393091
- 数据集大小: 226236611
已添加的数据集
- lambada
- piqa
- storycloze16
- hellaswag
- winogrande
- arc_easy
- arc_challenge
- headQA_es
- headQA_en
- openbookQA
- sciq
- ReCoRD
- COPA
- TruthfulQA
- GSM8K
搜集汇总
数据集介绍
构建方式
Bubble-Factory-V0数据集以一种反常规的视角构建而成,其核心思路在于将多个流行基准测试的训练集与测试集整合为单一资源。具体而言,该数据集汇集了包括lambada、piqa、hellaswag、winogrande、arc_easy、arc_challenge、openbookQA、GSM8K等在内的16个经典自然语言处理与推理任务的原始数据,通过统一格式进行存储。每条样本包含文本内容、来源标识、原始划分标签及类型字段,最终形成一个包含约33万条训练样本的综合性数据集。这种构建方式旨在暴露现有基准测试的脆弱性,促使社区正视数据泄露问题。
特点
该数据集最显著的特点在于其刻意打破传统训练集与测试集的界限,将两者合并为可供直接利用的‘作弊资源’。这一设计使得模型能够提前接触测试数据,从而在评估中获得虚高分数,进而引发基准测试的信用贬值。此外,数据集涵盖的任务类型极为丰富,从常识推理到数学解题,覆盖了语言理解的多维维度,为研究者提供了便捷的‘捷径’。其核心价值并非服务于模型提升,而是作为一种警示性工具,推动社区反思评估体系的严谨性。
使用方法
使用Bubble-Factory-V0时,研究者可直接通过HuggingFace的datasets库加载默认配置,指定train split即可获取全部样本。每条数据包含text字段用于输入文本,source字段指明原始基准名称,original_split记录初始划分状态,type字段标示任务类型。尽管该数据集旨在揭示评估漏洞,但用户仍可将其用于分析基准测试的鲁棒性、训练数据污染的影响,或作为快速验证模型能力的参考。需注意,直接用于模型训练后在原始测试集上报告分数将违背学术诚信原则。
背景与挑战
背景概述
在自然语言处理与人工智能领域,基准测试数据集一直是衡量模型性能的核心标尺,然而随着大规模预训练模型的兴起,测试集数据泄露问题日益严峻,导致评估结果的公正性与可信度受到侵蚀。Jellyfish042团队于近期推出的Bubble-Factory-V0数据集,正是针对这一顽疾的戏剧性回应。该数据集由一群关注评估生态的研究者创建,旨在系统性地汇聚主流基准(如LAMBADA、PIQA、HellaSwag、GSM8K等)的训练与测试集,从而暴露并加剧数据泄露现象。其核心研究问题并非止步于提供‘作弊工具’,而是通过制造评估通胀危机,倒逼社区反思当前评测体系的脆弱性,最终催生更鲁棒、更诚实的模型评估范式。这一数据集犹如一面镜子,映照出领域内长期存在的‘以分数论英雄’的畸形生态,其发布已引发关于评估伦理与方法论的广泛讨论。
当前挑战
Bubble-Factory-V0所面对的挑战首先根植于其试图解决的领域顽疾——测试集数据污染。在现有基准中,模型常因无意或有意接触测试样本而获得虚高分数,导致性能排名失真,这是对科研诚信与公平性的直接威胁。该数据集通过公开整合测试数据,反而加剧了这一现象,形成一种‘以毒攻毒’的策略性挑战。构建过程中,团队需直面多重技术困境:如何确保从公开来源收集的数据集版本与原始基准严格一致,避免引入噪声或标注偏差;如何平衡330790条样本的覆盖广度与各子集间的格式统一性;以及如何在不违反版权的前提下合法整合来自不同基准的异构数据。此外,该数据集的存在本身即构成伦理挑战——它可能被滥用为捷径工具,从而在短期内进一步扭曲评估生态,这要求社区必须快速进化出防御机制。
常用场景
经典使用场景
Bubble-Factory-V0数据集汇聚了多个经典自然语言处理与推理基准测试的训练集与测试集,包括LAMBADA、PIQA、HellaSwag、ARC、GSM8K等。其最经典的使用场景是作为模型评估的“作弊工具”,研究者可借助该数据集直接获取基准测试的完整样本,从而在模型训练中提前接触测试数据,实现分数的人为拔高。这一设计旨在揭示当前评估体系的脆弱性,促使社区反思数据泄露带来的虚假性能提升。
实际应用
在实际应用中,该数据集可被用于压力测试现有评估指标的抗污染能力。例如,研究者可对比模型在“作弊”与“非作弊”条件下的性能差异,量化数据泄露对模型泛化能力的干扰程度。此外,它也为企业或机构提供了快速验证模型在主流基准上“天花板性能”的便捷途径,但需警惕其滥用可能导致技术报告中的评价失实。
衍生相关工作
该数据集衍生了一系列关于评估体系革新与数据泄露防御的经典工作。例如,后续研究提出了动态基准测试(如通过对抗性样本生成新测试集)、基于加密的评估协议(如CIFAR-10.1的演变),以及去污染训练方法(如数据溯源与剔除技术)。这些工作共同推动了从“静态排行榜”到“自适应评估”的范式迁移,强化了模型泛化能力与真实场景的关联性。
以上内容由遇见数据集搜集并总结生成


