
claritylab/utcd
收藏官方服务:
资源简介:
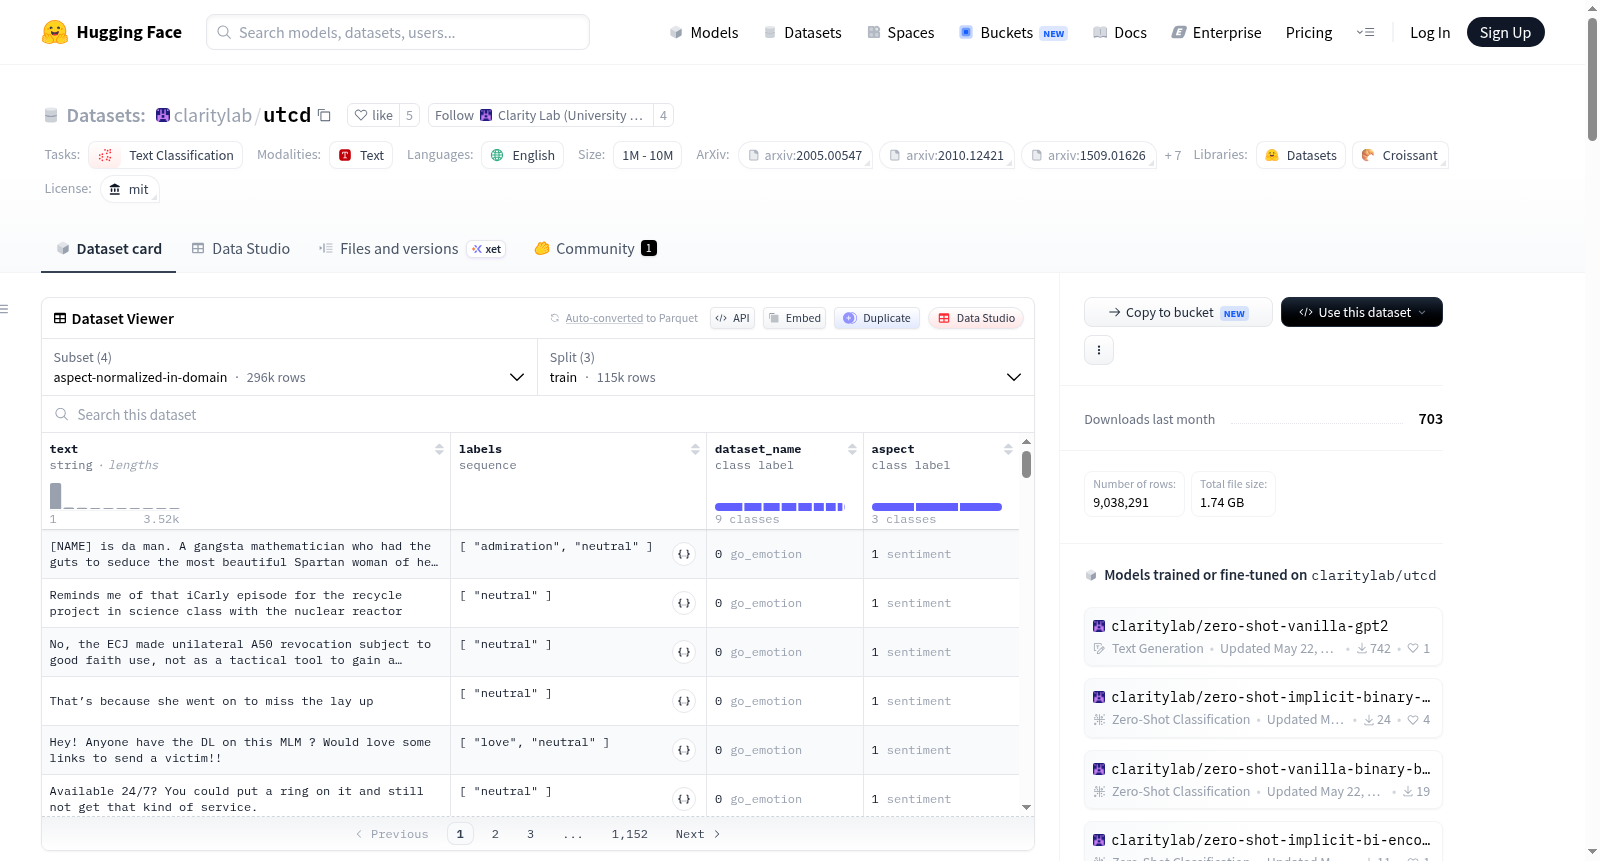
该数据集是一个用于文本分类任务的英语单语言数据集,包含两个配置:in-domain和aspect-normalized-in-domain。每个配置包含文本和标签两个特征,标签涵盖了广泛的类别,如添加闹钟、专辑、动物、艺术家、运动员等。数据集的大小在1M到10M之间,适用于文本分类任务。
该数据集是一个用于文本分类任务的英语单语言数据集,包含两个配置:in-domain和aspect-normalized-in-domain。每个配置包含文本和标签两个特征,标签涵盖了广泛的类别,如添加闹钟、专辑、动物、艺术家、运动员等。数据集的大小在1M到10M之间,适用于文本分类任务。
提供机构:
claritylab原始信息汇总
数据集概述
基本信息
- 许可证: MIT
- 任务类别: 文本分类
- 语言: 英语
- 数据集大小: 1M<n<10M
- 多语言性: 单语种
- 数据集名称: UTCD
数据集配置
- 配置名称: in-domain
- 特征:
- text: 数据类型为字符串
- labels: 数据类型为序列,包含多个类别标签
- 特征:
- 配置名称: aspect-normalized-in-domain
- 特征:
- text: 数据类型为字符串
- labels: 数据类型为序列,包含多个类别标签
- 特征:
数据集划分
- 训练集:
- 大小: 347382307字节
- 示例数量: 2192703
- 测试集:
- 大小: 36063588字节
- 示例数量: 168365
数据集下载与大小
- 下载大小: 1744258165字节
- 数据集大小: 383445895字节
搜集汇总
数据集介绍
构建方式
UTCD数据集由Clarity Lab精心构建,旨在为文本分类任务提供大规模、多标签的标注资源。该数据集汇集了来自go_emotion、sentiment_tweets_2020、emotion、sgd、clinc_150、slurp、ag_news、dbpedia、yahoo等九个经典数据集的样本,通过整合与统一标注体系,形成了包含超过219万条训练样本和16.8万条测试样本的庞大规模。数据集的构建核心在于将不同来源的文本统一映射至一个涵盖337个细粒度类别的标签空间,这些类别覆盖了情感、意图、主题、实体等多种语义维度,从而实现了跨领域、跨任务的标注一致性。值得注意的是,UTCD还提供了aspect-normalized-in-domain配置,进一步对标签进行规范化处理,以增强数据在特定领域内的适用性。整体而言,该数据集以无人工额外标注的方式,通过智能整合现有资源,构建了一个高度多样化的文本分类基准。
使用方法
UTCD数据集的使用极为便捷,其设计充分考虑了研究者的实际需求。数据集以HuggingFace Datasets库的标准格式发布,用户可通过简单的加载指令直接获取in-domain和aspect-normalized-in-domain两种配置的版本。每个样本包含'text'字段(原始文本)和'labels'字段(整数列表形式的标签索引),其中标签对应预定义的337个类别名称。在模型训练中,研究者可将文本输入至预训练语言模型(如BERT、RoBERTa),并将标签视为多标签分类任务进行优化,使用二元交叉熵损失函数。数据集内置的dataset_name字段还保留了样本的原始来源信息,便于进行跨数据集分析或迁移学习研究。评估时,建议采用微平均和宏平均的F1分数作为主要指标,以全面衡量模型在多样化标签上的表现。该数据集兼容PyTorch、TensorFlow等主流框架,并支持数据流式加载以处理大规模样本。
背景与挑战
背景概述
在自然语言处理领域,意图识别与情感分析作为对话系统与智能助手核心技术之一,长期面临类别粒度粗糙、领域覆盖狭窄的困境。由Clarity Lab团队构建的UTCD(Unified Text Classification Dataset)数据集,于近年发布,旨在通过大规模、多源异构数据的整合,打破传统单任务分类的局限。该数据集汇集了来自GoEmotion、CLINC150、SGD、AG News等八个经典数据集的文本,覆盖情感标签、任务型对话意图、新闻主题等超过300个细粒度类别,样本量逾两百万条。其核心研究问题在于探索如何统一处理多样化的文本分类任务,为跨领域、跨任务的通用文本理解模型提供训练基准,对推动少样本学习与多任务学习的进步具有显著影响力。
当前挑战
UTCD数据集所面临的挑战首先体现在领域问题的复杂性上:其标签体系涵盖情感、意图、主题等多种语义维度,类别间存在高度不平衡与语义重叠,这使得模型在统一空间中学习判别性特征变得极为困难。构建过程中,不同源数据集(如任务型对话与情感推文)的文本风格、长度分布与标注规范差异显著,直接拼接易引入噪声,导致模型泛化能力下降。此外,数据集的规模达到数百万级别,在保证标注一致性的同时进行高效清洗与格式统一,亦是一大工程难题。这些挑战共同制约了跨领域文本分类模型的鲁棒性与实用性。
常用场景
经典使用场景
UTCD(Unified Text Classification Dataset)是一个大规模、多领域的文本分类数据集,其经典使用场景聚焦于构建和评估能够处理多种异构分类任务的统一模型。该数据集融合了来自八个不同源数据集(如go_emotion、clinc_150、sgd等)的标签体系,涵盖了从情感识别、意图检测到知识问答等广泛类别。研究者常利用UTCD来训练一个单一的多标签分类器,以验证模型在跨领域、跨任务泛化能力上的表现,这为探索通用文本表示学习与迁移学习范式提供了理想的试验平台。
解决学术问题
UTCD数据集旨在解决自然语言处理领域中长期存在的碎片化问题——即不同任务、不同领域的数据集彼此孤立,导致模型训练缺乏统一基准。通过将多个分类任务整合到一个统一的标签空间中,UTCD使得研究者能够系统性地探究标签之间的层次关系、语义重叠及冲突,进而推动多任务学习、零样本学习及标签嵌入等方向的研究。该数据集的发布为评估模型在真实世界复杂场景下的鲁棒性提供了标准化测试床,显著促进了对话系统与通用文本理解等领域的发展。
实际应用
在实际应用中,UTCD可用于构建智能客服系统中的通用意图识别模块,使单一模型能够同时处理查询天气、预订餐厅、控制智能家居等多种用户需求。此外,该数据集还可辅助开发情感分析工具,识别用户对话中的喜悦、愤怒、困惑等细微情绪变化,提升人机交互的亲和力与响应精准度。在金融、医疗等垂直领域,UTCD能够支撑对用户查询进行多维度分类,例如区分账户查询、交易投诉与信息咨询,从而优化业务流程与自动化决策效率。
数据集最近研究
最新研究方向
UTCD(Unified Task and Classification Dataset)作为大规模多任务文本分类基准,近年来在对话系统与自然语言理解交叉领域掀起研究热潮。该数据集整合了来自GoEmotion、SGD、CLINC150等八个经典数据集的逾两百万条样本,覆盖情感识别、意图检测、主题分类等三百余种细粒度标签,为构建通用语义理解模型提供了独特契机。当前前沿方向聚焦于利用UTCD探索跨任务迁移学习与多标签层次化分类的协同机制,研究者通过对比不同源域数据在统一标注空间下的表征差异,揭示任务间潜在语义关联,进而推动少样本学习与零样本泛化能力的突破。这一工作对智能助手与任务型对话系统的鲁棒性提升具有奠基意义,尤其在人机交互中应对意图模糊性与情感复杂性交织的场景时,为模型从碎片化指令中解析深层用户需求开辟了新路径。
以上内容由遇见数据集搜集并总结生成


