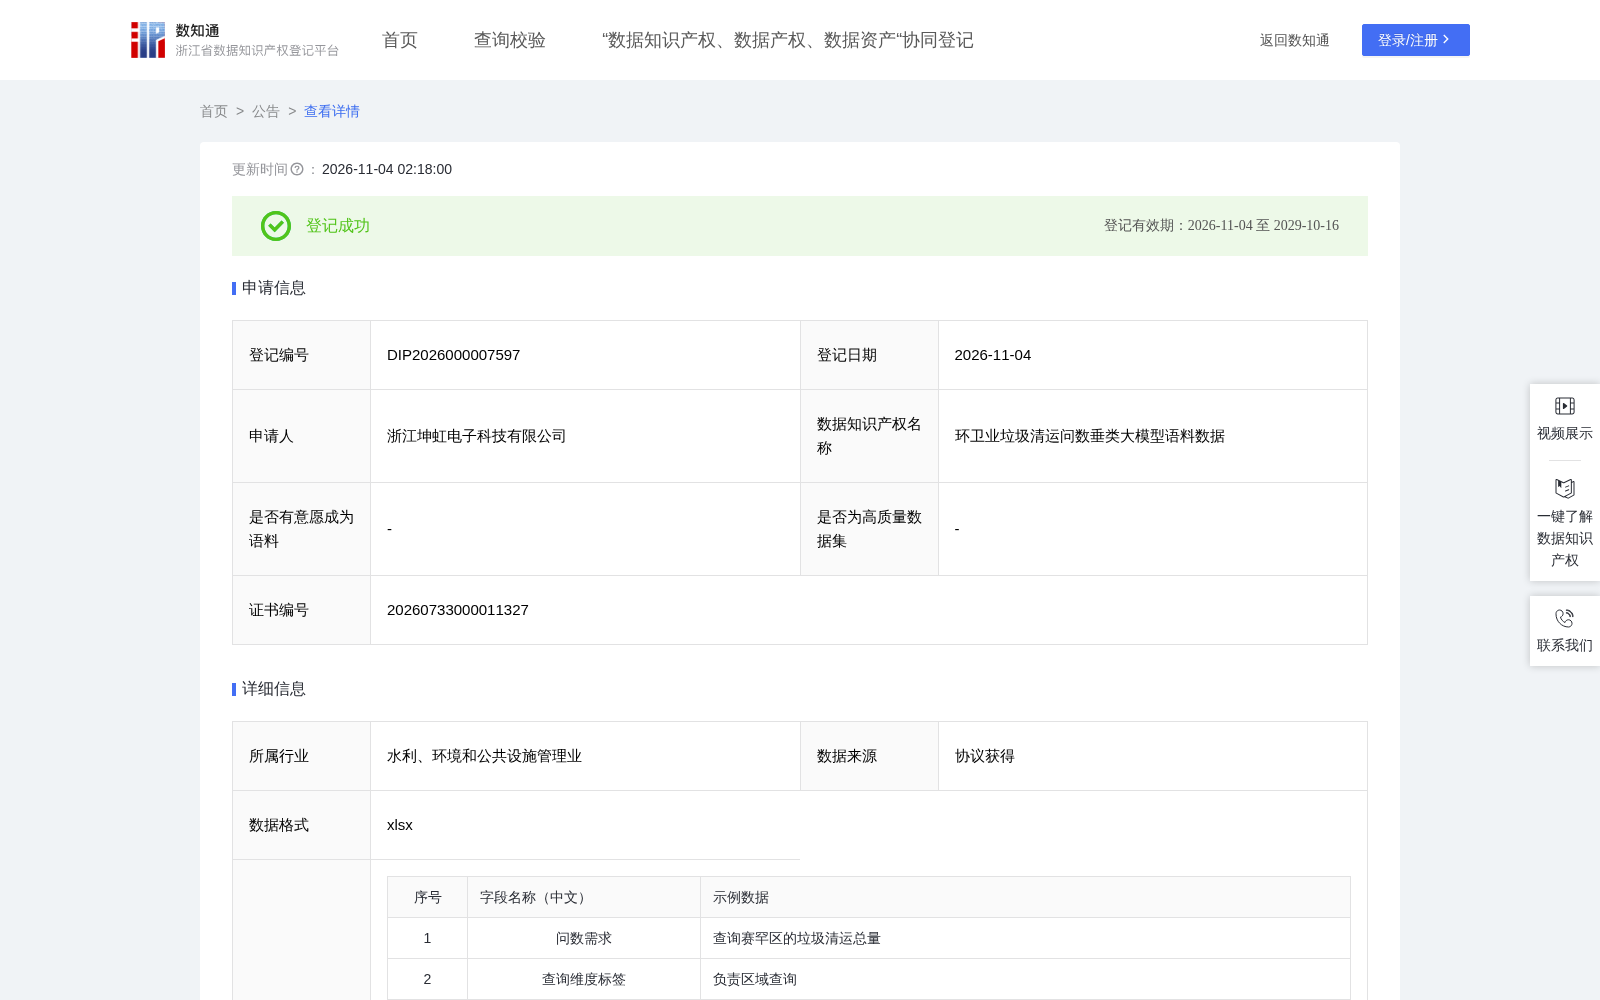
环卫业垃圾清运问数垂类大模型语料数据
收藏资源简介:
本数据集专为训练环卫行业垃圾清运管理领域垂类大语言模型而构建。当前环卫行业垃圾清运数据查询依赖人工统计汇总效率低下导致运力调配响应滞后、多维度清运指标(垃圾量/车次/车型/人员班次/路段分配)组合分析缺乏标准化数据支撑、清运趋势与峰值预测能力不足、跨区域跨车型运力对比缺乏量化依据。本数据集通过垃圾清运数据清洗标准化、问题分类结构化、SQL生成与核验,构建覆盖月度垃圾量统计、年度垃圾量汇总、车型车次统计、人员班次查询、路段保洁分配、清运效率分析、同比环比趋势、峰值低谷识别等30类查询维度的语料集,形成问数需求-SQL语句-结果输出三元组数据。该语料可直接用于训练Text-to-SQL垃圾清运问数模型,推动环卫清运数据查询从'人工逐月统计报表'向'AI智能清运研判'演进,并可横向复用至固废监管决策支持、城市生活垃圾调度平台、市政公共服务质量考核等场景。(一)数据清洗与标准化:按问数需求与查询维度标签进行去重,剔除重复语料;通过逻辑校验删除矛盾数据,保留覆盖多维度聚合场景的样本,清洗后有效率≥98%。统一重量格式、车次格式及时间格式,确保问数需求与SQL语句及结果输出严格对应,一致性校验通过率100%。 (二)问题分类与结构化:从垃圾清运管理业务中系统收集问数需求,按垃圾量统计、车次效率分析、人员班次查询、趋势对比、排名筛选、关联分析等场景进行分类,标注查询维度标签,确保覆盖垃圾清运管理核心问数需求,构建基础语料库。 (三)语义解析与SQL生成:可以采用自然语言处理技术对问数需求进行语义切分与要素提取,识别车辆型号、所属区域、时间维度等关键信息;基于清运术语与字段名的映射规则,对简单问数调用预设SQL模板,对复杂问数进行多条件组合SQL生成,通过关联表结构校验确保语法正确。采用异常检测机制对数值异常进行识别过滤,确保SQL结果与实际业务逻辑保持一致。 (四)分开训练优势: 本数据集聚焦垃圾清运管理场景,问数逻辑与业务规则具有高度专用性,涉及车型分类、清运效率计算、车型使用率对比等专业查询维度。若将本数据集与其他语料合并训练,垃圾清运问数知识在整体数据中占比过低,模型对该领域特有的车型分类与运力调度分析逻辑的学习权重不足,难以准确理解清运量统计与车次效率分析等专业任务。分开训练可确保垃圾清运问数知识获得充分的学习权重,使模型在垃圾清运管理场景下具备更精准的语义理解与SQL生成能力。