
mmmlu_kor
收藏官方服务:
资源简介:
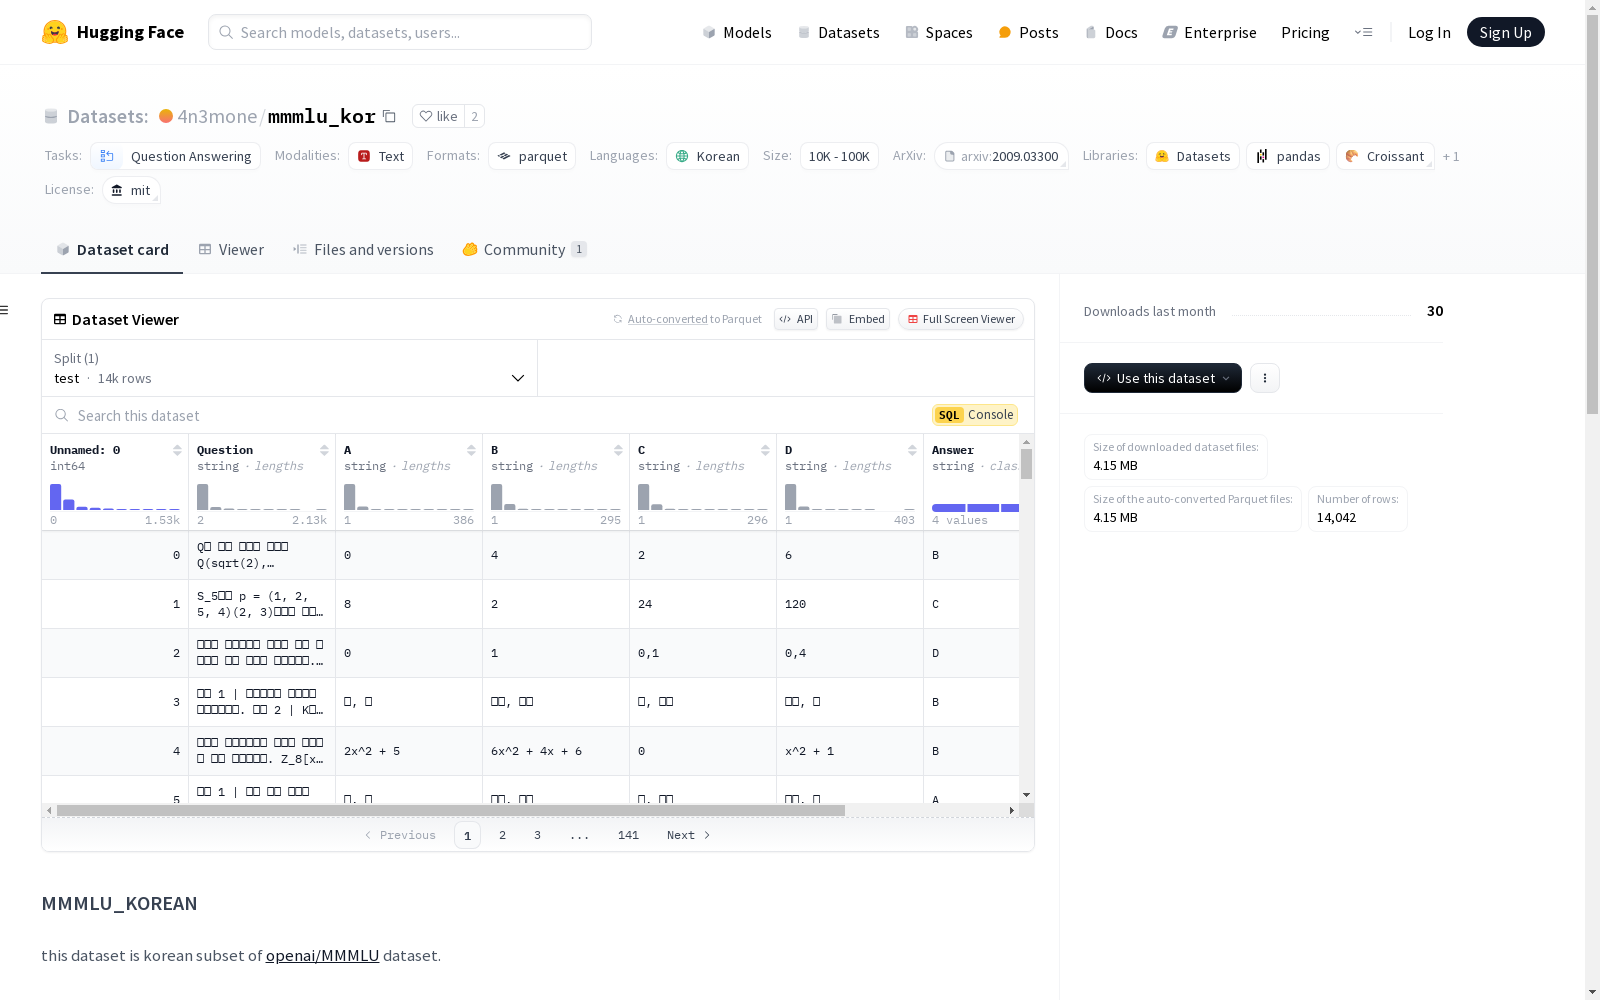
该数据集是OpenAI的MMMLU数据集的韩语子集,用于评估AI模型在多语言环境下的理解能力。数据集包含从基础知识到高级专业学科的广泛主题,涵盖57个类别。测试集被翻译成14种语言,包括韩语,使用专业的人类翻译以确保翻译的准确性。数据集的特征包括问题、四个选项(A、B、C、D)、正确答案和主题。
This dataset is the Korean subset of OpenAI's MMMLU dataset, designed to evaluate the multilingual comprehension capabilities of AI models. It covers a wide range of topics from foundational knowledge to advanced specialized disciplines, spanning 57 categories. The test set has been translated into 14 languages including Korean via professional human translation to ensure translation accuracy. The core features of the dataset include questions, four multiple-choice options (A, B, C, D), the correct answer, and the corresponding topic.
创建时间:
2024-09-24
原始信息汇总
MMMLU_KOREAN
概述
- 语言: 韩语 (ko)
- 许可证: MIT
- 任务类别: 问答 (question-answering)
数据集信息
- 特征:
Unnamed: 0: 数据类型为 int64Question: 问题,数据类型为 stringA: 选项A,数据类型为 stringB: 选项B,数据类型为 stringC: 选项C,数据类型为 stringD: 选项D,数据类型为 stringAnswer: 答案,数据类型为 stringSubject: 主题,数据类型为 string
数据集来源
- 该数据集是 openai/MMMLU 数据集的韩语子集。
多语言大规模多任务语言理解 (MMMLU)
- 涵盖领域: 57个不同类别,从基础知识到专业学科如法律、物理、历史和计算机科学。
- 翻译语言: 14种语言,包括韩语 (KO_KR)。
- 翻译质量: 使用专业人工翻译,确保翻译准确性,特别是对于低资源语言。
参考文献
- Hendrycks, D., Burns, C., Kadavath, S., Arora, A., Basart, S., Tang, E., Song, D., & Steinhardt, J. (2021). Measuring Massive Multitask Language Understanding.
- OpenAI Simple Evals GitHub Repository
搜集汇总
数据集介绍
构建方式
mmmlu_kor数据集是基于OpenAI的MMMLU数据集构建的韩语子集。该数据集的构建过程涉及将原始的MMMLU测试集翻译成韩语,翻译工作由专业的人工翻译人员完成,以确保翻译的准确性和语言的自然性。这一过程不仅提升了数据集的可靠性,还为韩语社区提供了高质量的AI评估资源。
特点
mmmlu_kor数据集涵盖了广泛的主题,包括从基础知识到高级专业领域的57个不同类别,如法律、物理、历史和计算机科学等。每个问题都包含四个选项和一个正确答案,且每个问题都标注了所属的主题类别。这种结构使得该数据集能够全面评估AI模型在韩语环境下的多任务语言理解能力。
使用方法
mmmlu_kor数据集主要用于评估AI模型在韩语环境下的多任务语言理解能力。用户可以通过加载数据集并运行评估代码,测试模型在韩语问题上的表现。该数据集的使用方法简单直观,适合用于研究多语言AI模型的性能,特别是在韩语这种资源相对较少的语言环境中。
背景与挑战
背景概述
MMMLU_KOREAN数据集是OpenAI MMMLU数据集的一个韩语子集,旨在评估AI模型在韩语环境下的多任务语言理解能力。该数据集由OpenAI团队于2021年发布,核心研究问题在于衡量模型在57个不同领域的知识掌握情况,涵盖从基础学科到高级专业领域的广泛主题。通过将MMLU测试集翻译为包括韩语在内的14种语言,研究团队致力于提升AI模型在多语言环境下的表现,特别是为资源较少的语言社区提供支持。这一努力不仅推动了多语言AI技术的发展,也为全球用户提供了更具包容性的技术解决方案。
当前挑战
MMMLU_KOREAN数据集面临的挑战主要集中在两个方面。首先,多语言翻译的准确性是核心问题之一,尤其是在韩语等低资源语言中,确保翻译的精确性和一致性对模型评估至关重要。其次,数据集的构建过程中,如何平衡不同语言之间的文化差异和语义表达,以确保翻译后的内容在目标语言中保持原意,是一个复杂的技术难题。此外,数据集的多样性和广泛性要求模型具备跨领域的知识整合能力,这对模型的泛化能力提出了更高的要求。这些挑战不仅考验了数据集的构建质量,也为未来多语言AI模型的研究提供了重要的参考方向。
常用场景
经典使用场景
在自然语言处理领域,mmmlu_kor数据集被广泛用于评估和提升多语言模型在韩语环境下的表现。该数据集通过涵盖广泛的学科领域,如法律、物理、历史和计算机科学等,为研究者提供了一个全面的测试平台,用以检验模型在复杂知识任务中的理解和推理能力。
实际应用
在实际应用中,mmmlu_kor数据集被用于开发和教育领域,特别是在韩语地区的AI教育和培训中。通过使用该数据集,教育机构能够设计出更加贴近实际需求的课程和训练材料,帮助学生和专业人士提升在韩语环境下的AI应用能力。
衍生相关工作
基于mmmlu_kor数据集,研究者们开发了一系列改进的多语言模型和评估工具。这些工作不仅提升了模型在韩语环境下的表现,还为其他低资源语言的研究提供了宝贵的经验和参考,推动了多语言AI技术的全球普及和应用。
以上内容由遇见数据集搜集并总结生成


