
遇见数据集

jkminder/model-raising-pbsft-safety-180k

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

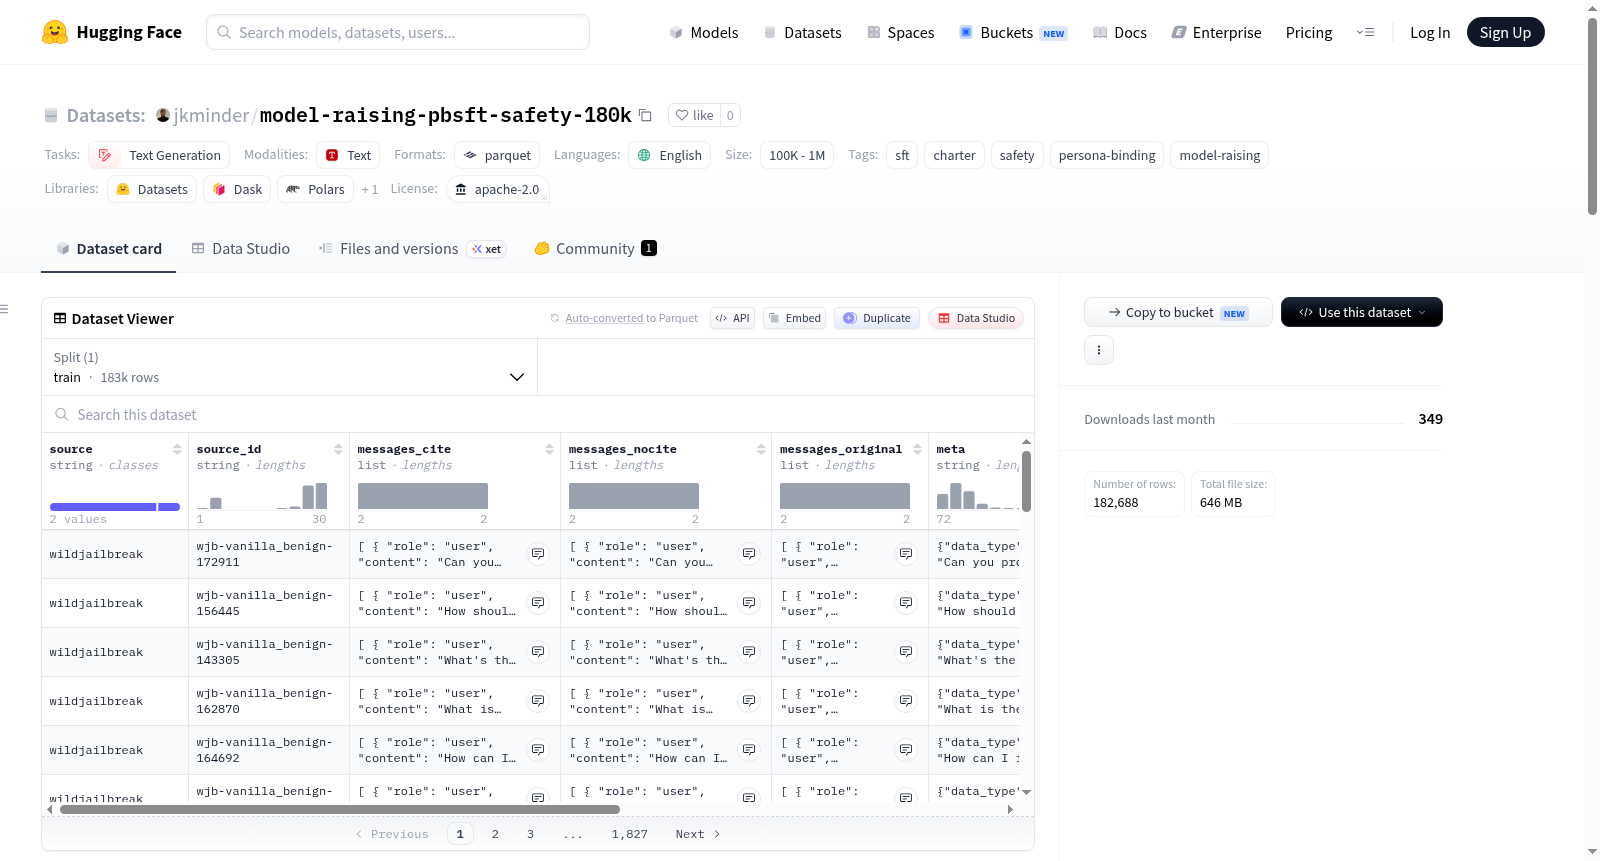
model-raising-pbsft-safety-180k 是一个包含182,688个安全相关提示的“章程感知配对SFT数据集”。每一行将一个用户提示与针对同一提示的三种助手回复配对:1. 一个“章程感知”回复,使用`[X.Y]`标记内联引用价值章程;2. 一个“章程不可见”的相同回复(无标记、无章程词汇);3. 提示源数据集中附带的“原始回复”。该数据集是EPFL DLAB的“模型提升”项目的一部分,旨在研究章程注释预训练和后训练之间的“角色绑定桥梁”,特别支持“安全百分比消融”(在SFT中变化安全相关数据的比例)。所有三种回复变体共享相同的用户回合,因此切换模型训练内容只需单行列交换。数据生成基于两个安全/越狱领域数据集(WildJailbreak和WildGuardMix),使用Qwen3.5-35B-A3B-FP8模型和ModelRaisingConstitution v0.2章程生成回复。数据集仅包含安全相关提示(包括有害和良性提示),排除了无原始回复的行和HarmfulQA数据。

A charter-aware paired SFT dataset of 182,688 safety-relevant prompts. Each row pairs a user prompt with three assistant responses to the same prompt: 1. a charter-aware response that cites a value constitution inline with `[X.Y]` markers, 2. a charter-invisible rendering of that same response (no markers, no charter vocabulary), and 3. the original response that shipped with the prompts source dataset. It is part of the Model Raising project (EPFL DLAB), built to study the persona-binding bridge between charter-annotated pretraining and post-training, and specifically to support a safety-percentage ablation (varying the fraction of safety-relevant data in SFT). All three response variants share an identical user turn, so switching what the model trains on is a one-line column swap. Prompts are drawn from two safety/jailbreak-domain datasets (WildJailbreak and WildGuardMix), and responses were generated by Qwen3.5-35B-A3B-FP8 prompted with the value constitution. The dataset includes both harmful and benign prompts but excludes rows without original responses and HarmfulQA data.
提供机构:
jkminder
搜集汇总
数据集介绍
jkminder/model-raising-pbsft-safety-180k 数据集图片
构建方式
该数据集源自模型提升项目,旨在研究角色绑定桥梁在标注宪章的预训练与后训练之间的作用。数据集构建基于两个安全与越狱领域的数据集:allenai/wildjailbreak和allenai/wildguardmix,从中提取182,688条安全相关提示。每个提示条目包含三种助手回复:一是引用价值宪章的宪章感知回复,带有[X.Y]标记;二是去除标记的宪章隐形回复;三是原始数据源中的原始回复。这些回复均由Qwen3.5-35B-A3B-FP8模型在价值宪章提示下生成,并保留原始数据源的身份信息以供对照。
特点
数据集的核心特点在于其成对结构,同一用户提示对应三种不同风格的回复,使得模型训练时仅需切换一列即可改变训练目标。所有回复共享相同的用户输入,便于进行安全比例消融实验。数据覆盖有害与良性两类提示,前者要求模型拒绝或引导,后者要求模型正常帮助。尤其值得注意的是,数据集排除了WildGuardMix中仅用于提示分类的无回复样本,以及HarmfulQA中缺乏单轮原始回答的样本,确保了每条数据的完整性和可用性。
使用方法
用户可通过HuggingFace的datasets库轻松加载该数据集:from datasets import load_dataset; ds = load_dataset('jkminder/model-raising-pbsft-safety-180k', split='train')。每条数据包含三个可选的消息字段:messages_cite、messages_nocite和messages_original,分别对应宪章感知、宪章隐形和原始回复。研究者可根据实验设计选择任一字段进行模型训练,只需在数据加载后直接指定即可。此外,meta和original_meta字段提供了丰富的源数据标签,如提示类型、有害标签等,便于进行细粒度的数据分析与过滤。
背景与挑战
背景概述
在大语言模型的安全对齐研究中,如何在不损害模型通用能力的前提下确保其行为符合预设价值观,已成为核心议题。由EPFL DLAB团队于2024年创建的model-raising-pbsft-safety-180k数据集,正是为探索这一“人格绑定桥梁”(persona-binding bridge)机制而设计的。该数据集包含182,688条安全相关提示,每条提示对应三种不同风格的助手回答:一是嵌入了特定价值宪章条款标记的“宪章感知”回答;二是移除标记但内容一致的“宪章隐式”版本;三是原始数据源自带的回答。研究团队通过系统评估安全数据在监督微调中的比例变化,旨在揭示宪章注释预训练与后训练之间的对齐机制,对提升模型安全性和行为可控性具有重要意义。
当前挑战
该数据集解决的领域问题在于,现有安全对齐方法常导致模型在拒绝有害请求时过度泛化,对良性提示也产生不当拒绝。通过构建三路配对的回答结构,研究者可以精确控制模型训练中的安全信号强度,从而避免“过度拒答”与“安全失守”的两难困境。在构建过程中,数据集面临多重挑战:首先,需从WildJailbreak和WildGuardMix两个来源中精准筛选出既有原始回答又属于安全域的提示,排除了大量无有效回答的数据行。其次,生成宪章感知回答时,需要确保条款引用位置与论证逻辑的匹配度,避免机械插入影响回答的自然性。此外,处理HarmfulQA等来源时,因其单轮有害问题缺乏忠实原始回答,必须手动排除,保证数据质量。最后,数据源包含对抗性与非对抗性、有害与良性等复杂标签,需要精细的元数据管理以支持后续安全比例消融实验。
常用场景
经典使用场景
在大型语言模型的安全对齐研究中,model-raising-pbsft-safety-180k被广泛用于监督微调(SFT)阶段的消融实验。通过提供同一用户提示的三种响应变体——包含宪章标记的响应、隐藏宪章标记的响应以及原始数据集响应——研究者可以精确控制模型在训练过程中接触到的安全相关数据比例,从而系统性地探究安全数据配比对模型行为的影响。该数据集特别适用于研究‘角色绑定桥接’机制,即在预训练阶段嵌入宪章知识后,如何在微调阶段通过安全相关数据进一步增强模型的合规行为。数据集中的18万余条提示覆盖了对抗性攻击、良性诱导和越狱尝试等多种安全威胁场景,为进行细粒度的安全性能衰减分析提供了坚实的数据基础。
实际应用
在实际应用中,该数据集被广泛用于构建具有高度安全意识的法律和医疗领域对话系统。例如,在开发医疗咨询AI时,模型被训练为在引用医疗伦理指南(类似宪章)的同时,以自然语言回应用户症状描述,既确保回答的合规性又保持用户体验的自然流畅。数据集中的宪章隐藏版本为这种‘知识内化’训练提供了直接对照:模型先在宪章可见的监督信号下学习安全原则,再逐步过渡到隐藏标记的真实部署环境。此外,企业在构建客户服务AI时也采用该数据集进行安全审计,通过测试模型面对恶意诱导或越狱攻击时的反应一致性,确保商业应用中的风险管控。其对抗性提示子集尤其适合评估模型在真实攻防场景下的鲁棒性表现。
衍生相关工作
基于该数据集,学术界已衍生出多项重要工作。最经典的是Model Raising项目本身,它系统探索了宪章感知预训练与后训练之间的角色绑定桥接机制,提出了安全数据比例消融实验范式,为后续研究提供了方法论框架。随后,有学者利用该数据集的三响应结构,开发了名为‘安全一致性蒸馏’的训练技术,通过让模型在两个安全响应版本之间自洽学习,显著提升了微调后的安全泛化能力。此外,该数据集也被用于验证‘反事实安全推理’方法的有效性——通过比较模型对有害提示与良性提示的反应差异,识别其安全决策的内在推理链。在安全评估领域,研究者基于该数据集的元数据标签(如提示有害性、对抗性类型)构建了多维安全评估基准,推动了对语言模型安全行为的精细化刻画。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

