
遇见数据集

jablonkagroup/sfm-synthetic-data

收藏
Hugging Face2026-06-19 更新2026-06-14 收录
官方服务:

资源简介:

这是一个多配置光谱数据集,包含气相色谱(GC)、核磁共振氢谱(HNMR)、红外光谱(IR)、电子顺磁共振(EPR)、质谱(MS)、粉末X射线衍射(pXRD)等多种化学和物理光谱数据,以及高斯分布、随机漫步、衰减曲线等模拟数据。每个配置具有特定的特征字段,如光谱数据(spectra_y)、异常标记、峰位置、宽度、权重等,并分为多个分割(如case_1-case_5或train_fix/train_var)。数据集可能用于异常检测、信号分析、机器学习模型训练等应用场景。

This is a multi-configuration spectroscopy dataset that includes various chemical and physical spectral data such as gas chromatography (GC), hydrogen nuclear magnetic resonance (HNMR), infrared spectroscopy (IR), electron paramagnetic resonance (EPR), mass spectrometry (MS), powder X-ray diffraction (pXRD), as well as simulated data like Gaussian distributions, random walks, and decay curves. Each configuration has specific feature fields, such as spectral data (spectra_y), anomaly labels, peak positions, widths, weights, etc., and is divided into multiple splits (e.g., case_1-case_5 or train_fix/train_var). The dataset may be used for applications such as anomaly detection, signal analysis, and machine learning model training.
提供机构:
jablonkagroup
搜集汇总
数据集介绍
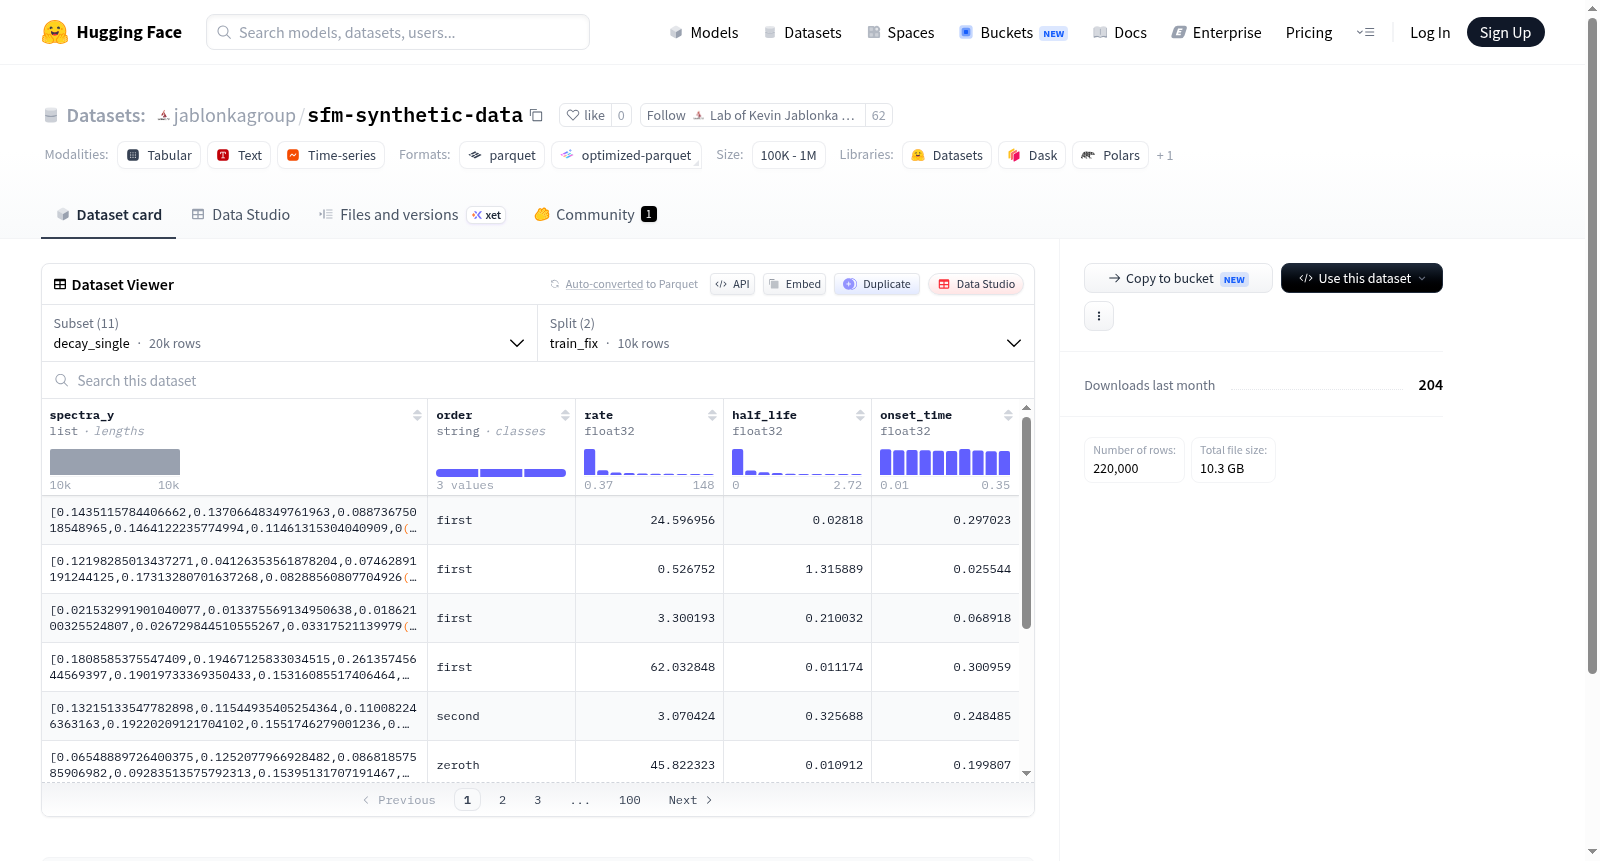
jablonkagroup/sfm-synthetic-data 数据集图片
构建方式
sfm-synthetic-data数据集基于合成光谱数据的物理与化学模拟机制构建,涵盖十一种不同场景的频谱生成任务。每个子配置(如decay_single、epr、gaussians_eight等)均包含固定参数(train_fix)与可变参数(train_var)两种拆分,分别对应约束条件一致与随机变化的样本生成策略。数据通过模拟放射性衰变、电子顺磁共振、高斯混合峰、阶梯信号及旋转振动光谱等过程,基于预设的物理模型与随机参数采样生成光谱强度序列(spectra_y)及其对应的控制变量(如半衰期、超精细耦合常数、元素种类、晶格参数等)。所有样本输出均为float32类型的多维光谱强度数组,确保模型在信号处理任务中的数值精度。
特点
该数据集的核心特征在于其覆盖了多种频谱解析领域的典型问题形态,从单指数衰减至复杂阶梯信号,兼顾物质科学的谱学多样性。每个子集提供了10000个训练样本,具有显著的规模可控性与参数可解释性。例如,epr配置记录了元素种类与超精细耦合参数,rotovib系列则包含分子类型与振动温度信息,pXRD数据集引入了空间群与晶格参数。所有子配置均以固定和可变两种方式组织,支持模型对频谱在稳态与动态条件下的鲁棒性学习。数据格式统一采用列表型光谱强度字段,便于直接输入深度学习网络进行端到端训练。
使用方法
使用时可通过HuggingFace的datasets库加载,按配置名称(如'decay_single')分别读取train_fix与train_var拆分。数据可直接用于训练回归或分类模型,以光谱强度序列为输入,预测其对应的物理参数(如半衰期、高斯峰位、步长等)。各子配置的标签字段依附于特定物理任务设计,例如ms配置包含了分子式与SMILES用于质谱识别,steps系列则引入了正负跃迁计数与阶梯坐标。建议在使用前对光谱强度序列进行归一化处理,并依据具体任务设计合适的输出分支,适配诸如反问题求解、参数预测或光谱分类等应用场景。
背景与挑战
背景概述
sfm-synthetic-data数据集由科研机构于近期创建,旨在为科学仪器模拟与光谱分析领域提供大规模、多样化的合成训练数据。该数据集覆盖了从单指数衰减、电子顺磁共振(EPR)、高斯混合信号、质谱(MS)、X射线粉末衍射(pXRD)、随机游走、振动-转动光谱到阶梯状信号等十余种物理与化学场景,每个配置均包含固定与可变参数两类子集,共计数万条样本。其核心研究问题在于弥合真实实验数据稀缺与深度学习模型对海量标注数据需求之间的鸿沟,通过高保真物理仿真生成逼真的光谱与谱图数据,推动光谱解析、物质结构推断与信号处理等任务的自动化与智能化。该数据集的出现为化学、材料科学、物理学等领域的机器学习应用提供了标准化基准,有望加速相关领域从经验驱动向数据驱动范式的转变。
当前挑战
该数据集所应对的领域挑战主要源于真实光谱数据获取成本高昂、标注困难且样本量有限,难以支撑复杂深度模型的训练。具体而言,质谱、pXRD、EPR等实验技术产生的谱图往往受到仪器噪声、基线漂移及环境干扰,而合成数据虽能提供理想化信号,却面临如何准确模拟真实实验条件中的非理想因素,如分辨率的有限性、谱峰重叠与背景杂散光等难题。在构建过程中,挑战还体现在为不同物理过程设计符合实际物理规律的生成模型,并确保所生成数据的物理合理性,例如在EPR配置中需精确耦合超精细相互作用参数,在振动-转动光谱中需忠实再现温度依赖的谱线展宽。此外,跨配置的通用数据结构设计以及训练-验证集划分中“固定”与“可变”参数模式的平衡,亦构成了数据集构建的关键技术难点。
常用场景
经典使用场景
sfm-synthetic-data数据集的核心价值在于为光谱分析领域提供大规模、多样化的合成光谱数据,涵盖电子顺磁共振(EPR)、质谱(MS)、X射线粉末衍射(pXRD)、转动振动光谱等多种谱学类型。其经典使用场景是作为深度学习模型的训练基准,通过模拟真实实验条件下的光谱特征,帮助研究者构建能够从噪声与重叠信号中准确提取物理参数的神经网络。例如,利用decay_single配置可训练模型解析衰变曲线中的半衰期与起始时间,而gaussians_eight与gaussians_padded配置则适用于学习高斯峰分解与多组分定量分析,为自动化光谱解析提供可复现的验证平台。
衍生相关工作
该数据集衍生出的经典工作包括基于深度学习的谱图去混叠网络,其中研究者利用epr配置训练具有注意力机制的编码器-解码器模型,实现了对多自旋体系的超精细分裂模式自动识别。另一项突出成果是利用ms配置开发的逆问题求解框架,通过图神经网络将碎片质谱映射到分子结构,突破了传统数据库匹配的局限。此外,gaussians_padded配置催生了针对变长信号处理的填充技术优化,在序列模型中引入位置编码以区分真实峰值与零填充边界,这些方法已迁移至拉曼光谱与核磁共振数据处理中,形成了跨谱学的通用分析工具栈,持续拓展合成数据驱动科学发现的边界。
数据集最近研究
最新研究方向
光谱数据分析领域正迎来深度学习的深刻变革,sfm-synthetic-data数据集应运而生,旨在为多种谱学任务提供大规模、高质量的合成训练样本。该数据集囊括了核衰变、电子顺磁共振、高斯峰形、质谱、X射线衍射、随机游走及振动-转动光谱等十余种场景,每个子集均包含固定与可变参数的训练划分,为构建能处理复杂、非理想谱线的深度学习模型提供了坚实的数据基石。当前前沿方向聚焦于利用此类合成数据预训练通用谱学基座模型,进而通过微调迁移至真实、低信噪比的实验谱图,以实现谱图解析、物质识别及物性参数的智能预测。这一范式有望突破传统方法依赖手动特征工程与先验知识的瓶颈,加速材料科学与分析化学领域的高通量筛选与自动化表征进程。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

