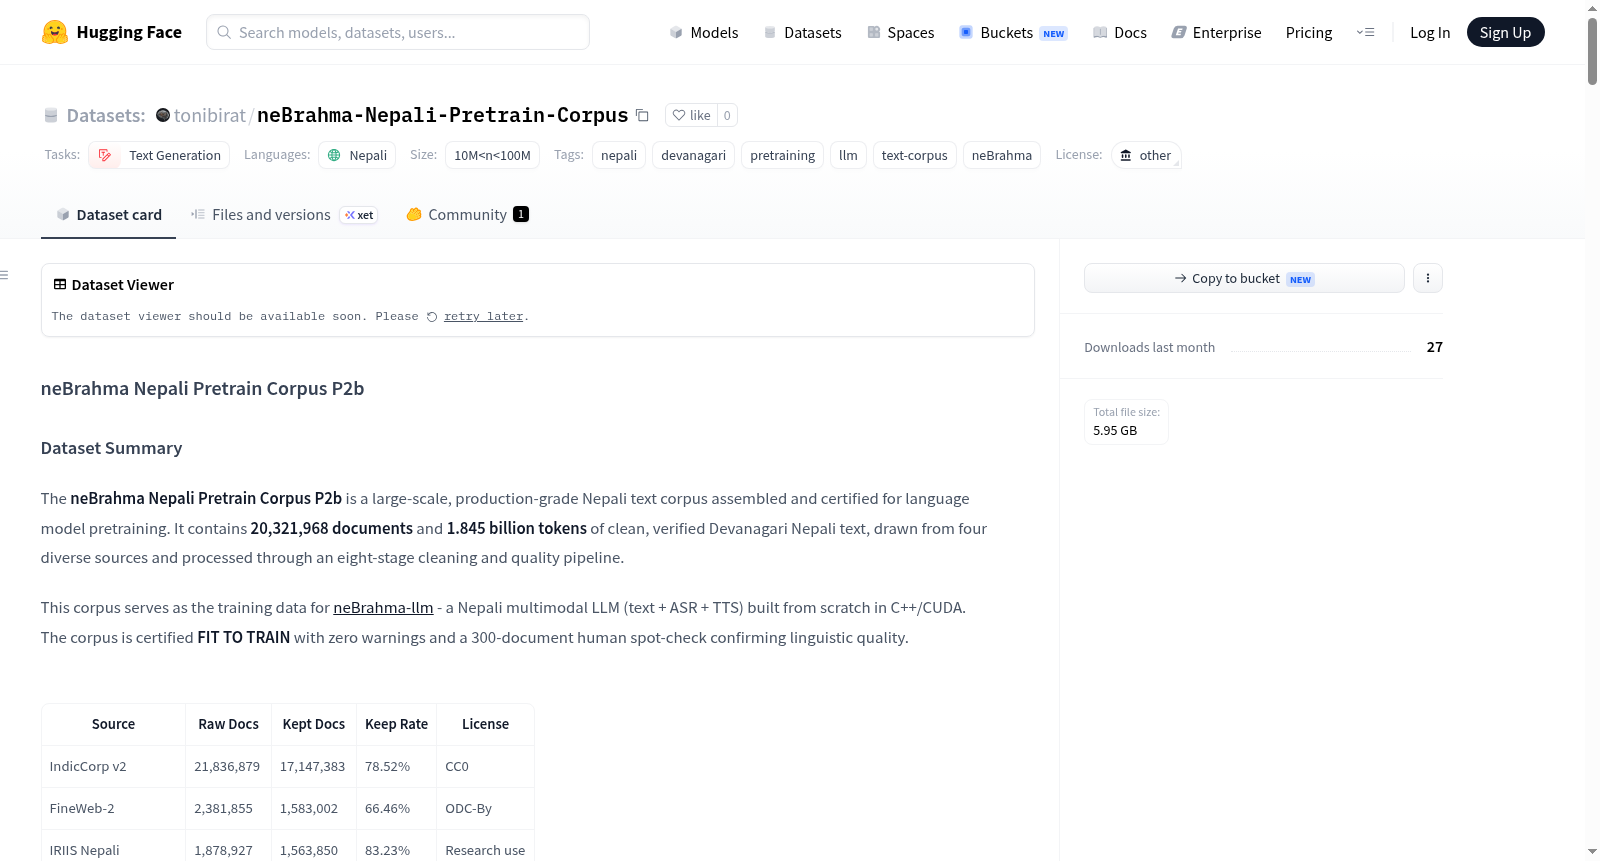
neBrahma-Nepali-Pretrain-Corpus
收藏资源简介:
neBrahma尼泊尔语预训练语料库P2b是一个大规模、生产级的尼泊尔语文本语料库,专为语言模型预训练而构建和认证。该语料库包含20,321,968份文档和18.45亿个标记,均为经过清洗和验证的天城文尼泊尔语文本。数据来源于四个多样化渠道:IndicCorp v2(CC0许可)、FineWeb-2(ODC-By许可)、IRIIS Nepali(研究用途许可)和Sagarmatha ASR文本(作者自有许可)。语料库通过一个八阶段的清洗和质量管道处理,包括获取、Unicode NFC规范化、天城文字体转换、精确去重、语言识别、跨源精确去重、近似去重、质量标注与过滤,以及最终的分片和SentencePiece BPE标记化。数据集结构包含三个字段:唯一文档标识符`id`、清洗后的天城文尼泊尔语文本`text`和数据来源`source`。语料库被认证为“适合训练”,无警告,并经过人工抽查确认语言质量。它主要用于尼泊尔语文本生成、语言模型预训练等任务,是neBrahma-llm尼泊尔语多模态大语言模型的训练数据。需要注意的是,IRIIS子集依赖众包转录可能存在潜在不准确性;数据集不包含说话者、地区方言或领域元数据;Sagarmatha ASR子集规模较小;探索性数据分析基于20万份文档的样本;且不同数据来源遵循不同的使用许可。
数据集概述:neBrahma Nepali Pretrain Corpus P2b
该数据集是一个大规模的、面向生产的尼泊尔语文本语料库,专为语言模型预训练而构建。
数据集规模
- 文档总数:20,321,968 篇
- 总词元数:1,845,781,044 (BPE 32k)
- 原始文档输入:26,148,451 篇
- 整体保留率:77.72%
数据来源与构成
| 来源 | 保留文档数 | 占总文档比例 | 许可证 |
|---|---|---|---|
| IndicCorp v2 | 17,147,383 | 84.4% | CC0 |
| FineWeb-2 | 1,583,002 | 7.8% | ODC-By |
| IRIIS Nepali | 1,563,850 | 7.7% | 研究用途 |
| Sagarmatha ASR text | 27,733 | 0.1% | 作者自有 |
| 总计 | 20,321,968 | 100% | - |
数据字段
| 字段 | 类型 | 描述 |
|---|---|---|
id |
string | 唯一文档标识符(格式:{source}:{original_id}) |
text |
string | 经过清洗和NFC规范化的天城体尼泊尔语文本 |
source |
string | 数据来源:indiccorp, fineweb2, iriis, 或 sagarmatha |
质量认证
- 结论:FIT TO TRAIN(适合训练)
- 硬性检查:通过
- 警告:无(零警告)
- 人工抽检:300 篇文档全部通过
- 二进制校验:通过(SHA-256完整性,分片合约)
- 可逆性:通过(保留数据与剔除数据总和等于原始输入)
数据集划分
- 训练集词元:1,827,236,028
- 验证集词元:9,320,924
- 测试集词元:9,224,092
- 总分片数:21(19个训练分片 / 1个验证分片 / 1个测试分片)
- 词表大小:32,000(SentencePiece BPE)
- 已见词元类型:31,091 / 32,000 (97.16%)
所用语言
- 语言:尼泊尔语 (
ne) - 文字:天城体 (
Devanagari) - 平均天城体字符比率:1.00(纯脚本,无拉丁字符污染)
数据处理流程(八阶段流水线)
- 获取:从源API流式获取原始文档
- 清洗:Unicode NFC标准化、天城体字体转换、脚本比率预过滤
- 精确去重:在同一来源内进行SHA-1哈希去重
- 语言识别:GlotLID过滤,保留尼泊尔语天城体且得分>=0.6的文档;对混合语言文档进行行级过滤
- 跨来源精确去重:在所有来源(合并后)进行SHA-1去重
- 近似去重:MinHash LSH,Jaccard相似度>=0.8时移除近似重复段落
- 质量标注与过滤:超过25个信号门控(词数、天城体比率、数字比率、拉丁比率、KenLM困惑度、n-gram重复率、停用词比率等)
- 拆分与打包:基于哈希键的确定性训练/验证/测试集拆分,然后进行SentencePiece BPE词元化,打包为uint16分片用于训练
使用方式
python from datasets import load_dataset
加载完整语料库(约8GB Parquet下载)
ds = load_dataset("tonibirat/neBrahma-Nepali-Pretrain-Corpus")
按来源过滤
indiccorp_only = ds["train"].filter(lambda x: x["source"] == "indiccorp")
流式迭代(适用于大规模使用)
ds_stream = load_dataset("tonibirat/neBrahma-Nepali-Pretrain-Corpus", streaming=True) for example in ds_stream["train"]: text = example["text"] src = example["source"]
局限性
- IRIIS众包噪声:IRIIS子集依赖众包转录,尽管通过了质量过滤,但可能仍存在潜在的不准确之处。
- 无人口统计学元数据:未包含说话人、方言或领域元数据。可通过
source字段获取来源信息。 - Sagarmatha ASR部分较小:Sagarmatha ASR文本子集(27,733篇文档,0.1%)由短话语级转录组成,由于ASR转录的句子较短,保留率较低(54.6%)。
- EDA样本:文档级EDA可视化基于20万文档样本,而非全部2030万文档。分片级别的词元统计是精确的(基于全部21个分片计算)。
- 许可合规性:IndicCorp v2为CC0,FineWeb-2为ODC-By(需注明出处),IRIIS为研究用途分发。请根据您的使用场景验证合规性。
数据集标签
- 类别:文本生成
- 标签:尼泊尔语、天城体、预训练、大语言模型、文本语料库、neBrahma
- 大小类别:10M < n < 100M