
somosnlp-hackathon-2025/exam_zh_multitopic_dialect_culture
收藏数据链接:
官方服务:
资源简介:
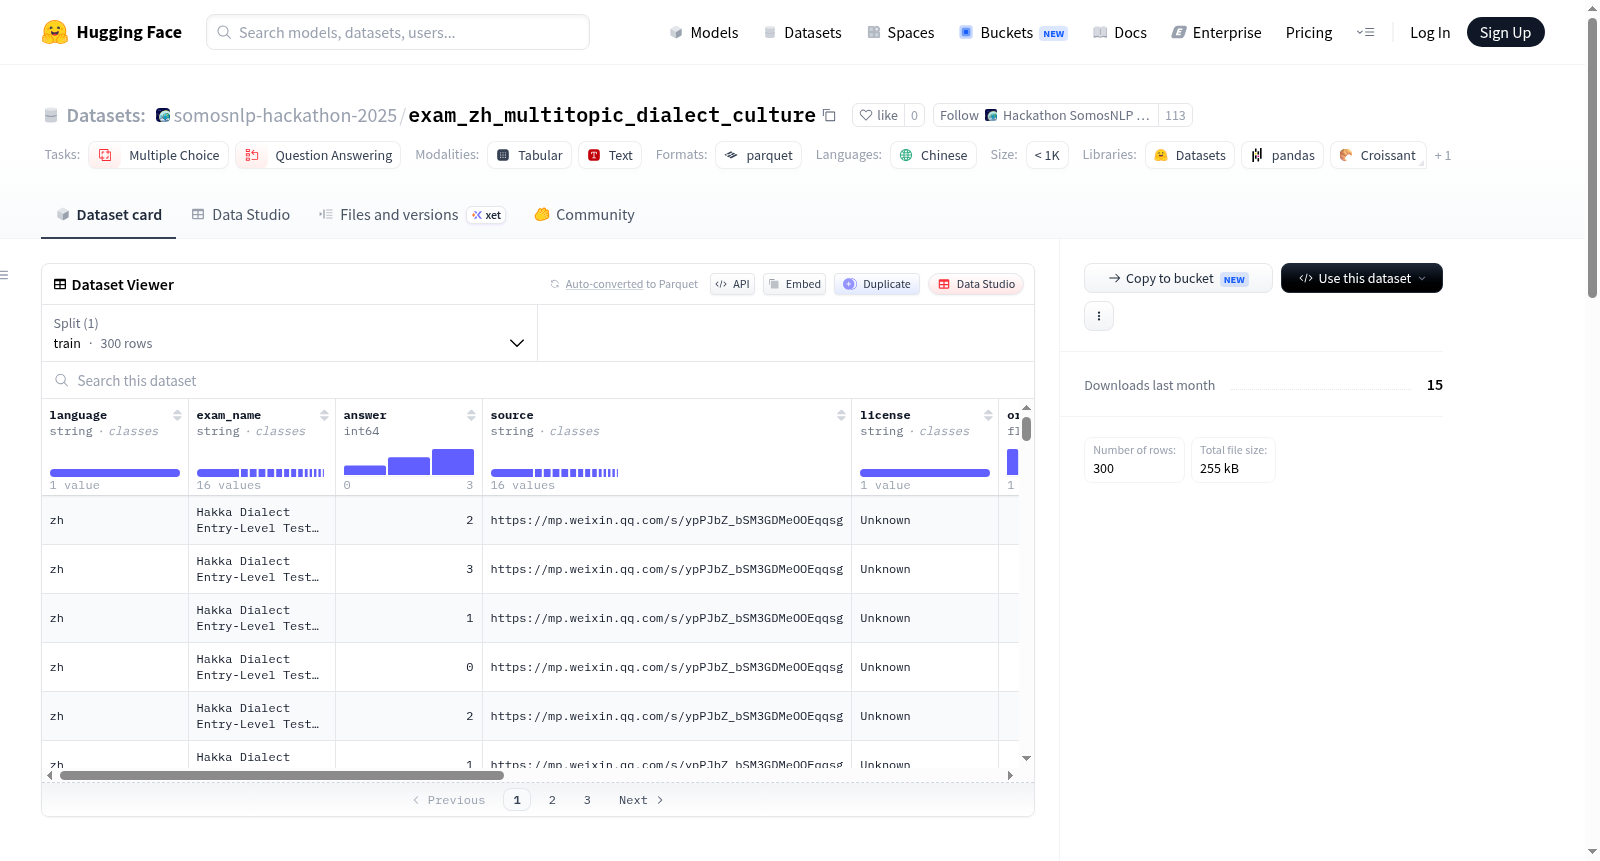
这是一个包含300个选择题的数据集,来源于多种普通话为基础的评估,包括地区方言理解和文化和一般知识评估。数据覆盖了客家话、长沙话、闽南话、陕北话、四川话、南昌话、上海话和广东话等多种方言,以及互联网俚语测试、歇后语识别、古汉语词汇意义理解等内容。
This dataset contains 300 multiple-choice questions from a variety of Mandarin-based assessments, covering both regional dialect comprehension and cultural/general knowledge. It spans dialects such as Hakka, Changsha, Hokkien, Northern Shaanxi, Sichuan, Nanchang, Shanghainese, and Cantonese, as well as topics like Chinese Internet slang tests, Xiehouyu recognition, and classical Chinese lexical meaning comprehension.
搜集汇总
数据集介绍
构建方式
该数据集名为Chinese Dialect & Culture Exam Dataset,由SomosNLP Hackathon 2025项目构建,专注于中文方言与文化领域的多项选择题。数据集共包含300道题目,来源于公开的中文考试与测验,涵盖两大核心类别:一是方言理解类,涉及客家话(梅州)、长沙话、闽南语、陕北方言、四川话、南昌话、上海话及粤语等八种主要方言;二是文化常识类,包括中国网络流行语测试、歇后语识别、古汉语词义理解及2013年上海市初中社会学科考试题目。每条数据以JSON格式组织,字段包括语言、考试名称、答案、来源、许可证、难度等级、选项、原始题目编号及问题内容等,确保结构清晰、信息完整。
特点
该数据集具有鲜明的多主题融合特性,将方言测试与文化知识评估有机结合,为中文自然语言处理提供了独特的资源。其核心特点在于题目来源的多样性,既有地域性强的方言理解题,也有反映当代网络文化与古典汉语的题目,覆盖语言学、文化与社会等多个领域。数据集的难度分级明确,按语言测试与文化知识分类,便于研究者针对不同任务进行筛选。此外,题目均以中文呈现,且包含标准化的选项与正确答案,适合用于多项选择问答模型的训练与评估,尤其适用于跨方言与文化背景的细粒度语言理解任务。
使用方法
该数据集可直接用于微调或评估中文多项选择问答模型,如BERT、RoBERTa或GPT系列等。使用方法简单,通过Hugging Face Datasets库加载,指定配置名称为'default',即可获取训练集(共300条样本)。每条数据包含问题、选项列表及正确答案索引,研究者可将问题与选项拼接为输入文本,将答案索引作为标签,进行监督学习。数据集适合用于方言理解、文化常识问答等任务的零样本或少样本评估,也可作为中文语言理解基准测试的一部分。注意部分题目来源的许可证标注为'Unknown',使用时应遵守相关版权规定。
背景与挑战
背景概述
在自然语言处理领域,中文语料库的构建长期集中于标准普通话,对方言与文化多样性的关注相对匮乏。为此,SomosNLP团队在2025年发起了这场黑客马拉松,旨在填补这一空白。该数据集由多位研究者协作创建,核心研究问题聚焦于如何系统性地评估模型在多方言理解与文化常识推理上的能力。数据集收录了300道来自客家话、闽南语、粤语等八种主要方言及网络俚语、歇后语等文化测试的多选题,覆盖语言与文化两大维度。这一资源不仅推动了多方言自然语言理解的研究,也为评估中文大语言模型在真实地域文化场景中的表现提供了基准,对提升模型在中文社区的适用性和包容性具有重要意义。
当前挑战
该数据集所面临的挑战体现在多个层面。首先,方言理解任务本身极具难度,同一概念在不同方言中可能对应截然不同的词汇或语法结构,且方言数据稀缺、标注成本高昂,给模型学习带来巨大障碍。其次,文化知识类题目如网络俚语和歇后语依赖于动态演变的社群语境,模型难以捕捉其隐含语义与修辞关系。此外,数据构建过程中,题目来源分散于各类公开考试与网络资源,需人工整理与校验,确保问题与选项的准确性和一致性,而样本量仅300条,限制了模型泛化能力的充分验证。最后,方言语音与文字间的非对应性进一步加剧了多模态理解的研究挑战。
常用场景
经典使用场景
该数据集汇聚了300道源自普通话考试的多选题,横跨方言理解与文化通识两大领域。在自然语言处理研究中,它常被用于构建和评估多任务学习模型,特别是在方言识别、文化常识问答及跨领域知识迁移等场景中。研究者可借此测试模型在方言多样性(如客家话、粤语、赣语)与文化概念(如歇后语、网络用语)上的理解能力,从而推动语言模型在中文多主题环境下的泛化性能提升。
解决学术问题
该数据集直面中文语言模型在方言与文化知识融合上的学术短板。传统评估多聚焦于标准普通话,忽略了方言多样性及文化背景对语义理解的影响。它解决了模型在方言词汇、语法结构及文化隐喻上的零样本迁移难题,为探究语言变体与通用知识之间的交互提供了基准。其意义在于促进语言学与计算科学的交叉研究,推动模型从单一语言范式向多模态、多文化理解的演进。
衍生相关工作
该数据集衍生了多项前沿工作,包括基于对比学习的方言表征模型,通过挖掘不同方言间的语义共性来提升迁移学习效果;以及融合文化知识图谱的多任务问答系统,利用歇后语与古典词汇数据增强模型的隐喻推理能力。此外,还有研究将其与大规模预训练语言模型结合,开发了针对中文方言的零样本适应方法,显著降低了模型在低资源方言上的标注成本,为语言多样性保护提供了技术支撑。
以上内容由遇见数据集搜集并总结生成


