遇见数据集

ghananlpcommunity/ghana-speech

收藏
Hugging Face2026-07-21 更新2026-07-22 收录
官方服务:

资源简介:

这是一个多语言音频数据集,包含多种非洲语言,如Akuapem Twi、Anyin、Asante Twi、Avatime、Bassar Ntcham、Bimoba、Birifor Southern、Bissa、Buli、Chumburung、Dagaare、Dagbani、Dangme、Deg、Ewe、Fante、Fulfulde Maasina、Gikyode、Gonja、Hausa、Kabiye、Kasem、Konkomba、Konni、Kusaal、Lelemi、Mampruli、Nawuri、Ninkare、Nkonya、Ntrubo、Nzema、Paasaal、Sehwi、Sekpele、Selee、Sisaala Tumulung、Siwu、Tampulma、Tem、Tuwuli和Vagla。每个语言配置包含音频(采样率为16000Hz)和对应的文本转录,用于训练任务,支持语音识别或语音合成等NLP应用。

This is a multilingual audio dataset containing various African languages, such as Akuapem Twi, Anyin, Asante Twi, Avatime, Bassar Ntcham, Bimoba, Birifor Southern, Bissa, Buli, Chumburung, Dagaare, Dagbani, Dangme, Deg, Ewe, Fante, Fulfulde Maasina, Gikyode, Gonja, Hausa, Kabiye, Kasem, Konkomba, Konni, Kusaal, Lelemi, Mampruli, Nawuri, Ninkare, Nkonya, Ntrubo, Nzema, Paasaal, Sehwi, Sekpele, Selee, Sisaala Tumulung, Siwu, Tampulma, Tem, Tuwuli, and Vagla. Each language configuration includes audio (sampled at 16000 Hz) and corresponding text transcriptions, designed for training tasks, supporting NLP applications like speech recognition or speech synthesis.

提供机构:
ghananlpcommunity
原始信息汇总

数据集概述:ghana-speech

基本信息

  • 数据集名称:ghana-speech
  • 发布机构:Ghana NLP Community
  • 许可协议:CC BY-NC 4.0(仅限非商业研究与教育用途,需注明出处)
  • 数据类型:音频与文本
  • 数据格式:Parquet、Optimized Parquet
  • 数据量:约 1,411,467 行,总文件大小 222 GB
  • 数据拆分:仅包含训练集(train
  • 近月下载量:2,023 次

语言覆盖

数据集覆盖 42 个加纳语言子集,包括 Akuapem Twi、Asante Twi、Ewe、Hausa、Fante、Dagbani、Kasem 等。完整列表见下方统计。

数据统计(摘录)

语言 子集 片段数 时长
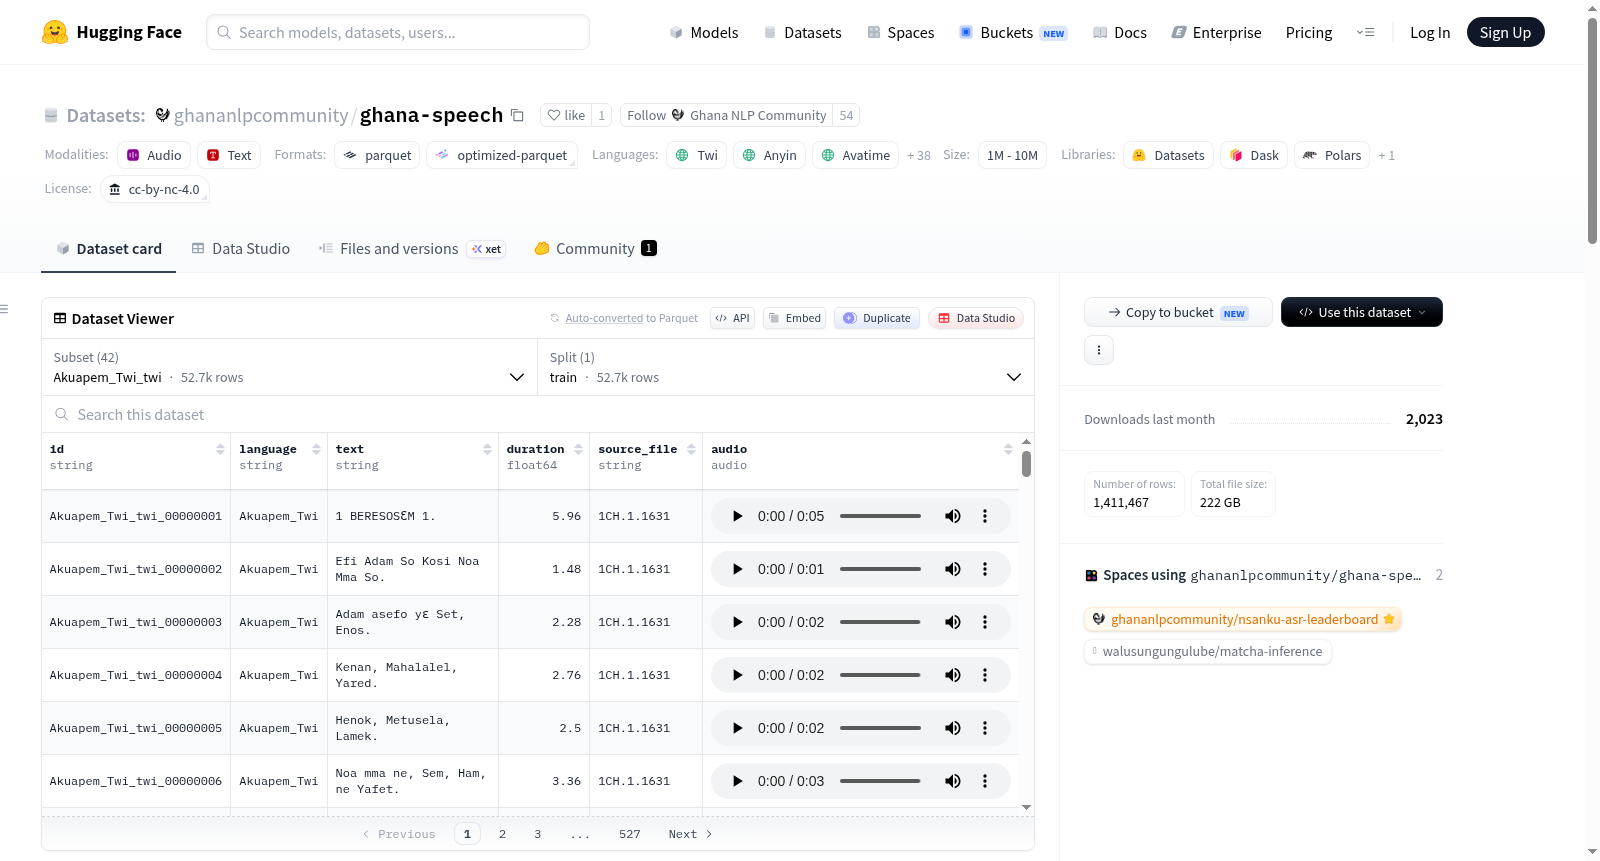
Akuapem_Twi Akuapem_Twi_twi 52,650 63.25 小时
Asante_Twi Asante_Twi_twi 143,383 200.02 小时
Ewe Ewe_ewe 108,240 160.87 小时
Hausa Hausa_hau 92,082 152.77 小时
Fante Fante_fat 60,933 122.03 小时
数据集总计 - 1,411,467 2,246.89 小时

数据样例(Akuapem Twi)

字段 示例值
id Akuapem_Twi_twi_00000001
language Akuapem_Twi
text 1 BERESOSƐM 1.
duration (秒) 5.96
source_file 1CH.1.1631
audio (音频数据)

适用库与工具

  • Datasets
  • Dask
  • Polars
搜集汇总
数据集介绍
ghananlpcommunity/ghana-speech 数据集图片
构建方式
加纳拥有丰富的语言多样性,然而其本土语言的语音资源长期匮乏,制约了相关自然语言处理技术的发展。ghana-speech数据集应运而生,旨在系统性地填补这一空白。该数据集囊括了加纳境内40余种语言,涵盖阿坎语、埃维语、豪萨语等主要语种及其方言变体。其构建方式为:由母语者录制自然语音,经人工转写与校对,生成与音频一一对应的文本标注。每一条数据均包含唯一标识符、语言标签、文本内容、音频时长、源文件路径以及采样率为16kHz的音频文件,最终以JSON格式结构化存储。
特点
ghana-speech数据集的核心特点在于其规模庞大且语言覆盖范围广,总计包含超过200万条语音-文本对,音频总时长逾数千小时。每一种语言子集均独立成配置,如Akuapem_Twi_twi包含52650条样本,Asante_Twi_twi则高达143383条,便于研究者按需选取。数据集的构建严格遵循高质量原则,所有语音均由母语者在安静环境中录制,并由语言学专家进行文本校对,从而确保了语料在声学与语言层面的双重可靠性。这为跨语言语音识别、语言资源保护以及低资源语言建模研究提供了坚实的数据基础。
使用方法
在HuggingFace平台上,用户可通过datasets库便捷地加载该数据集。以Python为例,使用load_dataset()函数并指定相应的配置名称,例如load_dataset('ghana-speech', 'Asante_Twi_twi')即可获取特定语言的子集。每个样本以字典形式呈现,包含id、language、text、duration、source_file及audio字段,其中audio字段为包含音频阵列和采样率的字典。用户可直接利用其进行模型训练,或结合transformers库中预训练的语音识别模型(如Wav2Vec2)进行下游任务微调,实现特定语种的语音转文本功能。数据仅提供训练集,未划分验证与测试集,研究者需自行依据需求进行数据拆分。
背景与挑战
背景概述
加纳拥有丰富的语言生态,境内通行着超过70种本土语言,然而绝大多数语言在语音技术领域处于近乎空白的状态。ghana-speech数据集正是在这一背景下应运而生,致力于为加纳低资源语言构建首个大规模、多语种的语音识别基准资源。该数据集涵盖了阿坎语、埃维语、豪萨语等30余种加纳本土语言,由加纳本土语言学家与科技机构合作收集与标注,旨在弥合非洲语言在自动语音识别领域的鸿沟。作为目前覆盖加纳语言种类最广的开源语音数据集,ghana-speech为低资源语音识别、语码转换研究及西非语言技术发展提供了关键支撑,并推动了全球语音技术在多语种、低资源环境下的普惠进程。
当前挑战
该数据集所面临的领域挑战根植于加纳语言的极度多样性与资源匮乏。绝大多数加纳语言缺乏标准化的正字法,书面语与口语之间存在显著差异,导致声学与语言模型建模极为困难。同时,音频录制的环境噪声、发音人口音变异以及录音设备的不一致性,进一步加剧了声学特征的复杂性。在数据集构建过程中,挑战同样显著。招募覆盖30余种语言且具备语言学素养的录音与标注人员困难重重,不同语言之间缺乏共享的语音学标记体系。此外,确保每种语言达到足够且均衡的时长(如部分语言仅数千条数据)以及音频与文本的对齐准确度,对资源调配和质量控制提出了极高要求。
常用场景
经典使用场景
在语音技术研究领域,ghana-speech数据集为构建和评估多语种语音识别系统提供了宝贵的资源。该数据集涵盖了加纳及其周边地区的数十种本土语言,例如阿坎语系的阿散蒂契维语、埃维语、豪萨语等,每种语言均包含大量带有文本标注的语音样本。经典使用场景在于训练端到端的自动语音识别模型,特别是在资源匮乏的非洲语言上推进基于深度学习的语音转文本技术,从而弥补主流语种与低资源语言之间的发展鸿沟。
衍生相关工作
基于ghana-speech数据集,学界已衍生出一系列具有代表性的研究工作。例如,研究者利用该数据集对比了wav2vec 2.0、Whisper等预训练模型在不同加纳语言上的微调效果;亦有工作专注于探索数据增强与自监督学习策略对提升识别准确率的影响。此外,该数据集还催生了面向低资源语言的语音语料库构建标准与评测基准,为后续的跨语种迁移学习和多语言语音合成系统开发奠定了重要的方法论基础。
数据集最近研究
最新研究方向
当前,加纳语音数据集(ghana-speech)正成为推动非洲低资源语言语音技术发展的关键基石。研究前沿聚焦于利用该数据集包含的来自加纳的数十种本土语言(如阿坎语的特威方言、埃维语、豪萨语等)的高质量音频-文本对,突破传统语音识别模型对数据量的依赖。研究者正借助迁移学习与自监督预训练范式,探索在极度稀缺数据条件下构建鲁棒的端到端语音识别系统,旨在弥合非洲大陆在人工智能语音服务上的数字鸿沟。该数据集的出现同步呼应了全球对语言多样性与文化包容性的迫切关注,其不仅为加纳本土的智能语音助手与教育工具落地提供了训练基础,更对实现联合国教科文组织倡导的语言遗产数字化保护具有深远的社会与学术意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务