遇见数据集

kjappelbaum/chemnlp-orbnet-denali

收藏
Hugging Face2023-11-07 更新2024-03-04 收录
官方服务:

资源简介:

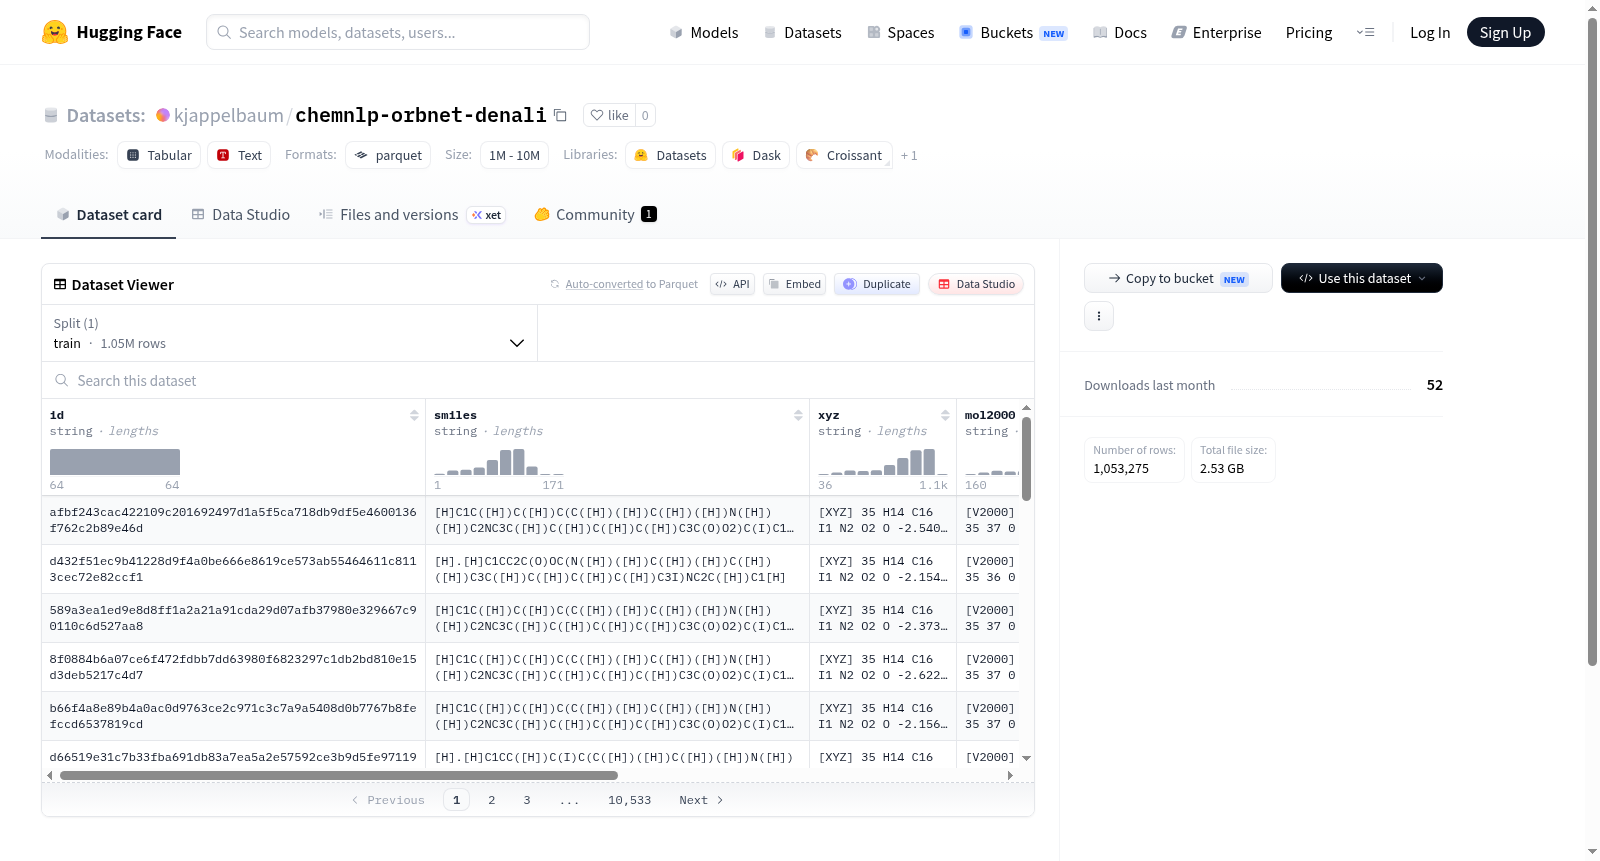
--- dataset_info: features: - name: id dtype: string - name: smiles dtype: string - name: xyz dtype: string - name: mol2000 dtype: string - name: mol3000 dtype: string - name: charge dtype: int64 - name: dft_energy dtype: float64 - name: xtb1_energy dtype: float64 splits: - name: train num_bytes: 6436401032 num_examples: 1053275 download_size: 2534938845 dataset_size: 6436401032 configs: - config_name: default data_files: - split: train path: data/train-* --- # Dataset Card for "chemnlp-orbnet-denali" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

数据集信息: 特征字段: - 字段名:id 数据类型:字符串 - 字段名:smiles(简化分子线性输入规范,Simplified Molecular-Input Line-Entry System) 数据类型:字符串 - 字段名:xyz(分子坐标文本格式) 数据类型:字符串 - 字段名:mol2000 数据类型:字符串 - 字段名:mol3000 数据类型:字符串 - 字段名:charge 数据类型:64位整型 - 字段名:dft_energy(密度泛函理论能量) 数据类型:64位浮点型 - 字段名:xtb1_energy(扩展紧束缚近似计算能量) 数据类型:64位浮点型 数据划分: - 划分名称:train(训练集) 字节大小:6436401032 样本数量:1053275 下载大小:2534938845 数据集存储大小:6436401032 配置项: - 配置名称:default(默认配置) 数据文件: - 划分:train(训练集) 路径:data/train-* --- # "chemnlp-orbnet-denali"数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
kjappelbaum
原始信息汇总

数据集概述

数据集信息

  • 特征列表

    • id: 类型为字符串
    • smiles: 类型为字符串
    • xyz: 类型为字符串
    • mol2000: 类型为字符串
    • mol3000: 类型为字符串
    • charge: 类型为整数
    • dft_energy: 类型为浮点数
    • xtb1_energy: 类型为浮点数
  • 数据分割

    • train: 包含1053275个样本,占用6436401032字节
  • 数据集大小

    • 下载大小: 2534938845字节
    • 实际大小: 6436401032字节

配置信息

  • 默认配置
    • 数据文件路径: data/train-*
搜集汇总
数据集介绍
kjappelbaum/chemnlp-orbnet-denali 数据集图片
构建方式
在计算化学与材料科学领域,高质量分子数据集对量子化学模型的训练至关重要。kjappelbaum/chemnlp-orbnet-denali数据集通过整合多种分子表示与能量标签构建而成,收录了超过105万条训练样本。每条样本包含SMILES字符串、分子构象的XYZ坐标、两种不同精度级别的分子描述符(mol2000与mol3000)、电荷量以及由密度泛函理论(DFT)计算得到的参考能量,同时辅以半经验方法xTB1计算的能量值,形成多层次能量预测基准。
使用方法
使用该数据集时,研究者可直接通过HuggingFace Datasets库加载默认配置下的训练分片,数据以Parquet格式存储,便于高效读取。建议将SMILES与XYZ作为输入特征,以dft_energy为目标变量,构建回归模型;亦可利用xtb1_energy作为低成本近似,探索迁移学习或多任务学习策略。数据集的规模与结构化设计使其天然适用于图神经网络、Transformer等深度学习架构的分子能量预测任务。
背景与挑战
背景概述
在计算化学与材料科学领域,量子化学计算为分子性质预测提供了高精度的基准,然而高昂的计算成本限制了其在大规模分子库中的应用。为缓解这一瓶颈,研究者致力于开发基于机器学习的替代模型,其中高质量、大规模的分子能量数据集成为关键资源。kjappelbaum/chemnlp-orbnet-denali数据集由相关研究团队于近年创建,专注于提供分子在DFT(密度泛函理论)与半经验xTB方法下的能量对比数据,核心研究问题在于利用大规模化学语言建模,探索从分子结构(SMILES表示)到量子化学能量的映射关系。该数据集包含超过百万个样本,涵盖分子几何构型、电荷信息及多层级能量标签,为训练和评估分子性质预测模型提供了丰富素材,对推动化学信息学与机器学习交叉领域的进展具有重要影响力。
当前挑战
该数据集面临的首要挑战在于解决分子能量预测的领域难题:DFT计算虽精确但耗时,xTB方法虽快速却精度有限,如何构建能同时捕捉两者差异并逼近DFT精度的机器学习模型,是核心科学问题。此外,数据集构建过程中遭遇多重挑战:其一,从庞大化学空间筛选代表性分子以确保泛化能力,需平衡多样性、稳定性与计算资源;其二,统一处理不同来源的分子表示(如SMILES与XYZ坐标)并保证格式一致性,涉及复杂的数据清洗与标准化流程;其三,管理超过1百万样本的训练集,对存储、索引及分布式处理提出了工程化要求,尤其在保持数据完整性的前提下实现高效访问与加载。
常用场景
经典使用场景
在计算化学与机器学习交叉领域,kjappelbaum/chemnlp-orbnet-denali数据集凭借其覆盖逾百万有机分子、包含SMILES表示、三维分子构象(XYZ坐标)及DFT与xTB1能量标签的丰富特性,成为量子化学性质预测研究的基石。研究者常利用该数据集训练图神经网络或等变模型,以从分子结构出发高精度地预测其能量属性,从而规避昂贵的第一性原理计算。这一经典范式不仅推动了分子性质预测的基准建立,更在原子间势能面建模与构象能量排序任务中展现出卓越的泛化能力。
解决学术问题
该数据集精准回应了计算化学领域长期面临的“精度-效率悖论”——传统DFT计算虽准确但耗时,而经验力场则牺牲精度。通过提供大规模、多层次的分子能量标签(DFT能量与xTB1能量),它使得机器学习模型得以学习从低精度到高精度的能量映射,从而在维持量子化学精度的前提下将推理速度提升数个数量级。这一突破显著降低了反应路径搜索、催化剂筛选及分子动力学模拟的计算成本,为高通量虚拟筛选与材料基因组学提供了可靠的数据基础设施。
实际应用
在实际药物发现与材料设计场景中,该数据集赋能了从分子草图到能量评估的无缝闭环。制药企业可借助预训练模型快速评估候选分子的热力学稳定性,优先合成具有低能构象的化合物;在有机光电材料领域,它支持对数千种分子进行能量带隙与反应活性的批量预测,加速了高性能材料的发现周期。此外,该数据集还与自动化合成平台耦合,通过实时能量预测指导实验参数调整,显著缩短了“设计-合成-测试”循环。
数据集最近研究
最新研究方向
在计算化学与材料科学的前沿领域,分子能量预测与结构优化始终是推动新物质发现的核心驱动力。kjappelbaum/chemnlp-orbnet-denali数据集凭借其超过百万条涵盖SMILES表示、三维原子坐标(xyz)以及多层级能量标签(DFT与半经验xTB方法)的分子样本,为机器学习模型在量子化学精度与计算效率之间的平衡探索提供了宝贵资源。当前,该数据集正被广泛用于训练和评估图神经网络与等变架构,特别是在预测分子总能量、反应势能面以及催化活性位点等方向展现出显著优势。其与OrbNet等前沿模型的结合,不仅加速了高通量虚拟筛选流程,还推动了可迁移力场与通用势函数的发展,为绿色化学与新能源材料的设计带来了切实可行的计算范式。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务