atc-train-1gb-5s
收藏资源简介:
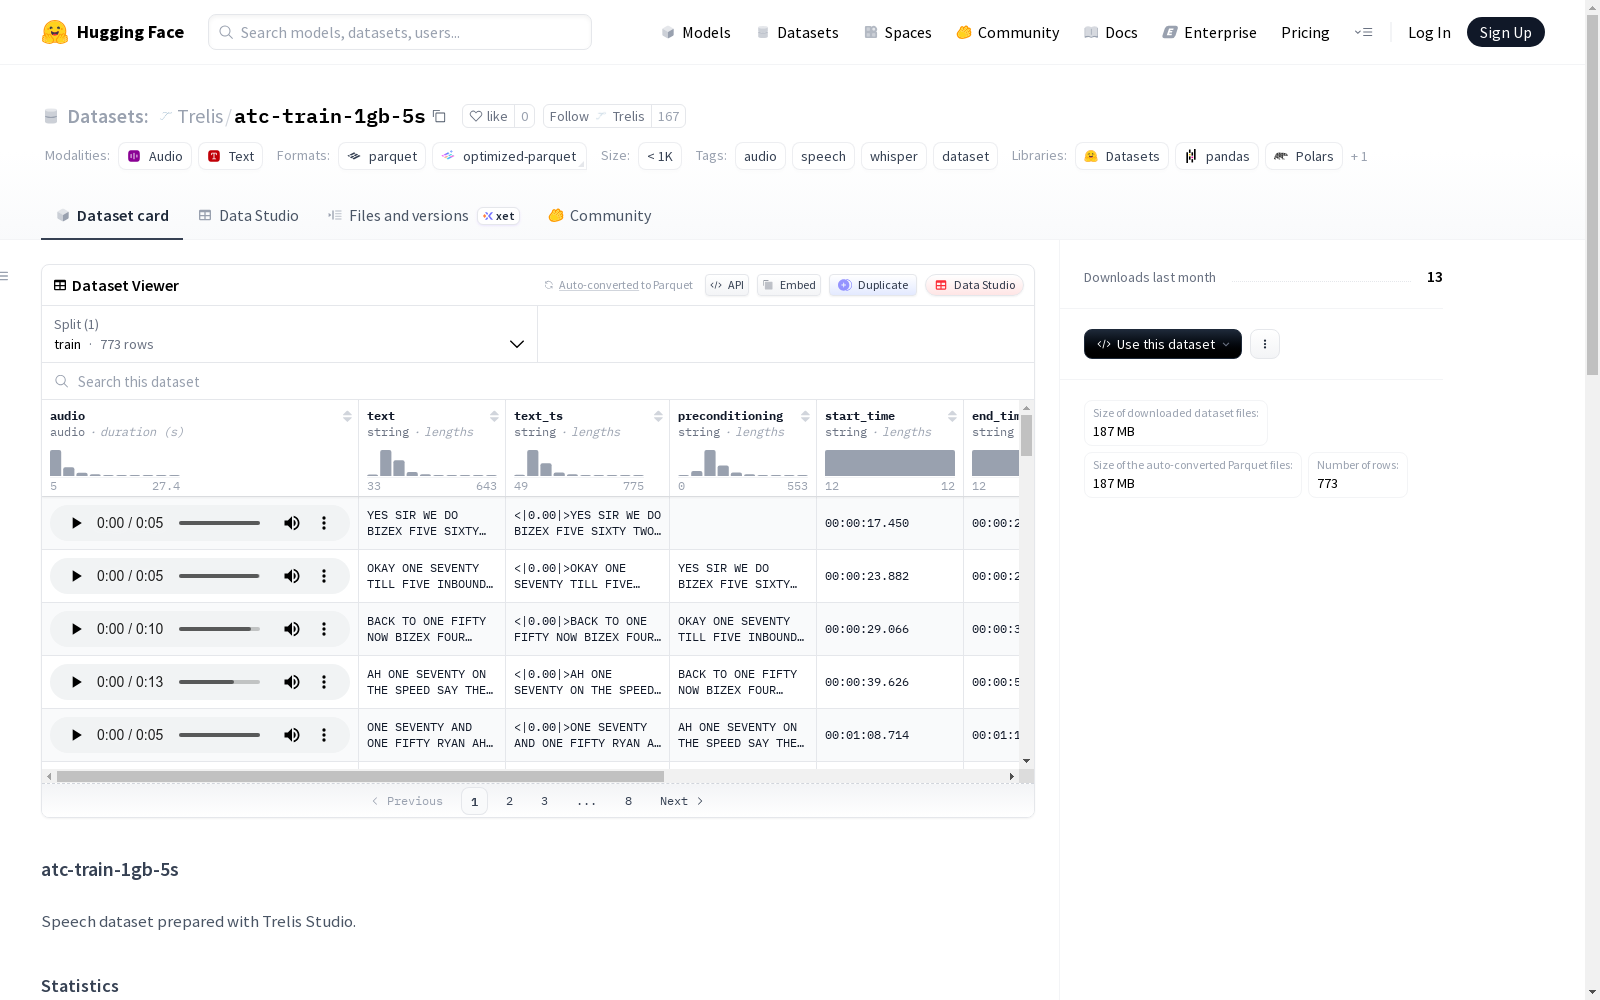
atc-train-1gb-5s 是一个专注于音频和语音的数据集,特别适用于 Whisper 模型。该数据集由 Trelis Studio 准备,包含 5 个源文件,773 个训练样本,总时长为 587.1 分钟。数据集中的每个样本包含以下字段:音频片段(16kHz,经过 VAD 处理去除静音)、纯文本转录、带 Whisper 时间戳标记的转录、原始音频中的片段开始和结束时间、语音持续时间(不包括静音)、单词级时间戳以及源文件名。音频片段经过 Silero VAD 处理,以确保训练数据与推理行为匹配。对于 Whisper 时间戳训练,建议使用两桶方法:50% 使用纯文本转录,50% 使用带时间戳标记的转录。
atc-train-1gb-5s is an audio and speech-focused dataset specifically tailored for the Whisper model. Curated by Trelis Studio, this dataset includes 5 source files, 773 training samples, with a total duration of 587.1 minutes. Each sample in the dataset contains the following fields: audio clips (16kHz, with silences removed via VAD processing), raw text transcriptions, transcriptions with Whisper timestamps, start and end timestamps of the clips in the original audio, speech duration (excluding silences), word-level timestamps, and source file names. The audio clips are processed using Silero VAD to ensure consistency between the training data and inference behavior. For Whisper timestamp training, the two-bucket approach is recommended: 50% of the training data uses raw text transcriptions, while the other 50% uses transcriptions with timestamp markers.
atc-train-1gb-5s 数据集概述
数据集简介
这是一个语音数据集,专为Whisper模型准备,由Trelis Studio处理生成。
数据集统计
| 指标 | 数值 |
|---|---|
| 源文件数量 | 5 |
| 训练样本数量 | 773 |
| 总时长 | 587.1分钟 |
数据列说明
| 列名 | 类型 | 描述 |
|---|---|---|
audio |
Audio | 音频片段(16kHz),经过语音活动检测(VAD)处理,仅保留语音部分,静音已被剥离。 |
text |
string | 纯文本转录(不含时间戳),向后兼容。 |
text_ts |
string | 包含Whisper时间戳标记的转录(例如:`< |
start_time |
string | 片段在原始音频中的开始时间(HH:MM:SS.mmm格式)。 |
end_time |
string | 片段在原始音频中的结束时间(HH:MM:SS.mmm格式)。 |
speech_duration |
float | 片段中语音的持续时间(不包括静音)。 |
word_timestamps |
list | 词级时间戳(相对于仅包含语音的音频)。 |
source_file |
string | 原始音频文件名。 |
语音活动检测(VAD)处理
音频片段使用Silero VAD进行处理,以匹配faster-whisper推理过程:
- 静音从音频中被剥离,仅保留语音区域。
- 时间戳是相对于拼接后的纯语音音频的。
- 这确保了训练数据与推理行为相匹配。
训练使用建议
对于Whisper时间戳训练,建议使用双桶方法:
- 桶 A (50%):使用
text列,即不含时间戳的纯文本转录。 - 桶 B (50%):使用
text_ts列,即包含Whisper时间戳标记的转录。
加载方式
python from datasets import load_dataset dataset = load_dataset("Trelis/atc-train-1gb-5s")