
ByteDance-Seed/EdgeBench
收藏官方服务:
资源简介:
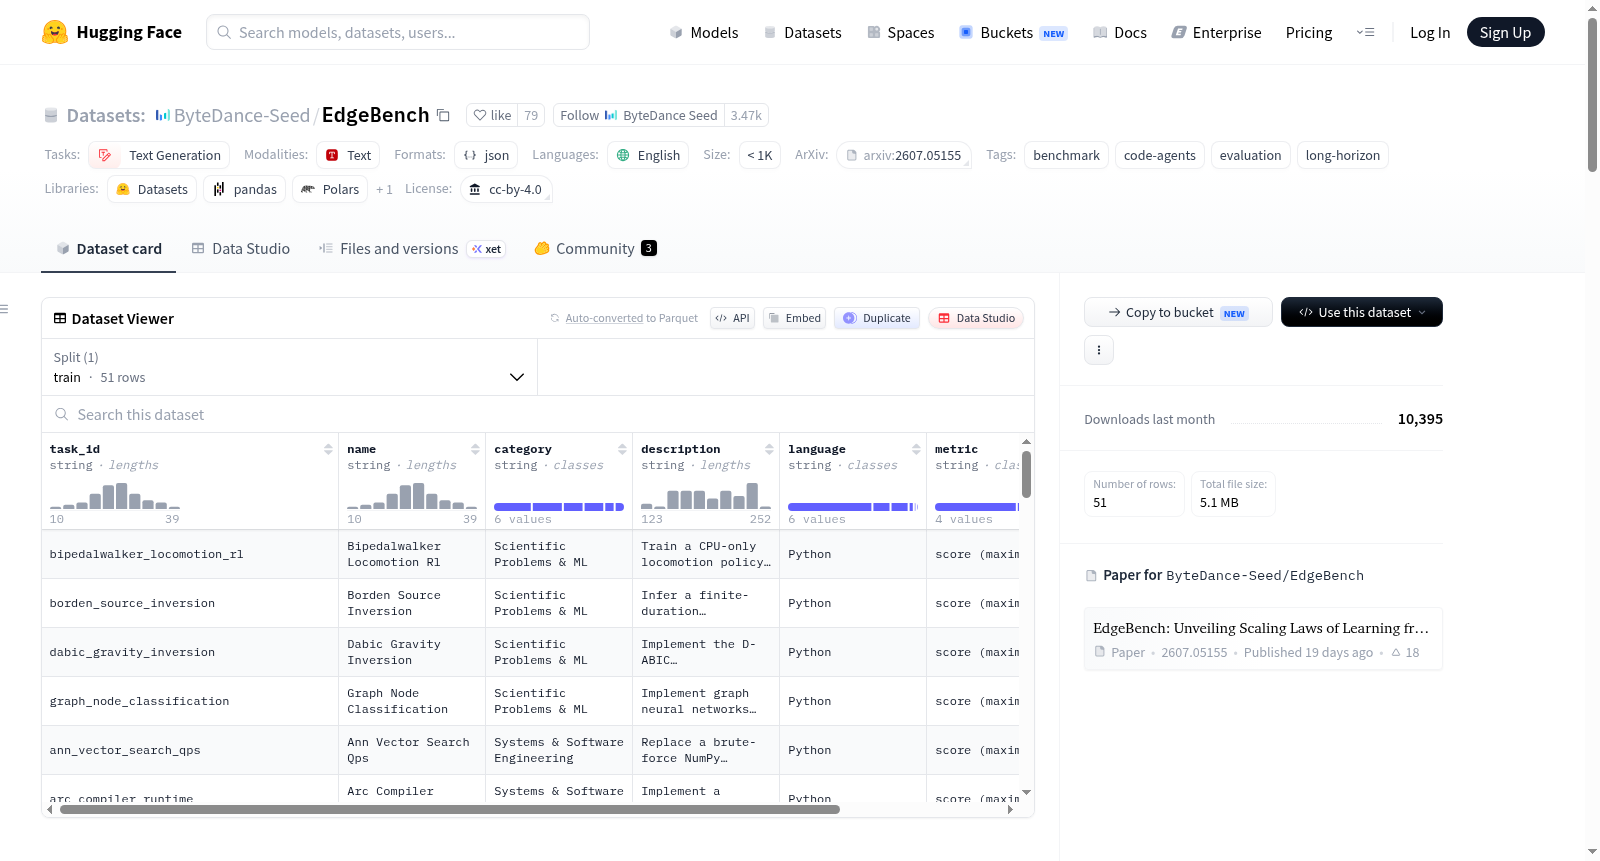
EdgeBench是一个用于评估自主AI代理从现实世界环境中学习能力的基准数据集,包含134个真实世界任务(其中51个公开)。该数据集通过将代理置于具有现实多级反馈的可执行任务环境中,让每个任务迭代12小时以上,以跟踪学习改进的全轨迹,而非仅衡量最终性能。任务涵盖六个能力类别:科学与机器学习、系统与软件工程、优化、知识、形式化、游戏,并包含完整的评估框架SForge。
EdgeBench is a benchmark of 134 real-world tasks for evaluating how autonomous AI agents learn from real-world environments. Instead of measuring one-shot performance, EdgeBench places agents in executable task environments with realistic, multi-level feedback and lets them iterate for 12+ hours per task — tracking the full trajectory of improvement, not just the final score. We publicly release 51 tasks along with the full evaluation framework.
提供机构:
ByteDance-Seed搜集汇总
数据集介绍
构建方式
EdgeBench由字节跳动Seed团队构建,旨在评估自主AI代理在真实世界环境中的学习能力。其构建核心基于134项真实世界任务,涵盖科学机器学习、系统与软件工程、优化、知识应用、形式化验证及游戏六大能力类别。其中51项任务被公开释放。每项任务均设计为天级挑战,具有足够高的性能天花板,以确保当前任何代理均无法轻易饱和。该基准的独特之处在于,它赋予代理在可执行任务环境中超过12小时的迭代时间,并记录完整的改进轨迹,而非仅关注最终得分。最终,通过总计超过38,000小时的代理交互数据,研究者揭示了代理性能随交互时间呈现对数S形标度定律的现象。
特点
EdgeBench的核心特点在于其聚焦于长期学习动态的评估范式。不同于传统基准对一次性表现的测量,EdgeBench强调代理在真实世界环境中通过多层级反馈进行持续改进的能力。其任务设计高度贴近实际应用场景,横跨科学、工程、博弈等多个领域,且每个任务均包含丰富且复杂的反馈信号。更重要的是,基于大规模交互数据,EdgeBench首次系统性揭示了性能改进遵循对数S形标度定律,为理解智能体如何从环境中学习提供了坚实的经验基础。该基准还提供了完整的开源评估框架SForge,支持研究者复现与扩展。
使用方法
使用EdgeBench需通过其配套的SForge评估框架进行配置与运行。研究团队可访问EdgeBench的GitHub仓库获取完整的安装与使用文档。该框架采用双容器架构,专为长期任务代理评估设计。使用时,用户需将待评估的AI代理部署于评估环境中,并根据每项任务的时间预算(如2小时、4小时至12小时等)记录代理的得分轨迹。结果以表格形式呈现,支持按不同时间点与任务类别进行比较。此外,用户可通过提交联系请求访问完整的134项任务集,以进行更全面的研究。
背景与挑战
背景概述
EdgeBench是由字节跳动Seed团队于2026年提出的一个面向自主AI智能体的基准测试数据集,其核心研究问题在于评估智能体在真实世界环境中通过长期交互进行学习的能力。不同于传统基准测试仅关注单次性能,EdgeBench构建了134个跨科学、系统与软件工程、优化、知识、形式化验证及游戏六大能力范畴的日级任务,每个任务允许智能体进行12小时以上的迭代学习,并记录完整的性能提升轨迹。该基准测试揭示了智能体性能随交互时间呈对数S形缩放定律(R²=0.998),从而为理解AI智能体的持续学习机制提供了重要理论基础,对推动自主智能体从实验室走向真实部署具有里程碑式的影响力。
当前挑战
EdgeBench致力于解决的核心领域挑战在于:现有AI智能体评估体系普遍局限于一次性静态测试,无法衡量智能体在复杂真实环境中通过反复试错和长期迭代实现持续改进的动态能力。构建过程中面临的挑战包括:设计134个具有足够高性能上限以防止智能体快速饱和的日级任务,每个任务平均需要57.2小时的人类专家经验(最高320小时);构建支持长时间交互的两容器评估框架SForge以处理超过38,000小时的智能体交互数据;确保任务能够覆盖从科学研究到游戏策略等广泛领域的同时保持难度和评估一致性;以及平衡开源子集(51个任务)与完整数据集之间的代表性,使得基准测试既可作为公开参考又具备足够难度以区分前沿模型,如排名最高的Claude Opus 4.8在12小时后也仅达到51.3%的性能。
常用场景
经典使用场景
EdgeBench作为一个面向自主人工智能体在真实环境中学习能力的基准测试,其最经典的使用场景在于评估和比较不同智能体模型在长时间跨度的复杂任务中的持续改进能力。该数据集包含134项覆盖科学计算、系统工程、优化问题、知识推理、形式化验证与游戏博弈六大类别的真实世界任务,每个任务均提供超过12小时的多层级反馈交互环境。研究者可通过EdgeBench追踪智能体在数万小时的交互轨迹中性能随时间的演化规律,从而深入衡量模型从环境反馈中迭代学习的效率与上限。
衍生相关工作
EdgeBench的发布催生了一系列围绕自主智能体长期学习性能评估与优化的衍生研究工作。其核心技术报告提出并验证的交互时间-性能标度定律直接启发了后续对于模型知识获取曲线的建模与预测方法。同时,基于SForge评估框架的开放源码设计,研究者得以在EdgeBench任务子集上开发强化学习训练策略、反馈机制优化方案以及元学习初始化方法等,这些工作共同推动了对智能体在复杂真实环境中持续演进能力的系统性探究。
数据集最近研究
最新研究方向
以134项真实世界任务为基石,EdgeBench开创性地聚焦于自主AI智能体在长达12小时连续交互中的学习动态,揭示了性能随交互时间遵循对数S形标度定律的普适规律。这一发现颠覆了传统一次性评估的范式,将研究重心转向智能体在复杂现实环境中的持续适应与迭代优化能力。字节跳动Seed团队通过约38,000小时的海量代理交互数据,系统性地量化了模型在科学计算、软件工程、优化决策等六大能力维度上的渐进提升轨迹,为构建真正具备长期自主学习能力的通用智能体奠定了坚实的评测基准。
以上内容由遇见数据集搜集并总结生成


