
Soofi-Project/SOOFI-S-Base-eval-scores
收藏官方服务:
资源简介:
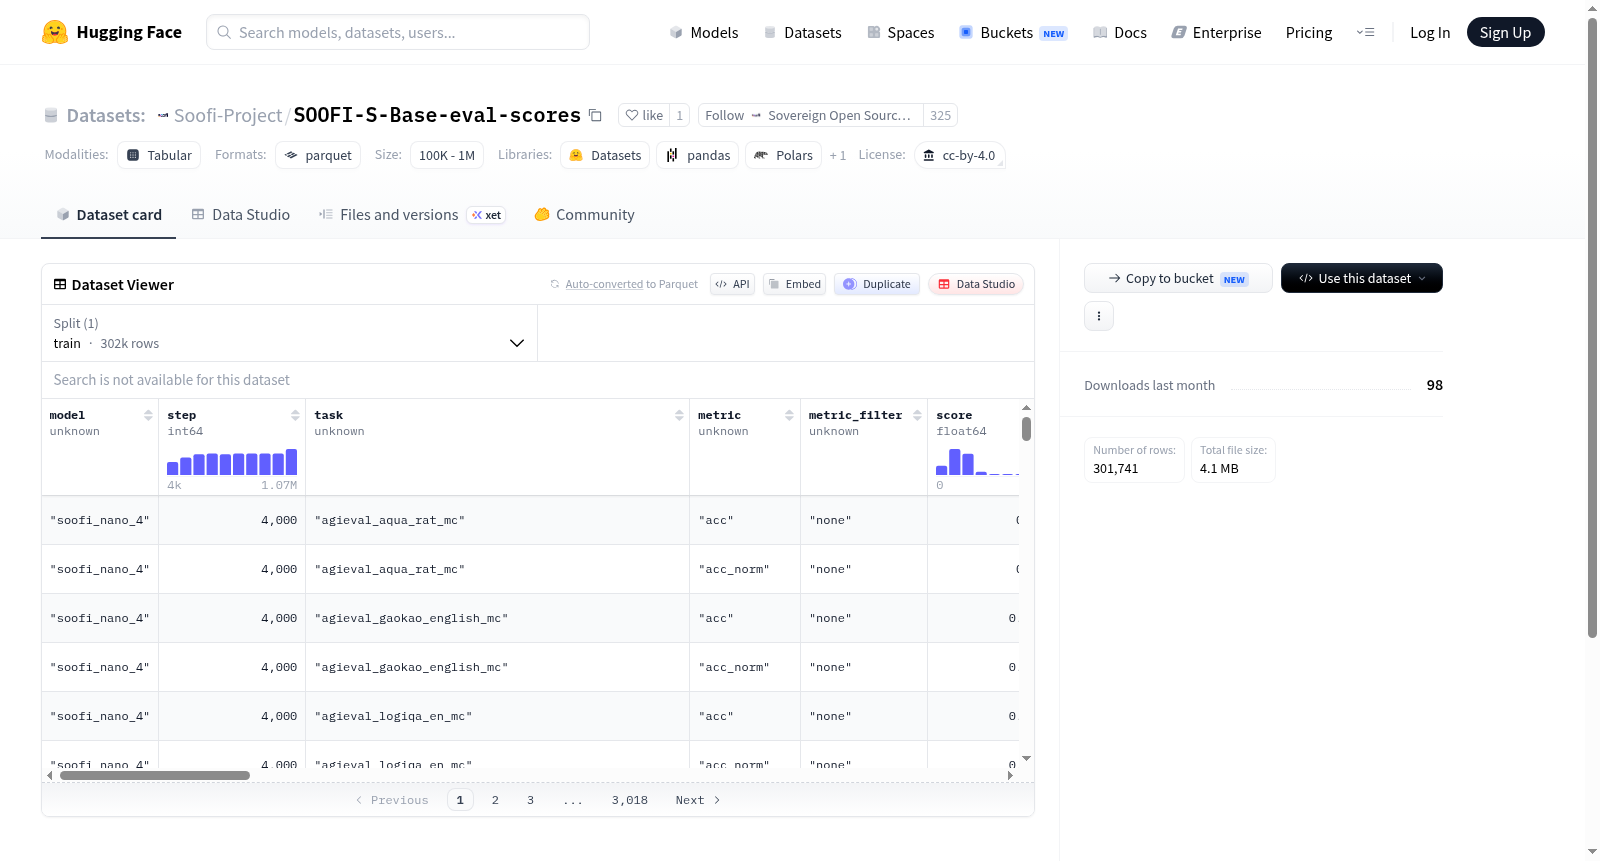
该数据集包含SOOFI-S和SOOFI-S-long-context模型的预训练评估分数,用于基准测试和性能评估。这些分数与ellamind/eval-scores-ref数据集兼容,基准任务定义参考ellamind/base-eval项目,旨在支持模型比较和分析。
This dataset contains pre-training evaluation scores for the SOOFI-S and SOOFI-S-long-context models, intended for benchmarking and performance assessment. The scores are compatible with the ellamind/eval-scores-ref dataset, and benchmark task definitions are referenced from the ellamind/base-eval project, designed to facilitate model comparison and analysis.
提供机构:
Soofi-Project搜集汇总
数据集介绍
构建方式
该数据集汇集了SOOFI-S与SOOFI-S-long-context系列模型在预训练阶段的评估得分,其构建依托于标准化的基准评估流程,并与ellamind/eval-scores-ref数据集保持兼容,确保数据格式与评分体系的一致性。所有评估任务的定义均来源于ellamind/base-eval开源仓库,为模型性能的横向对比提供了可靠依据。
特点
本数据集的显著特点在于其专为SOOFI-S系列模型设计,聚焦于预训练阶段的效能度量,涵盖了从基础版本到长上下文变体的多维度评分。通过与参考数据集的兼容性设计,用户能够便捷地将其纳入已有的评估框架中,从而系统性地追踪模型在标准化任务上的演进与表现。
使用方法
用户可直接加载该数据集以复现或扩展SOOFI-S模型的评估结果,具体使用时需配合ellamind/eval-scores-ref定义的评分基准。建议将本数据集与ellamind/base-eval仓库中的任务定义相结合,以实现对模型能力的精准解读。对于需要自定义评估的场景,可参照原数据集的格式规范进行扩展使用。
背景与挑战
背景概述
SOOFI-S-Base-eval-scores数据集由Ellamind机构创建,发布于2025年,专注于评估大型语言模型(LLM)的预训练性能,核心研究问题在于如何系统性地衡量模型在通用任务上的基础能力。该数据集兼容ellamind/eval-scores-ref基准,为SOOFI-S及其长上下文变体SOOFI-S-long-context提供了标准化的预训练评估分数,相关基准任务定义已开源至ellamind/base-eval。作为评估框架的重要组成,SOOFI-S-Base-eval-scores在自然语言处理领域推动了模型预训练效果的量化研究,尤其对多任务学习与长上下文建模的评估标准制定产生了显著影响,为后续模型优化提供了可复现的参考依据。
当前挑战
该数据集所解决的领域问题挑战在于:大型语言模型的预训练效果评估长期缺乏统一、可比的基准,导致不同模型间性能难以直接对比,SOOFI-S-Base-eval-scores通过标准化评估分数,有效缓解了任务间度量不一致的问题。构建过程的挑战包括:设计兼容多模型(如SOOFI-S与SOOFI-S-long-context)的评估协议,确保长上下文模型在扩展序列长度时仍能公平测试;维护评估分数与基准数据集(ellamind/eval-scores-ref)的兼容性,需严格对齐任务定义,避免因指标偏差引发误导性结论。此外,开源基准社区协作的版本控制与分数可复现性也是实践中的核心难点。
常用场景
经典使用场景
SOOFI-S-Base-eval-scores数据集为预训练语言模型的性能评估提供了标准化基准,尤其适用于SOOFI-S及SOOFI-S-long-context系列模型的横向对比。研究者可借助该数据集中的评测分数,在统一框架下衡量模型在多项下游任务上的表现,从而系统性地分析模型架构优化、训练策略调整或上下文长度扩展带来的影响。这一标准化评估范式,使得不同实验室的成果得以在同一标尺下进行公平比较,极大促进了语言模型研究的可复现性与透明度。
衍生相关工作
围绕SOOFI-S-Base-eval-scores数据集,衍生出一系列专注于模型评估标准化与基准构建的经典工作。其中ellamind/base-eval项目定义了评测任务的详细规范,为后续研究者提供了可扩展的模板;而ellamind/eval-scores-ref则作为参照基准,启发了多篇关于评估指标鲁棒性与跨模型可比性的探讨。这些工作共同催生了对预训练语言模型能力图谱的精细化研究,鼓励学界以更严谨的实证方法审视模型涌现能力,并推动建立了多个后续细分领域的专用评测集,形成良性学术生态。
数据集最近研究
最新研究方向
该数据集专注于SOOFI-S及其长上下文变体的预训练评估分数,与基准评估框架紧密耦合,反映了当前大语言模型在长文本理解与生成能力上的前沿追求。随着多模态和长文档处理成为热点,SOOFI-S系列通过细粒度评分体系,为模型在不同上下文长度下的性能变化提供了量化标尺,推动了评估标准化进程。其开源共享属性,促使研究社区能够准确对比和复现结果,加速了长上下文模型的迭代与优化,具有重要的方法论意义。
以上内容由遇见数据集搜集并总结生成


