
tts-rj-hi-karya-44100hz-part-31
收藏官方服务:
资源简介:
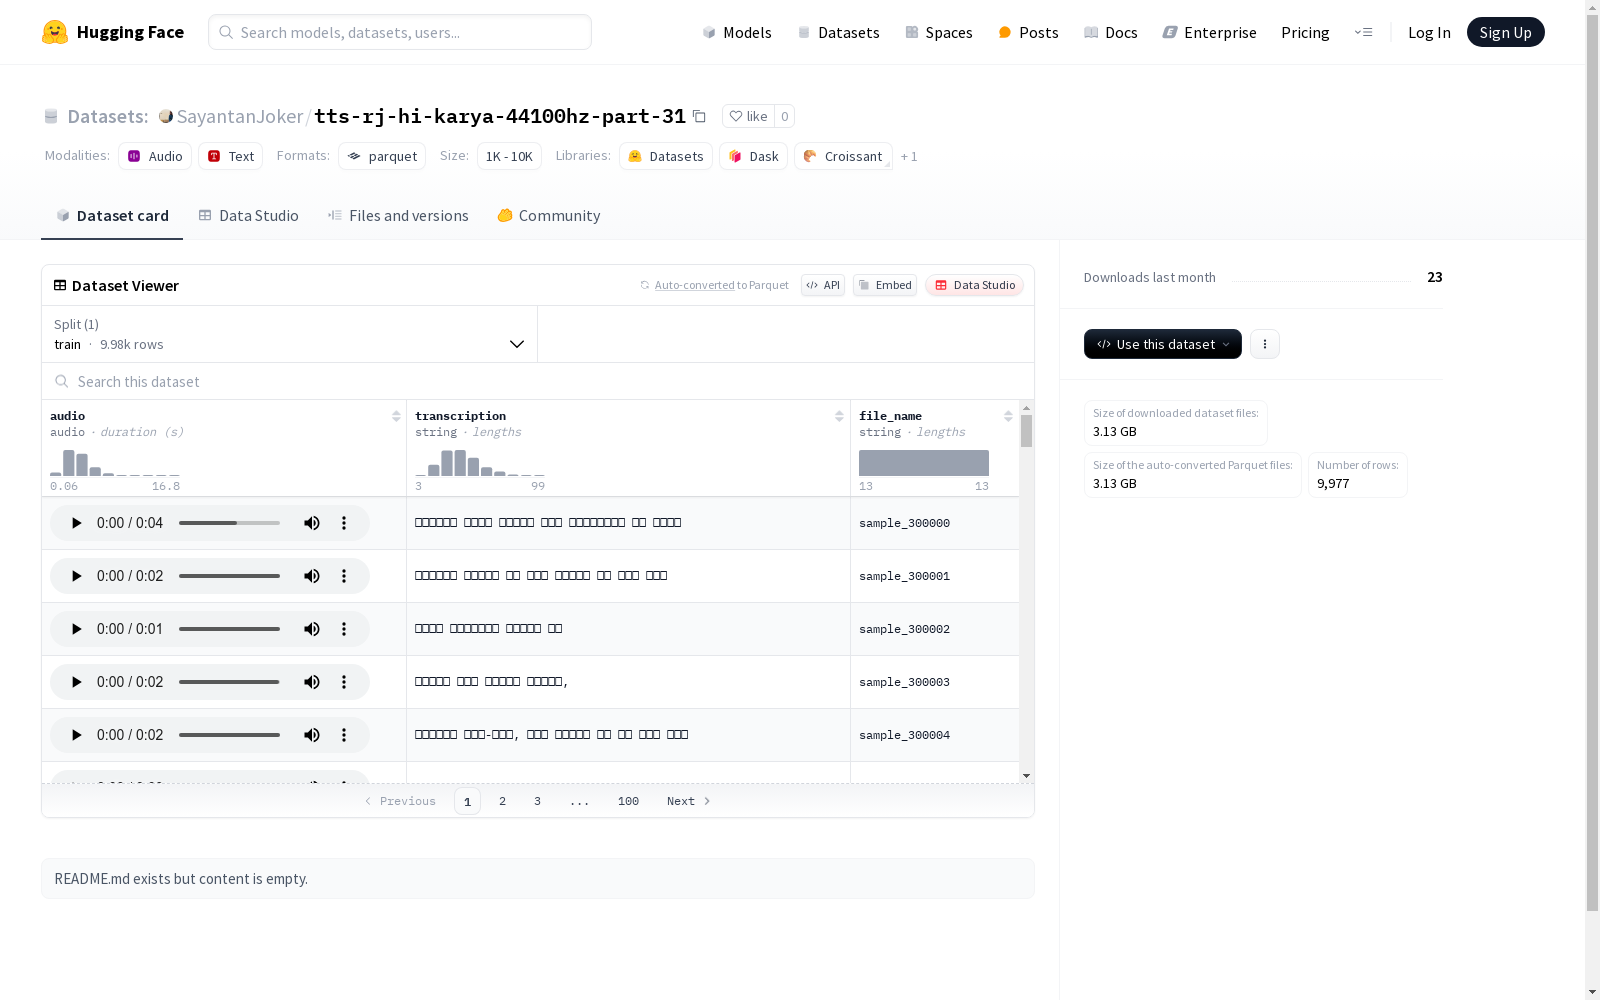
该数据集包含了音频数据和对应的转录文本,适用于语音识别任务。数据集由训练集组成,共有10000个音频样本,音频采样率为44100Hz。数据集的总大小为3.13GB,训练集的大小为3.41GB。
This dataset contains audio data and their corresponding transcriptions, which is suitable for speech recognition tasks. It consists of a training set with a total of 10,000 audio samples, and the audio sampling rate is 44100 Hz. The total size of the dataset is 3.13 GB, and the size of the training set is 3.41 GB.
创建时间:
2025-03-27
搜集汇总
数据集介绍
构建方式
在语音合成技术快速发展的背景下,tts-rj-hi-karya-44100hz-part-31数据集通过专业录音设备和标准化流程构建而成。该数据集收录了9977条高质量音频样本,每条样本均以44.1kHz采样率录制,确保声音信号的完整性和清晰度。文本转录内容经过严格校对,与音频文件精确对应,文件命名系统规范统一,为研究提供可靠的数据支持。
使用方法
研究人员可通过HuggingFace平台直接下载该数据集,解压后获得包含音频文件和对应转录的完整数据包。建议使用专业音频处理工具加载44.1kHz采样率的音频数据,配合文本转录文件进行语音合成或识别模型的训练。数据已预先划分为训练集,可直接用于模型开发流程。
背景与挑战
背景概述
tts-rj-hi-karya-44100hz-part-31数据集是语音合成领域的重要资源,专注于高采样率(44100Hz)的音频数据及其对应文本转录。该数据集的创建旨在为文本到语音(TTS)系统提供高质量的语音样本,以支持多语言或多方言的语音合成研究。其高采样率的特性使得音频信号能够保留更丰富的声学细节,为语音合成模型的训练提供了更为精确的数据基础。该数据集的推出进一步推动了语音合成技术在自然度和清晰度方面的研究进展。
当前挑战
tts-rj-hi-karya-44100hz-part-31数据集面临的挑战主要集中在两个方面:其一,高采样率音频数据的处理对计算资源提出了较高要求,尤其是在大规模训练场景下,存储和计算成本显著增加;其二,语音转录的准确性直接影响到TTS模型的输出质量,如何确保转录文本与音频内容的高度一致成为数据集构建过程中的关键难点。此外,多语言或多方言环境下的语音数据采集与标注也增加了数据集的构建复杂度。
常用场景
经典使用场景
在语音合成技术的研究中,tts-rj-hi-karya-44100hz-part-31数据集以其高质量的音频样本和精确的转录文本,成为训练和评估文本到语音(TTS)模型的理想选择。该数据集特别适用于研究印度语言的语音合成,尤其是印地语和拉贾斯坦方言,为语音合成系统的开发和优化提供了丰富的语料资源。
解决学术问题
该数据集解决了语音合成领域中的多个关键问题,包括低资源语言的语音合成质量、多方言语音合成的适应性以及高采样率音频的处理。通过提供大量高质量的印地语和拉贾斯坦方言的音频样本,研究者能够更有效地训练模型,提升合成语音的自然度和可懂度,填补了相关语言资源的空白。
实际应用
在实际应用中,tts-rj-hi-karya-44100hz-part-31数据集被广泛应用于智能语音助手、语音导航系统以及教育工具的开发。其高质量的语音样本能够显著提升语音合成系统的用户体验,尤其在多语言和多方言环境下,为用户提供更加自然和准确的语音输出。
数据集最近研究
最新研究方向
在语音合成领域,高采样率音频数据集的研究正逐渐成为热点。tts-rj-hi-karya-44100hz-part-31数据集以其44.1kHz的高采样率,为语音合成模型的训练提供了更丰富的声学细节。近年来,研究者们开始探索如何利用此类高采样率数据提升合成语音的自然度和表现力,特别是在多语言和方言合成任务中。随着深度学习技术的进步,该数据集在端到端语音合成系统中的潜力逐渐显现,为语音技术的多样化和个性化发展提供了重要支持。
以上内容由遇见数据集搜集并总结生成


