
amalia-llm/SCIERC-PT
收藏官方服务:
资源简介:
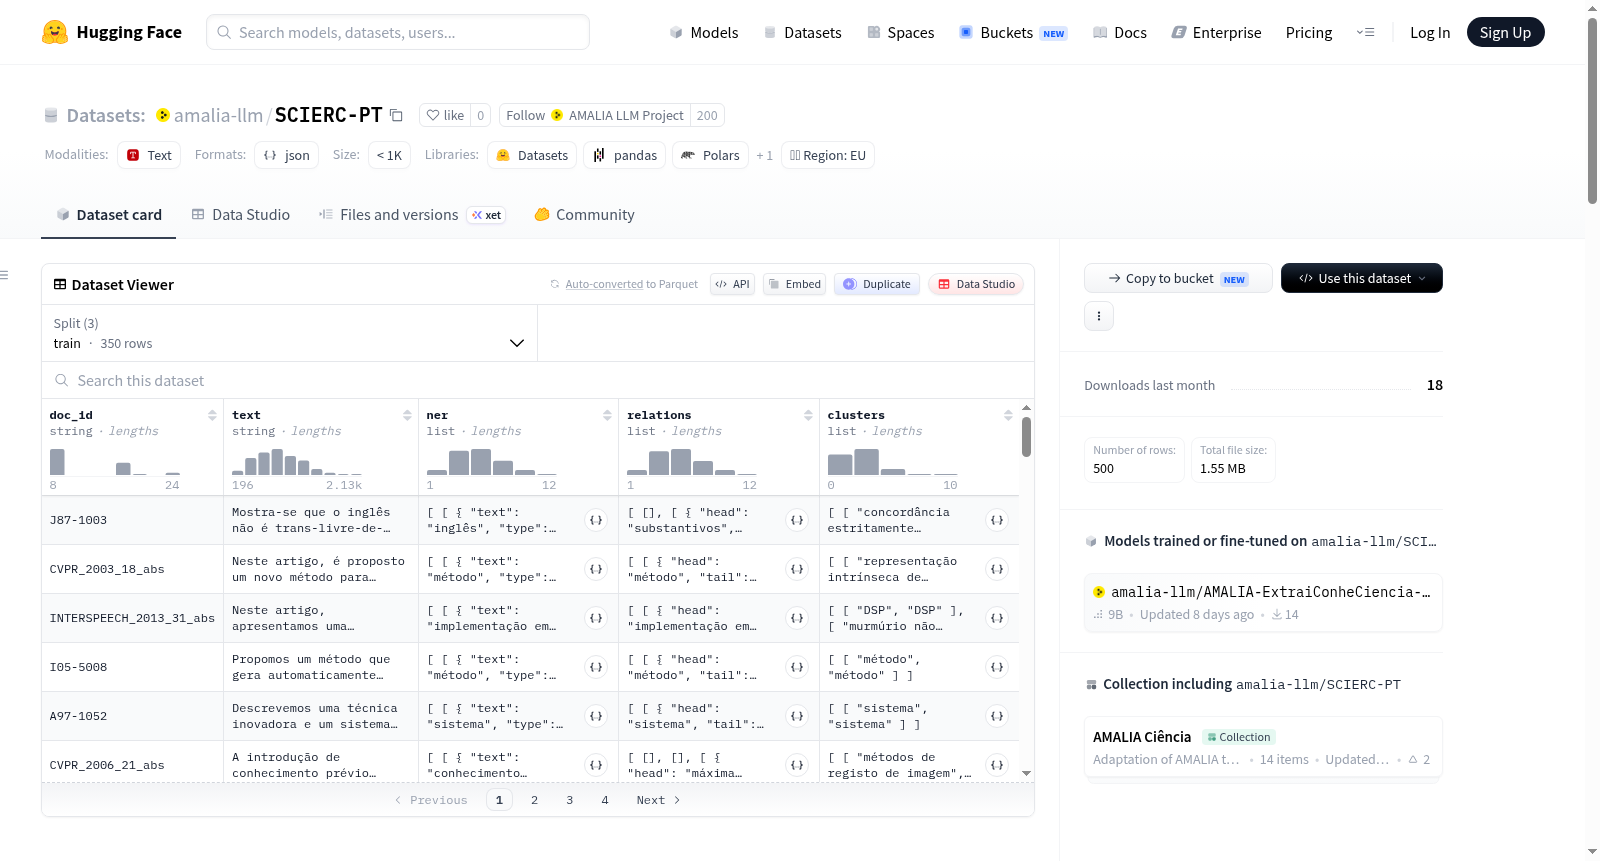
SCIERC-PT是SCIERC数据集的欧洲葡萄牙语翻译版本,旨在支持葡萄牙语科学信息提取研究。该数据集提供了翻译的科学摘要,适用于评估命名实体识别和关系提取模型,同时保留了原始注释模式。数据集包含计算机科学论文摘要,并标注了科学实体和语义关系。
SCIERC-PT is a European Portuguese translation of the SCIERC dataset, created to support research on Scientific Information Extraction in Portuguese. The dataset provides translated scientific abstracts suitable for evaluating Named Entity Recognition and Relation Extraction models while preserving the original annotation schema. It contains computer science paper abstracts annotated with scientific entities and semantic relations.
提供机构:
amalia-llm搜集汇总
数据集介绍
构建方式
SCIERC-PT 数据集是在原始 SCIERC 数据集基础上的欧洲葡萄牙语翻译版本,旨在推动葡萄牙语科学信息抽取的研究。构建过程首先采用 GPT-5.1 自动将计算机科学论文摘要从英文翻译为葡萄牙语,随后通过自动化验证脚本识别标注实体跨度与翻译文本不匹配的候选实例。这些实例经人工审核与修正,包括调整实体跨度对齐并在必要时对译文进行最小幅度改动以保持原意。原始标注方案中的实体类型(如任务、方法、评价指标等)与关系类型(如用于、特征、上下位等)得到完整保留。最终形成包含 350 条训练样本、50 条开发样本和 100 条测试样本的数据集,适用于命名实体识别与关系抽取任务。
特点
SCIERC-PT 的核心特点在于其跨语言适配过程中对原始标注架构的严格保真,同时兼顾翻译文本的自然性与注解一致性。数据集覆盖七类科学实体与七类语义关系,全面反映计算机科学文献中的知识结构。尽管经过精心的人工策展,由于跨语言数据集适应的固有挑战,仍可能存在少量细微偏差。该数据集专为评估多语言及葡萄牙语大语言模型在科学信息抽取中的表现而设计,填补了葡萄牙语领域高质量科学标注数据集的空白。
使用方法
SCIERC-PT 可直接用于训练和评估命名实体识别与关系抽取模型,研究者可基于标准的分割(训练集 350 条、开发集 50 条、测试集 100 条)进行实验。该数据集支持构建科学知识图谱的研究,并适用于评测多语言及葡萄牙语大语言模型在科学文本上的信息抽取能力。使用时需注意翻译与标注对齐可能存在的细微不一致性,建议结合原论文中描述的评估框架,参考《Evaluating Generative Large Language Models for Portuguese Scientific Information Extraction》一文以获取更详细的应用指导。
背景与挑战
背景概述
在自然语言处理领域,针对特定语言与领域的标注数据集稀缺性一直是制约科学信息抽取技术发展的关键瓶颈。SCIERC-PT 数据集应运而生,它基于 EMNLP 2018 年发布的英文 SCIERC 数据集,由研究者通过自动化翻译与人工策展的方式构建,旨在为欧洲葡萄牙语(PT-PT)的科学信息抽取研究提供标准化评测资源。该数据集收录了计算机科学论文摘要,标注了六类科学实体与七类语义关系,其创建工作发表于 NSLP 2026,填补了葡萄牙语在该领域的资源空白,对于推动低资源语言下的命名实体识别、关系抽取及知识图谱构建具有重要基础性价值。
当前挑战
SCIERC-PT 所应对的核心挑战源于跨语言数据集适配的固有复杂性。其领域问题挑战在于,科学信息抽取任务本身要求模型精确识别专业术语及其语义关系,而葡萄牙语作为低资源语言,缺乏足够的高质量标注数据进行模型训练与评估。构建过程中的挑战则尤为突出:原始英文注释中的实体跨度在自动翻译后常与译文文本不匹配,需通过自动化脚本来筛查候选错误实例,并辅以人工逐条校正实体对齐与译文微调,同时严格保持原注释模式的完整性。尽管如此,手动策展仍难以彻底消除翻译歧义与标注不一致,这构成了该数据集持续改进的关键难点。
常用场景
经典使用场景
在科学信息抽取领域,SCIERC-PT数据集主要被用于评估和微调面向葡萄牙语(欧洲变体)的命名实体识别与关系抽取模型。该数据集包含计算机科学论文摘要,标注了六类科学实体(如任务、方法、评估指标等)和七类语义关系(如用于、特征、上下位关系等),为跨语言迁移学习提供了高质量的基准资源。研究者通常利用其训练集与测试集进行序列标注和关系分类的实验,以检验模型在葡萄牙语科学文本上的泛化能力与鲁棒性。
衍生相关工作
基于SCIERC-PT,衍生了多项重要研究工作,包括对生成式大语言模型(如GPT-5.1)在葡萄牙语科学信息抽取中效能的系统评估,以及跨语言标注一致性增强方法的探索。此外,该数据集激发了针对低资源语言科学信息抽取的微调策略研究,例如结合对抗训练与提示学习的解决方案。这些工作进一步验证了自动翻译与人工校核结合的语料构建范式,为其他语言(如西班牙语、加泰罗尼亚语)的类似资源开发提供了方法论参考。
数据集最近研究
最新研究方向
随着科学信息抽取技术向多语言场景延伸,SCIERC-PT数据集应运而生,填补了葡萄牙语在科学实体识别与关系抽取领域的资源空白。该数据集基于英文SCIERC语料,通过GPT-5.1自动翻译与人工精校相结合的策略完成跨语言迁移,不仅保留了原始标注范式,更着力解决翻译后实体边界漂移这一核心难题。当前研究前沿聚焦于评估生成式大语言模型在葡萄牙语科学摘要中的信息抽取能力,特别是探讨机器翻译质量与标注一致性之间的张力,以及多语言模型在低资源科学领域的泛化表现。这一工作为构建葡萄牙语科学知识图谱奠定了数据基础,也对推动欧洲非英语国家的学术信息数字化具有示范意义。
以上内容由遇见数据集搜集并总结生成


