aci-research-daily
收藏资源简介:
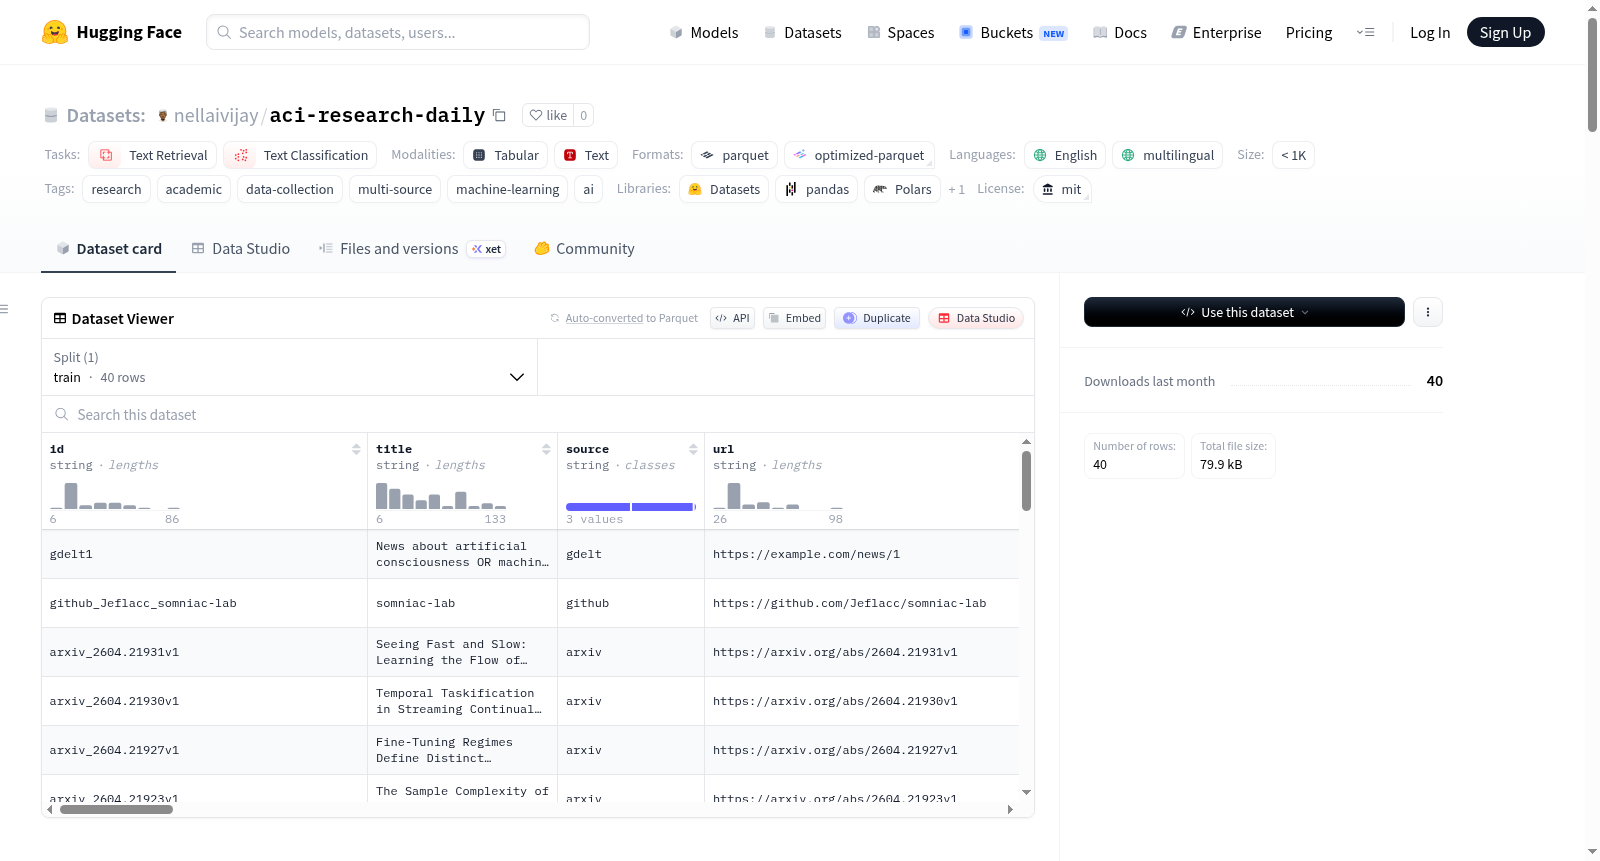
Research Collector数据集是一个通过Research-Collector工具从多个来源聚合的研究结果数据集。每个数据项都包含丰富的元数据、机器学习子领域分类、质量评分和时间特征。数据集涵盖的主题为人工意识或机器意识或AI意识,时间范围为2026年4月12日至2026年4月26日,共包含40个数据项。数据来源包括学术平台(如PubMed、arXiv、Semantic Scholar)、专业平台(如GitHub、Stack Overflow、Kaggle)、社交平台(如Reddit、Hacker News)以及新闻和博客平台(如Medium、Towards Data Science)。数据集的核心字段包括唯一标识符、标题、来源平台、URL、作者、发布日期、引用次数、点赞数、下载数、评论数、内容/摘要/描述和相关性评分。此外,数据集还包含丰富的元数据字段,如出版年份、月份、星期、季度、ML子领域分类、关键词提取、情感分析、自动摘要、数据质量指标和趋势分析等。该数据集适用于文本检索、文本分类等任务,并可用于机器学习、AI等领域的研究。
The Research Collector Dataset is a collection of research results aggregated from multiple sources through the Research-Collector tool. Each data item contains rich metadata, machine learning subfield classifications, quality scores, and temporal features. The dataset covers topics related to artificial consciousness or machine consciousness or AI consciousness, with a time range from April 12, 2026 to April 26, 2026, totaling 40 data items. Data sources include academic platforms (such as PubMed, arXiv, Semantic Scholar), professional platforms (such as GitHub, Stack Overflow, Kaggle), social platforms (such as Reddit, Hacker News), and news and blog platforms (such as Medium, Towards Data Science). The core fields of the dataset include unique identifiers, titles, source platforms, URLs, authors, publication dates, citation counts, like counts, download counts, comment counts, content/abstract/description, and relevance scores. Additionally, the dataset includes rich metadata fields such as publication year, month, day of the week, quarter, ML subfield classification, keyword extraction, sentiment analysis, automatic summarization, data quality metrics, and trend analysis. This dataset is suitable for tasks such as text retrieval and text classification, and can be used for research in machine learning, AI, and other fields.
数据集概述:Research Collector Dataset
该数据集由 Research-Collector 工具从多个来源聚合而成,聚焦于“人工意识”或“机器意识”相关的研究内容。数据集包含 40 个经过丰富元数据标注的研究条目,适用于文本检索与文本分类任务。
基本信息
- 数据集名称: Research Collector Dataset
- 许可证: MIT
- 任务类型: 文本检索、文本分类
- 语言: 英语、多语言
- 数据集大小: <1K 条
- 主题: artificial consciousness OR machine consciousness OR AI consciousness
- 时间范围: 2026-04-12T15:40:55.125698 至 2026-04-26T15:40:55.125705
- 数据来源:
- 学术: PubMed, arXiv, Semantic Scholar, Crossref, Papers with Code
- 专业: GitHub, Stack Overflow, Kaggle
- 社交: Reddit, Hacker News
- 新闻: GDELT
- 博客: Medium, Towards Data Science
- 导出时间: 2026-04-26T15:41:12.162574
数据结构
数据集包含丰富的字段,分为核心字段和增强元数据字段。
核心字段
| 字段名 | 说明 |
|---|---|
id |
唯一标识符 |
title |
研究条目标题 |
source |
来源平台(如 pubmed, arxiv, github 等) |
url |
原始内容链接 |
author |
作者 |
published_date |
发布日期(ISO 8601 格式) |
citations |
引用次数 |
upvotes |
点赞数 |
downloads |
下载次数 |
comments |
评论数 |
content |
内容/摘要/描述 |
score |
相关性得分 |
增强元数据字段
时间与分类字段:
metadata_year,metadata_month,metadata_day,metadata_week,metadata_quarter: 时间维度的分解metadata_days_since: 距发布的天数metadata_ml_subfields: ML 子领域分类(JSON 数组)metadata_subfield_count: ML 子领域数量metadata_keywords: 提取的关键词(JSON 数组)metadata_keyword_count: 关键词数量
质量与内容字段:
metadata_quality_scores: 质量评分指标(JSON 字典)metadata_content_type: 内容类型(paper, preprint, repository, discussion, qa, news)metadata_has_code: 是否包含代码metadata_has_doi: 是否具有 DOImetadata_summary: 自动生成的摘要(抽取式)metadata_summary_length: 摘要长度(字符数)
情感分析字段:
metadata_sentiment_polarity: 情感极性分(-1 到 1)metadata_sentiment_subjectivity: 情感主观性分(0 到 1)metadata_sentiment_category: 情感类别(positive, negative, neutral)
数据质量字段:
metadata_data_quality: 数据质量指标(JSON 字典),包含:completeness_score: 字段完整性百分比(0-100)consistency_score: 内部一致性得分(0-100)validity_score: 数据有效性得分(0-100)overall_quality_score: 整体数据质量得分(0-100)
趋势与关联字段:
metadata_trending_score: 参与度速度得分metadata_trending_category: 趋势类别(hot, warm, cool, cold)metadata_engagement_score: 原始参与度得分metadata_related_items: 相关条目及相似度得分(JSON 数组)metadata_related_count: 相关条目数量
来源特定元数据
- PubMed:
metadata_journal,metadata_doi,metadata_mesh_terms,metadata_publication_types,metadata_abstract_length - arXiv:
metadata_arxiv_id,metadata_primary_category,metadata_categories,metadata_journal_ref - GitHub:
metadata_stars,metadata_forks,metadata_language,metadata_license,metadata_topics,metadata_has_readme - Reddit:
metadata_subreddit,metadata_link_flair_text,metadata_upvote_ratio,metadata_total_awards,metadata_is_gilded - Stack Overflow:
metadata_tags,metadata_answer_count,metadata_has_accepted_answer,metadata_view_count,metadata_owner_reputation - Semantic Scholar:
metadata_citation_count,metadata_influential_citation_count,metadata_fields_of_study,metadata_has_open_access - Medium:
metadata_author,metadata_publication,metadata_read_time,metadata_claps - Kaggle:
metadata_votes,metadata_usability_rating,metadata_file_count
数据质量特性
- 标准化日期: 所有日期统一为 ISO 8601 格式
- ML 子领域分类: 自动分类为 15+ 个 ML 子领域
- 质量评分: 多维度质量评估(摘要长度、代码可用性、DOI、参与度、时效性)
- 时间特征: 年、月、周、季度、距发布天数
- 关键词提取: 自动提取技术关键词
- 内容类型检测: 自动分类条目类型
- 情感分析: 情感极性、主观性、类别分类
- 自动摘要: 抽取式摘要,快速了解内容
- 数据质量指标: 每条目的完整性、一致性、有效性得分
- 趋势指标: 参与度速度分析及趋势类别
- 交叉引用: 基于共享子领域、关键词和标签的关联条目检测
- 模糊去重: 智能重复检测与元数据合并
- 元数据完备性: 通过回退逻辑推断缺失的元数据字段
使用示例(Python)
python from datasets import load_dataset
加载数据集
dataset = load_dataset("nellaivijay/aci-research-daily") train_data = dataset["train"]
按来源筛选
pubmed_items = train_data.filter(lambda x: x["source"] == "pubmed")
按内容类型筛选
papers = train_data.filter(lambda x: x.get("metadata_content_type") == "paper")
按 ML 子领域筛选
cv_papers = train_data.filter(lambda x: "computer-vision" in x.get("metadata_ml_subfields", []))
按质量筛选
high_quality = train_data.filter(lambda x: x.get("metadata_data_quality", {}).get("overall_quality_score", 0) > 0.7)
按得分排序
sorted_items = train_data.sort("score", reverse=True)
按日期筛选
recent_items = train_data.filter(lambda x: x.get("metadata_days_since", 999) < 30)
按趋势类别筛选
trending_items = train_data.filter(lambda x: x.get("metadata_trending_category") == "hot")
按情感筛选
positive_items = train_data.filter(lambda x: x.get("metadata_sentiment_category") == "positive")
局限性
- 数据仅限指定的时间范围
- 部分来源可能存在速率限制或 API 限制
- 引用计数在不同来源间可能存在差异
- ML 子领域分类基于关键词匹配,可能不完美
数据来源与生成工具
该数据集由 Research-Collector 工具生成,相关代码可访问:https://github.com/nellaivijay/research-collector
引用
如果使用此数据集,请引用仓库 URL:https://huggingface.co/datasets/nellaivijay/aci-research-daily