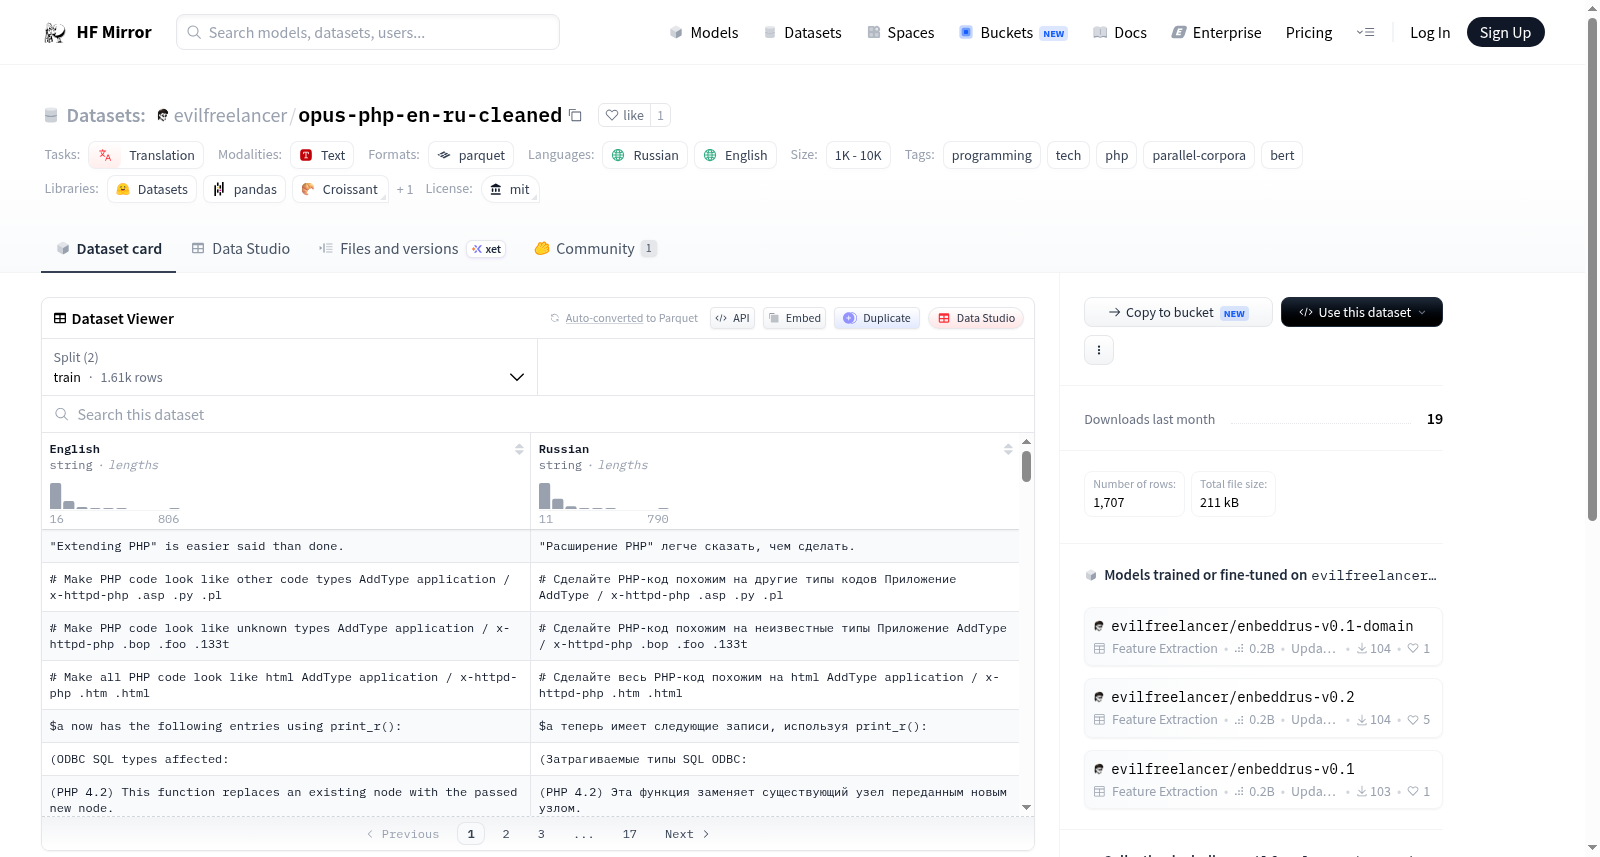
evilfreelancer/opus-php-en-ru-cleaned
收藏资源简介:
--- dataset_info: features: - name: English dtype: string - name: Russian dtype: string splits: - name: train num_bytes: 372104 num_examples: 1607 - name: eval num_bytes: 19356 num_examples: 100 download_size: 206613 dataset_size: 391460 configs: - config_name: default data_files: - split: train path: data/train-* - split: eval path: data/eval-* license: mit task_categories: - translation language: - ru - en tags: - programming - tech - php - parallel-corpora - bert size_categories: - 1K<n<10K --- # OPUS PHP (ru-en) Parallel Corpora The dataset contains parallel corpora, featuring pairs in Russian and English. Initially, the original [OPUS PHP v1 (en&ru)](https://opus.nlpl.eu/PHP/en&ru/v1/PHP) dataset was intended to be used for training the [enbeddrus](https://github.com/EvilFreelancer/enbeddrus) project. However, due to its poor quality and high level of noise, it was decided to use only the English corpus from this dataset. The English text was then automatically translated using [LibreTranslate](https://libretranslate.com/), followed by manual translation and quality improvement using [Google Translate](https://translate.google.ru/). Thus, the entire dataset was reviewed by the author of this project. Subsequently, all lines shorter than 15 characters were removed, and lines such as "Example 1. function_name()" were manually deleted. Additionally, all duplicate lines, such as untranslated code samples, were removed. As a result, the original OPUS PHP v1 dataset was reduced from ~2k lines to ~1.6k lines.
OPUS PHP (ru-en) 平行语料库数据集
数据集信息
特征
- English: 字符串类型
- Russian: 字符串类型
分割
- train:
- 字节数: 372104
- 样本数: 1607
- eval:
- 字节数: 19356
- 样本数: 100
大小
- 下载大小: 206613 字节
- 数据集大小: 391460 字节
配置
- default:
- 数据文件:
- train: data/train-*
- eval: data/eval-*
- 数据文件:
许可
- MIT 许可证
任务类别
- 翻译
语言
- 俄语 (ru)
- 英语 (en)
标签
- 编程
- 技术
- PHP
- 平行语料库
- BERT
大小类别
- 1K<n<10K
数据集描述
该数据集包含俄语和英语的平行语料库。最初,原始的 OPUS PHP v1 (en&ru) 数据集旨在用于训练 enbeddrus 项目。然而,由于其质量差和噪声水平高,决定仅使用该数据集中的英语语料库。然后,使用 LibreTranslate 自动翻译英语文本,并使用 Google Translate 进行手动翻译和质量改进。
因此,整个数据集由该项目的作者进行了审查。随后,删除了所有少于15个字符的行,并手动删除了诸如 "Example 1. function_name()" 的行。此外,删除了所有重复的行,如未翻译的代码样本。结果,原始的 OPUS PHP v1 数据集从约2k行减少到约1.6k行。