XVSS-X
收藏资源简介:
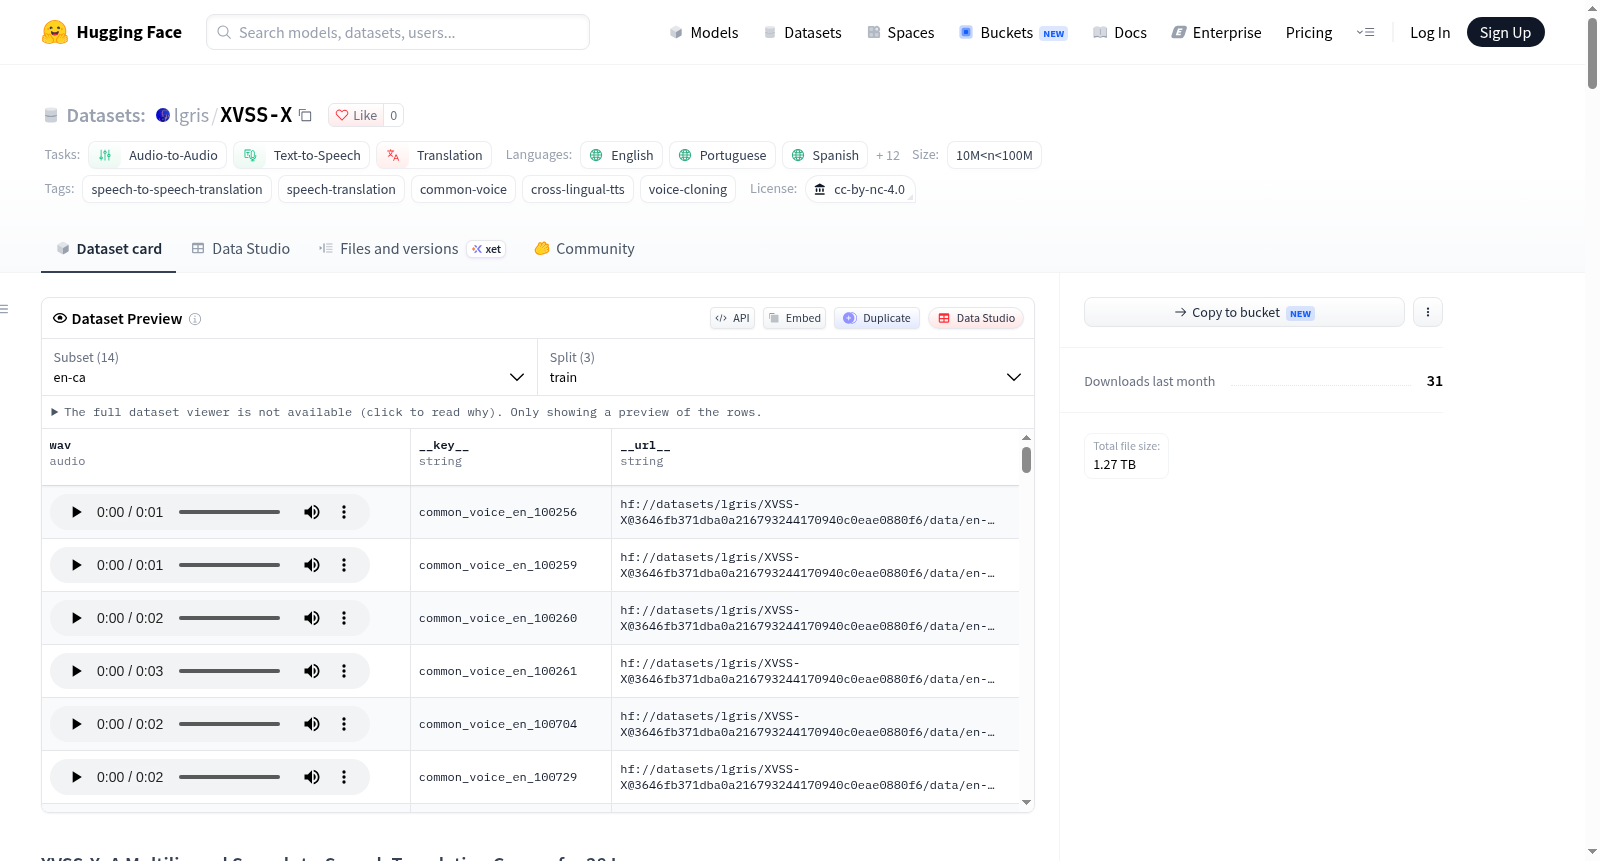
XVSS-X(CVSS-X)是一个面向28种目标语言的大规模多语言语音到语音翻译(S2ST)语料库,是对原始CVSS语料库的扩展与方向反转(英语→28种语言)。该数据集旨在实现英语与多种语言之间的双向语音翻译,并支持以英语为枢轴进行任意语言对的间接翻译。XVSS-X基于Mozilla Common Voice 17英语语音数据,包含约240,192个英语话语,经过文本对齐、使用NLLB-200(蒸馏版600M)翻译为28种目标语言文本,再通过OmniVoice零样本跨语言语音合成生成目标语音。数据集提供两种变体:XVSS-X-C(规范型)使用每语言两个固定参考声音(一男一女)生成语音,约6,730小时;XVSS-X-T(音色迁移型)保留原始英语说话人的声学特征,约9,340小时。总音频时长约16,070小时,包含超过1,340万平行语音对。每个语言的数据划分为训练集222,349条、开发集10,000条、测试集7,843条。目标语言覆盖12个语系,包括罗曼语族(葡萄牙语、西班牙语、法语、意大利语、罗马尼亚语、加泰罗尼亚语)、日耳曼语族(德语、荷兰语、瑞典语、丹麦语、挪威语)、斯拉夫语族(俄语、波兰语、捷克语、乌克兰语)、汉日韩语(汉语、日语、韩语)、乌拉尔语族(芬兰语、匈牙利语)、印度-伊朗语族(印地语、波斯语)以及其他语言(希腊语、希伯来语、土耳其语、泰语、印度尼西亚语、越南语)。该语料库适用于语音到语音翻译、文本到语音、跨语言语音克隆、语音翻译评估等任务。合成译文和语音对采用CC-BY-NC 4.0许可证。
XVSS-X (CVSS-X) is a large-scale multilingual speech-to-speech translation (S2ST) corpus targeting 28 languages, extending and reversing the direction of the original CVSS corpus (English → 28 languages). This dataset aims to enable bidirectional speech translation between English and multiple languages, and supports indirect translation between any language pair using English as a pivot. XVSS-X is based on Mozilla Common Voice 17 English speech data, containing approximately 240,192 English utterances. After text alignment, the texts are translated into 28 target languages using NLLB-200 (distilled 600M), and target speech is generated via OmniVoice zero-shot cross-lingual speech synthesis. The dataset provides two variants: XVSS-X-C (canonical) uses two fixed reference voices (one male, one female) per language, totaling about 6,730 hours; XVSS-X-T (timbre transfer) retains the original English speakers acoustic characteristics, totaling about 9,340 hours. The total audio duration is approximately 16,070 hours, containing over 13.4 million parallel speech pairs. Each languages data is split into 222,349 training, 10,000 development, and 7,843 test samples. The target languages cover 12 language families, including Romance (Portuguese, Spanish, French, Italian, Romanian, Catalan), Germanic (German, Dutch, Swedish, Danish, Norwegian), Slavic (Russian, Polish, Czech, Ukrainian), Sino-Tibetan/Japanese/Korean (Chinese, Japanese, Korean), Uralic (Finnish, Hungarian), Indo-Iranian (Hindi, Persian), and others (Greek, Hebrew, Turkish, Thai, Indonesian, Vietnamese). The corpus is applicable to tasks such as speech-to-speech translation, text-to-speech, cross-lingual voice cloning, and speech translation evaluation. The synthesized translations and speech pairs are licensed under CC-BY-NC 4.0.
XVSS-X 数据集概述
基本信息
- 数据集名称:XVSS-X: A Multilingual Speech-to-Speech Translation Corpus for 28 Languages
- 数据集地址:https://huggingface.co/datasets/lgris/XVSS-X
- 许可证:CC-BY-NC-4.0
- 任务类别:audio-to-audio、text-to-speech、translation
- 数据规模:10M < n < 100M
- 标签:speech-to-speech-translation、speech-translation、common-voice、cross-lingual-tts、voice-cloning
数据集简介
XVSS-X(CVSS-X)是一个大规模合成语音到语音翻译(S2ST)语料库,是对原始 CVSS 数据集的补充与扩展,将翻译方向反转为英语 → 28 种目标语言。结合 CVSS,XVSS-X 可实现:
- 双向语音到语音翻译(英语 ↔ 28 种语言)。
- 以英语为枢纽的任意语言对之间的多语言翻译(X → EN → Y)。
- 语音到语音任务中跨语言语音保持能力的直接评估。
数据变体
- XVSS-X-C(Canonical):目标语音使用每种语言两个固定的高清晰度参考声音(一男一女)合成,声音选择依据源说话人的性别元数据(男性 81.4%,女性 18.6%)。
- XVSS-X-T(Timbre-Transferred):通过 OmniVoice 的零样本跨语言语音克隆,在目标语音中保留原始英语说话人的说话人特征。
语料库统计
| 指标 | 数值 |
|---|---|
| 源语言 | 英语(Common Voice 17) |
| 目标语言 | 28 |
| 语系 | 12(7 个宏语系) |
| 每种语言名义样本数 | 240,192 |
| 数据划分(每种语言) | Train: 222,349 • Dev: 10,000 • Test: 7,843 |
| 总平行语音对 | 6,725,176(Canonical)+ 6,724,326(Timbre)= 13,449,502 个音频文件 |
| XVSS-X-C 时长 | ~6,730 小时(平均 3.6 秒/句) |
| XVSS-X-T 时长 | ~9,340 小时(平均 5.0 秒/句) |
| 总音频时长 | ~16,070 小时(比 CVSS 大 8 倍) |
目标语言
XVSS-X 覆盖 12 个类型学语系的 28 种语言:
| 语系 | 数量 | 语言(ISO 代码) |
|---|---|---|
| Romance | 6 | Portuguese (pt), Spanish (es), French (fr), Italian (it), Romanian (ro), Catalan (ca) |
| Germanic | 5 | German (de), Dutch (nl), Swedish (sv), Danish (da), Norwegian (no) |
| Slavic | 4 | Russian (ru), Polish (pl), Czech (cs), Ukrainian (uk) |
| CJK | 3 | Chinese (zh), Japanese (ja), Korean (ko) |
| Uralic | 2 | Finnish (fi), Hungarian (hu) |
| Indo-Iranian | 2 | Hindi (hi), Persian (fa) |
| Other | 6 | Greek (el), Hebrew (he), Turkish (tr), Thai (th), Indonesian (id), Vietnamese (vi) |
数据集生成流程
- 源数据与对齐:来自 Common Voice 17 的英语录音,通过归一化文本匹配与原始 CVSS 语料库对齐(恢复 91.0% 样本)。dev 集从训练划分补充至恰好 10,000 个样本。
- 文本翻译:使用
facebook/nllb-200-distilled-600M翻译转录文本,该模型经 7 个翻译模型广泛基准测试后因最佳质量/吞吐量权衡而被选用。 - 语音合成:使用
k2-fsa/OmniVoice生成,这是一个多语言 transformer TTS 引擎,具备零样本跨语言合成能力,且不传递源口音痕迹。
质量评估结果
评估在 dev 集中每种语言 200 句的分层随机样本上进行(每个变体 5,600 个样本,通过统计功效分析确定)。
按语系评估(CVSS-X)
| 语系 (N) | WER/CER (C) | WER/CER (T) | ASR-BLEU (C) | ASR-BLEU (T) | UTMOS (C) | UTMOS (T) |
|---|---|---|---|---|---|---|
| Romance (6) | 5.8 | 8.2 | 90.3 | 88.0 | 3.54 | 3.27 |
| Germanic (5) | 9.5 | 12.2 | 85.3 | 81.1 | 3.62 | 3.27 |
| Slavic (4) | 7.0 | 7.7 | 86.9 | 85.9 | 3.48 | 3.17 |
| CJK (3)* | 5.0 | 10.2 | 75.2 | 67.9 | 3.56 | 3.20 |
| Uralic (2) | 10.3 | 14.3 | 84.0 | 78.3 | 3.54 | 3.21 |
| Indo-Iranian (2) | 22.5 | 23.0 | 63.7 | 60.0 | 3.61 | 3.20 |
| Other (6) | 24.8 | 24.8 | 65.0 | 64.9 | 3.53 | 3.14 |
| Average | 12.1 | 14.1 | 82.4 | 79.4 | 3.55 | 3.21 |
*对于无分词 CJK 语言(ZH、JA、KO),报告字符错误率(CER)和字符级 BLEU。
与 CVSS 的总体比较(使用相同流程重新评估)
| 指标 | XVSS-X-C | XVSS-X-T | CVSS-C | CVSS-T |
|---|---|---|---|---|
| UTMOS (1–5) | 3.55 | 3.21 | 4.43 | 3.61 |
| ASR-BLEU | 82.4 | 79.4 | 94.2 | 93.8 |
| WER/CER (%) | 12.1 | 14.1 | 3.5 | 4.0 |
| Speaker Similarity (ECAPA-TDNN) | -- | 0.607 | -- | -- |
数据集配置
数据集提供以下配置,每个配置均包含 train、dev、test 三个划分:
en-pt(英语-葡萄牙语)en-es(英语-西班牙语)en-fr(英语-法语)en-it(英语-意大利语)en-ro(英语-罗马尼亚语)en-ca(英语-加泰罗尼亚语)en-de(英语-德语)en-nl(英语-荷兰语)en-sv(英语-瑞典语)en-da(英语-丹麦语)en-no(英语-挪威语)en-ru(英语-俄语)en-pl(英语-波兰语)en-cs(英语-捷克语)
使用方式
完整数据集(约 2.7 TB,覆盖 28 个语言对,13.4M+ 音频文件)正在镜像至 Hugging Face Hub 的 lgris/XVSS-X 账户下。可通过 datasets 库直接加载和流式读取子集。
路线图:版本 2(开发中)
XVSS-X v2 计划的主要改进包括:
- TranslateGemma-12B 集成:用 Google 的 TranslateGemma-12B 替换 NLLB-200,以显著提升翻译保真度、自然措辞,并通过过渡到 Apache 2.0 许可证消除商业限制。
- Common Voice 26 与 Spontaneous Speech 4.0:从 CV17 扩展至 Common Voice 26 并集成 Spontaneous Speech 4.0,提供更丰富的会话语音、更真实的非流利现象和更大的说话人多样性。
- 端到端 LLM 基线:训练和评估原生离散音频 token 语音到语音翻译基线。
许可证说明
- 音频与源转录:继承自 Mozilla Common Voice(CC0 1.0 Universal)。
- 合成翻译与语音对:由于底层
facebook/nllb-200-distilled-600M模型许可证,采用 Creative Commons Attribution-NonCommercial 4.0 International(CC-BY-NC 4.0)分发。 - 代码库与脚本:采用宽松的 MIT 许可证发布。
引用
bibtex @inproceedings{gris2026cvssx, title={{CVSS-X: A Multilingual Speech-to-Speech Translation Corpus for 28 Languages}}, author={Gris, Lucas Rafael Stefanel and Ferreira, Alef Iury Siqueira and de Oliveira, F. S. and da Rosa, Augusto Seben and Ferro Filho, Alexandre Costa and Galv{~a}o Filho, Arlindo Rodrigues and Soares, Anderson da Silva}, booktitle={Proceedings of the Annual Meeting of the Association for Computational Linguistics (ACL)}, year={2026} }