
BCCard/gemma-4-12B-on-policy-dataset
收藏官方服务:
资源简介:
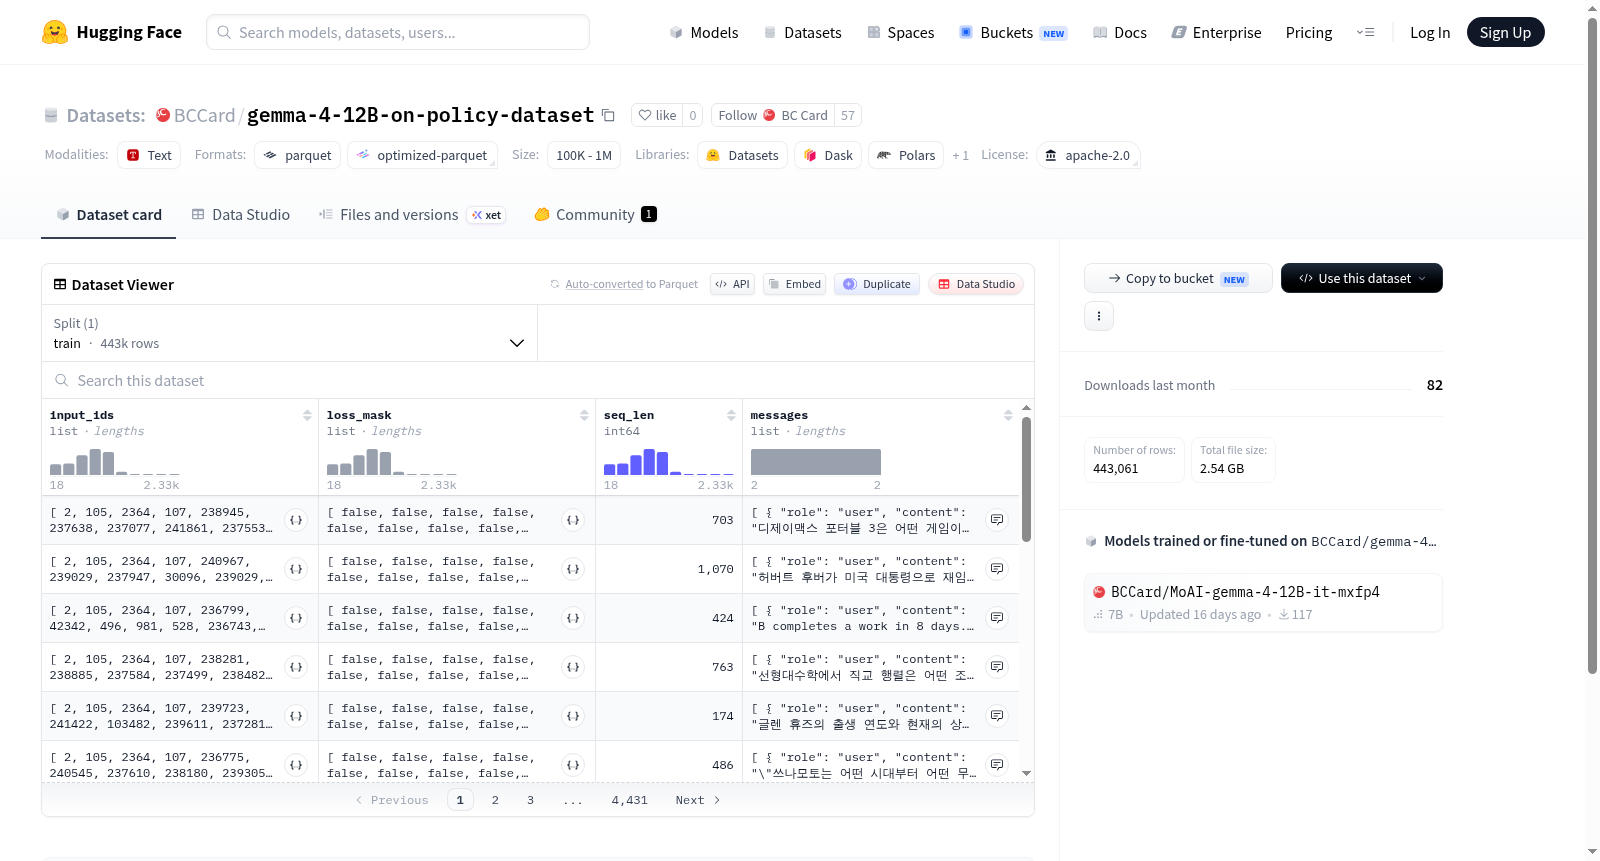
一个包含多轮对话的数据集,每条数据包含角色(role)和内容(content),以及input_ids、loss_mask和seq_len特征。用于语言模型训练。
A dataset containing multi-turn conversations with roles and contents, with input_ids, loss_mask, and seq_len features. Used for language model training.
提供机构:
BCCard搜集汇总
数据集介绍
构建方式
该数据集基于Gemma 4 12B模型在训练过程中生成的行为轨迹进行构建,采用on-policy采样策略以捕捉模型当前策略下的真实输出分布。原始数据经过预处理,将对话序列转化为统一的input_ids格式,并附加loss_mask以标识需要参与损失计算的token位置。每条样本包含完整的messages字段,以角色-内容对的形式保留多轮对话的语义结构。数据按序列长度截断对齐,并分割为训练集,共包含约44.3万条样本,单分片存储于parquet格式文件中,便于高效加载。
特点
数据集的核心特点在于其与模型训练过程紧密耦合的on-policy属性,直接反映了模型在迭代中的实时行为演化。通过loss_mask机制,研究者可灵活调整训练信号覆盖范围,支持部分序列掩码或选择性监督学习。messages字段保留了对话的原始角色信息,适用于指令微调与多轮对话场景。数据规模适中,每个样本的序列长度固定,降低了批处理时进行填充或截断的复杂度。Apache-2.0许可证确保了数据集在学术与商业场景下的广泛可用性。
使用方法
使用该数据集时,推荐通过HuggingFace Datasets库加载,使用load_dataset函数指定路径与分割名称即可获取迭代器。对于PyTorch训练,可借助DataLoader与自定义collate函数将input_ids转换为张量,并依据loss_mask构造损失函数的忽略索引。messages字段可直接用于解析对话结构,但需注意其仅作为元信息保留。建议在加载后对seq_len进行统计以设定文本最大长度,并视需求对数据进行混洗或缓存。若需多工作节点并行加载,可启用datasets的多进程模式以加速预处理流程。
背景与挑战
背景概述
在大语言模型(LLM)的快速演进中,基于人类反馈的强化学习(RLHF)与自监督微调技术已成为提升模型对齐能力与生成质量的核心范式。Gemma-4-12B-on-policy-dataset(以下简称该数据集)由Google DeepMind团队于2024年创建,旨在为Gemma系列模型(特别是12B参数版本)提供高质量的在线策略训练数据。该数据集包含约44.3万个训练样本,每个样本由token化的输入序列、损失掩码及多轮对话消息结构组成,其设计核心在于解决策略梯度和PPO等在线学习算法中的数据偏差问题。通过收集模型自身生成轨迹并配合人工标注反馈,该数据集为研究模型自我改进、奖励建模及鲁棒性优化提供了关键基础设施,其影响力已延伸至对话系统、代码生成与安全对齐等前沿领域,成为探究开源LLM高效微调策略的重要基准。
当前挑战
该数据集所应对的领域挑战主要源于在线策略学习中固有的分布偏移与反馈稀疏性。当模型基于自身输出进行迭代优化时,生成样本的探索-利用平衡难以维护,易导致策略坍缩或奖励黑客行为;同时,数据集中每个样本的损失掩码设计需精确区分有效token与填充token,以避免噪声梯度干扰模型更新。在构建过程中,研究者面临两大技术瓶颈:其一,大规模离线采样需要平衡计算成本与数据多样性,确保轨迹覆盖长尾场景;其二,人工标注反馈的一致性控制——不同标注者对对话质量、安全合规等维度的评判标准差异可能引入系统偏差。此外,数据集仅含单一对话轮次结构,限制了多步推理与上下文依赖能力的评估,而Apache-2.0许可下的开源形式也暴露了潜在的知识产权与隐私合规风险。
常用场景
经典使用场景
在大型语言模型(LLM)的强化学习与对齐优化领域,gemma-4-12B-on-policy-dataset 作为一份精心构建的在线策略(on-policy)数据集,扮演着不可或缺的基石角色。该数据集记录了 Gemma-4-12B 模型自身在交互过程中生成的轨迹,包含输入序列(input_ids)与损失掩码(loss_mask)等关键信息,使其天然适用于基于策略梯度的强化学习范式。研究者可借助该数据集,高效地实施近端策略优化(PPO)或直接偏好优化(DPO)等算法,以调整模型的行为分布,从而增强其对人类偏好的遵从性。同时,其多轮对话结构(messages 字段)为训练模型在复杂对话场景中保持连贯性和语境理解能力提供了宝贵的真实反馈,尤其在指导模型从自身错误中学习方面具有独特价值。
衍生相关工作
该数据集的出现催生了一系列具有影响力的衍生工作。在算法层面,研究者基于其在线交互特性,开发了改进型策略梯度算法,如结合隐式奖励建模的 On-Policy DPO 变体,显著提升了样本效率与对齐稳定性。在评测方面,该数据集促进了如 SafetyBench 和 AlignEval 等综合基准的构建,其中利用其损失掩码机制设计出细粒度的细粒毒性评估指标。此外,围绕 gemma-4-12B-on-policy-dataset 的数据特性,社区提出了多种数据增强与蒸馏技术,例如通过自洽性过滤生成高质量子集,用于训练更小规模的部署模型。这些工作不仅验证了在线策略数据在范式研究中的核心地位,还为后续结合上下文蒸馏、模型合并等前沿方向奠定了实验基础,持续推动着大语言模型对齐领域的创新迭代。
数据集最近研究
最新研究方向
当前,大语言模型的对齐训练与自我改进成为前沿焦点,gemma-4-12B-on-policy数据集正是为此而生。该数据集包含约44万条带有损失掩码和消息结构的训练样本,专为gemma-4-12B模型的在线策略强化学习设计,例如基于人类反馈的强化学习(RLHF)或直接偏好优化(DPO)。其核心价值在于支撑模型在真实交互场景中动态学习偏好,减少离线训练中的分布偏移问题。近期,随着开源社区对透明、可复现对齐研究的呼声高涨,此类数据集推动了策略内学习与奖励泛化的突破,使得小型模型也能通过细粒度监督获得接近闭源模型的指令遵循能力。这一进展不仅降低了先进对齐技术的门槛,还为多轮对话安全性、价值观对齐等热点议题提供了关键实验基础。
以上内容由遇见数据集搜集并总结生成


