ZachW/GPT-BookSum
收藏资源简介:
GPT-BookSum是一个基于BookSum数据集中的故事段落构建的层次化摘要数据集。该数据集在论文《Improving Pacing in Long-Form Story Planning》(EMNLP23)中提出,用于训练一个具体性评估器,以改进故事大纲和生成的节奏控制。摘要由ChatGPT生成,以确保风格统一。数据集包含章节级和段落级的摘要,每个摘要都有相关的统计信息,如摘要长度、原始文本长度、压缩比等。数据集还用于构建训练对,以训练具体性评估器。
GPT-BookSum is a hierarchical summarization dataset constructed from story passages in the BookSum dataset. This dataset was proposed in the paper *Improving Pacing in Long-Form Story Planning* (EMNLP 2023), and is used to train a specificity evaluator to improve story outlining and pacing control of generated content. The summaries are generated by ChatGPT to ensure stylistic consistency. The dataset includes both chapter-level and paragraph-level summaries, with each summary accompanied by relevant statistical metrics including summary length, original text length, compression ratio, and others. It is also employed to construct training pairs for the training of the specificity evaluator.
GPT-BOOKSUM 数据集概述
基本信息
- 许可证: MIT
- 任务类别: 摘要生成、文本生成、文本分类
- 语言: 英语
- 标签: 故事
- 美观名称: GPT-BookSum
- 数据集大小: 100K<n<1M
数据集描述
GPT-BookSum 是一个基于 BookSum 数据集的故事段落的分层摘要数据集。该数据集在 EMNLP23 论文《Improving Pacing in Long-Form Story Planning》中提出,用于训练具体性评估器,进而改善故事大纲和生成的节奏。
数据实例
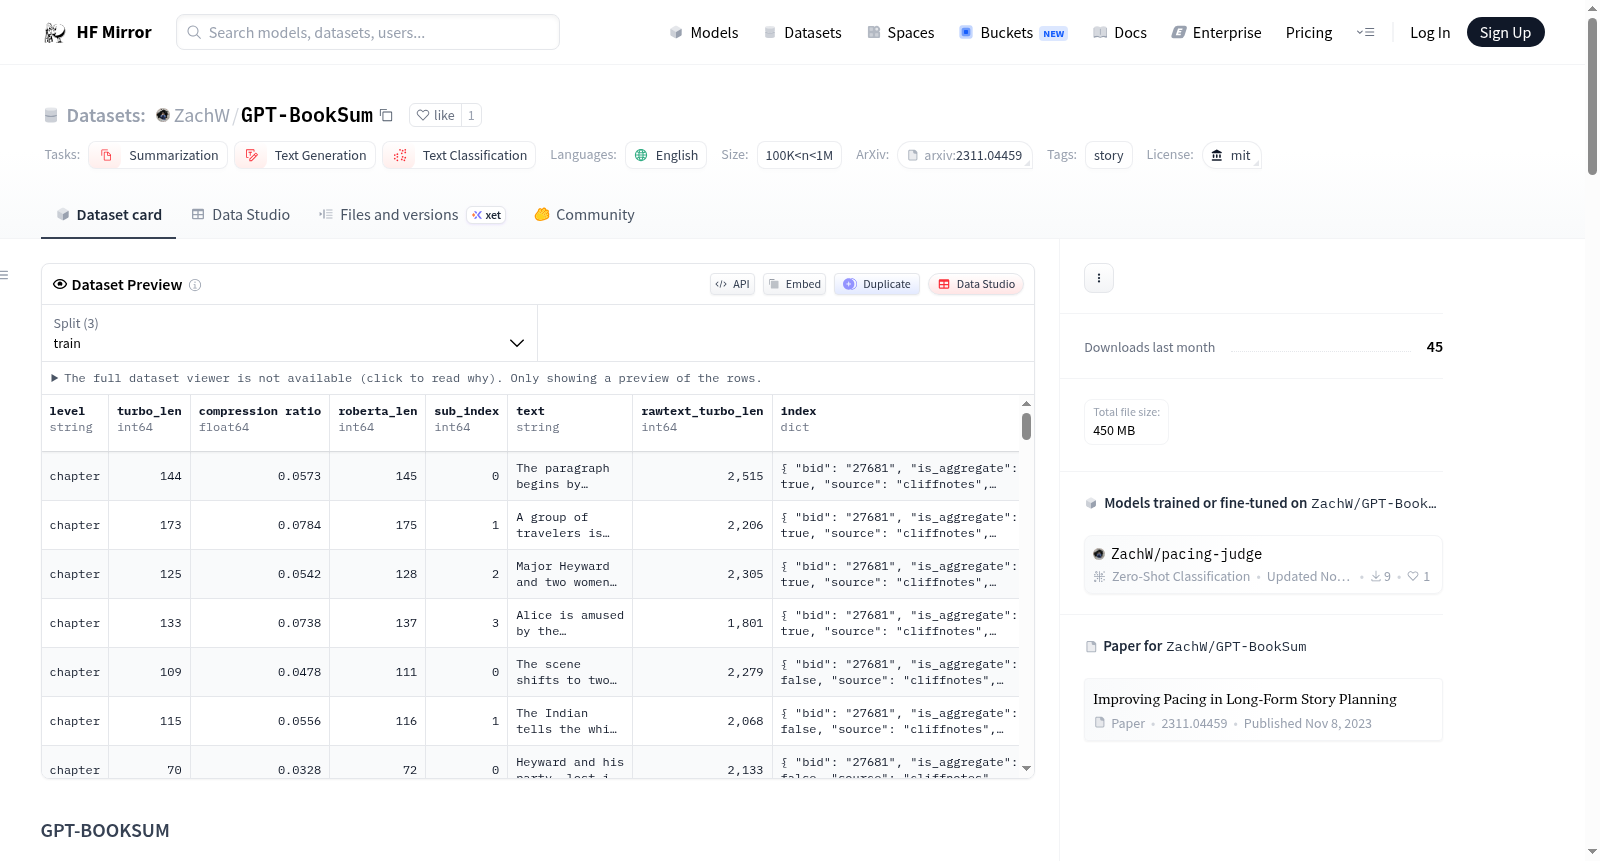
一个示例数据实例如下: json {"level": "chapter", "turbo_len": 70, "compression ratio": 0.034, "roberta_len": 74, "sub_index": 6, "text": "Grushenka is glad to see Alyosha and sits on his knee, while Rakitin tries to join in their conversation. Grushenka mentions that shes expecting a message from her officer, and gives Rakitin champagne when he asks for it. They all have a conversation about various things including the death of Father Zossima.", "rawtext_turbo_len": 2059, "index": {"bid": "28054", "is_aggregate": true, "source": "cliffnotes", "chapter_path": "all_chapterized_books/28054-chapters/book_vii.txt", "summary_path": "finished_summaries/cliffnotes/The Brothers Karamazov/section_10_part_0.txt", "book_id": "The Brothers Karamazov.book vii.chapter i-chapter iv", "summary_id": "book vii"}}
level: 可以是 chapter 或 paragraph。text: 摘要文本。turbo_len: 使用 ChatGPT 分词器的摘要令牌数。compression ratio: 压缩比率,即摘要令牌数与原始文本令牌数的比率。roberta_len: 使用 RoBERTa 分词器的摘要令牌数。sub_index: 如果原始文本超过 4,096 个令牌,则将其分割成子章节,sub_index 是子章节的索引。rawtext_turbo_len: 使用 ChatGPT 分词器的原始文本令牌数。index: 原始文本在 BookSum 数据集中的索引。
数据集统计
| Chapter-Level | Paragraph-Level | |||||||
|---|---|---|---|---|---|---|---|---|
| Split | Size | Summary Len | Raw Len | Raw / Sum | Size | Summary Len | Raw Len | Raw / Sum |
| Train | 23,564 | 133.7 | 5450.7 | 40.77 | 162,122* | 58.6 | 71.6 | 1.22 |
| Val | 3,086 | 134.2 | 4607.8 | 34.34 | 58,648 | 56.6 | 63.7 | 1.13 |
| Test | 3,397 | 135.1 | 5440.8 | 40.27 | 59,965 | 59.5 | 76.4 | 1.28 |
文件结构
数据集包含两个文件夹:"chapter-" 和 "paragraph-",每个文件夹包含训练、验证和测试分割的单独 jsonline 文件。
下游应用:构建成对数据集以训练具体性评估器
使用 GPT-BookSum 数据集构建训练对 $(t_0, t_1)$ 来训练具体性评估器 M。训练对通过以下步骤构建:
- 从未用于训练的 GPT-BookSum 中采样摘要,并通过 Contriever 的顶部平均嵌入相似性进行配对。
- 以 50% 的概率截断较长的摘要,使其长度大致等于较短的摘要。否则,将两个摘要截断为相同的令牌长度,随机选择在 25 到 180 之间的对数刻度上。截断时尊重句子边界。
摘要生成的提示设计
摘要生成的提示设计遵循 Super-NaturalInstructions(Wang et al., 2022)的指导。示例提示如下: json {“role”: “user”, “content”: “Write a summary for the paragraph.
”} {“role”: “user”, “content”: “Paragraph: {Input Raw Text}”} {“role”: “assistant”, “content”: “Summary: In this paragraph, the main story is as follows.”}
引用
@article{wang2023improving, title={Improving Pacing in Long-Form Story Planning}, author={Wang, Yichen and Yang, Kevin and Liu, Xiaoming and Klein, Dan}, journal={arXiv preprint arXiv:2311.04459}, year={2023} }