finetranslations-segments
收藏资源简介:
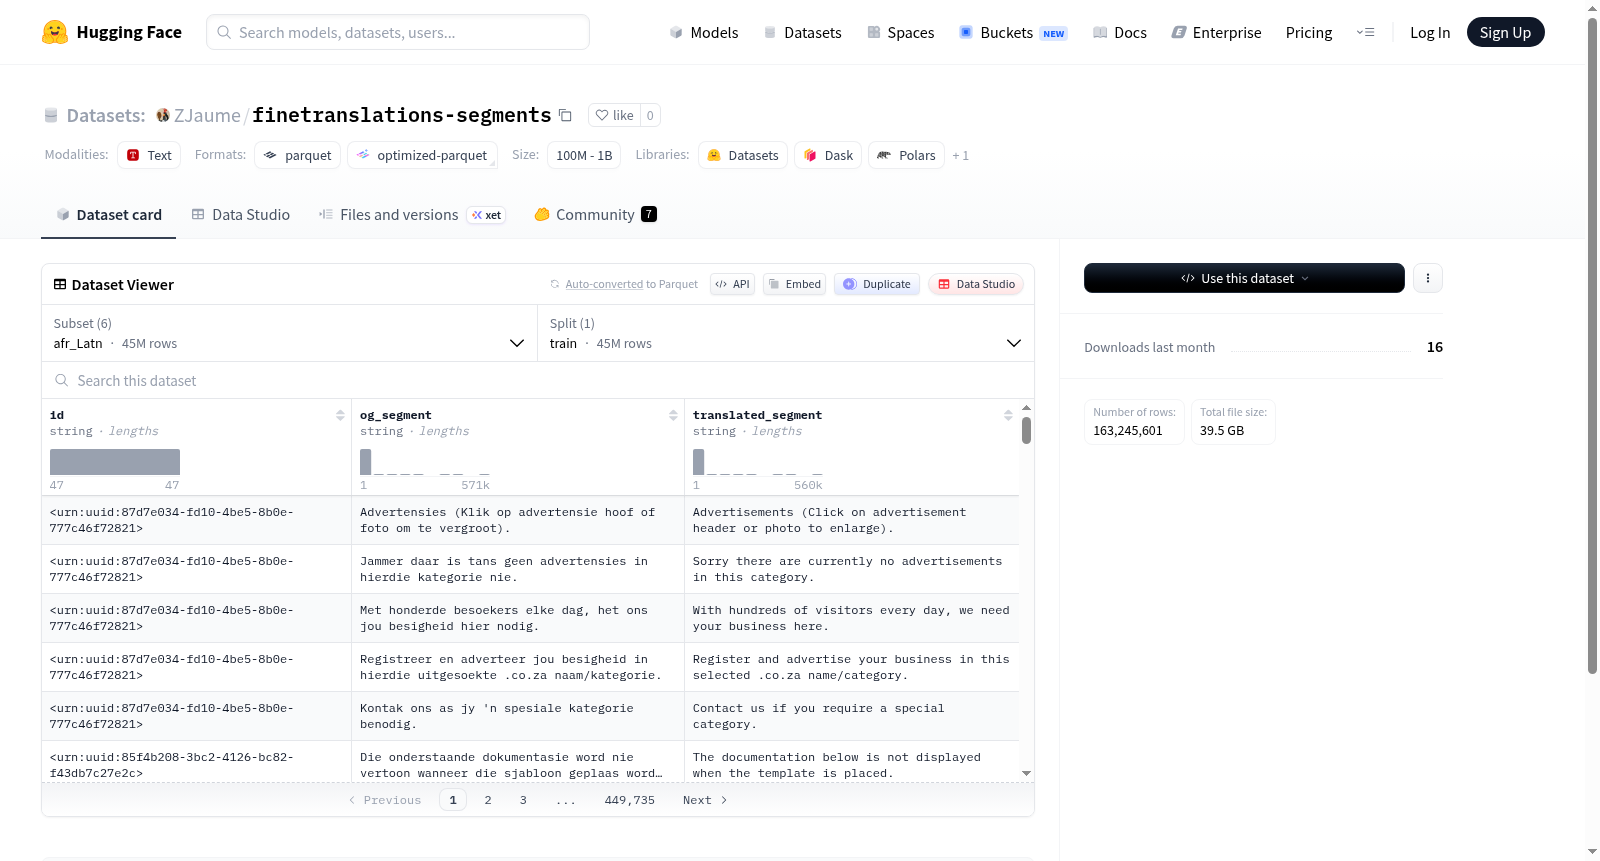
该数据集是一个多语言平行语料库,包含多个语言对的翻译数据,如南非荷兰语-拉丁字母、巴伐利亚语-拉丁字母、白俄罗斯语-西里尔字母、巴斯克语-拉丁字母、菲律宾语-拉丁字母和加利西亚语-拉丁字母等配置,每个配置均提供训练集拆分。每个样本包含三个字段:id(唯一标识符)、og_segment(原始语言片段)和translated_segment(翻译后的语言片段)。数据规模因语言而异,例如:南非荷兰语配置包含约4497万样本,巴伐利亚语配置包含约57万样本,白俄罗斯语配置包含约2999万样本,巴斯克语配置包含约1961万样本,菲律宾语配置包含约4044万样本,加利西亚语配置包含约2766万样本。数据集适用于机器翻译、多语言自然语言处理等任务。
This dataset is a multilingual parallel corpus containing translation data for multiple language pairs, such as Afrikaans-Latin, Bavarian-Latin, Belarusian-Cyrillic, Basque-Latin, Filipino-Latin, and Galician-Latin configurations, each with training set splits. Each sample includes three fields: id (unique identifier), og_segment (original language segment), and translated_segment (translated language segment). The data scale varies by language; for example, the Afrikaans configuration contains approximately 44.97 million samples, Bavarian about 570,000 samples, Belarusian about 29.99 million samples, Basque about 19.61 million samples, Filipino about 40.44 million samples, and Galician about 27.66 million samples. The dataset is suitable for tasks such as machine translation and multilingual natural language processing.
根据您提供的数据集详情页面信息,以下是对该数据集的概述:
数据集概述
数据集名称:finetranslations-segments
数据集地址:https://huggingface.co/datasets/ZJaume/finetranslations-segments
数据集配置
该数据集包含6个配置(config),每个配置对应一个不同的语言/文字变体:
| 配置名称 | 语言/文字 | 训练集样本数 | 训练集大小(字节) | 下载大小(字节) |
|---|---|---|---|---|
| afr_Latn | 南非荷兰语(拉丁字母) | 44,973,439 | 16,649,631,430 | 8,796,368,918 |
| bar_Latn | 巴伐利亚语(拉丁字母) | 572,410 | 142,670,153 | 74,746,414 |
| bel_Cyrl | 白俄罗斯语(西里尔字母) | 29,991,436 | 18,534,788,719 | 9,330,258,899 |
| eus_Latn | 巴斯克语(拉丁字母) | 19,611,891 | 9,281,499,001 | 5,049,764,592 |
| fil_Latn | 菲律宾语(拉丁字母) | 40,435,350 | 16,483,038,503 | 8,609,948,753 |
| glg_Latn | 加利西亚语(拉丁字母) | 27,661,075 | 13,945,657,568 | 7,682,512,532 |
数据特征
每个配置下的数据具有相同的特征结构:
- id:字符串类型,样本唯一标识符
- og_segment:字符串类型,原始文本片段
- translated_segment:字符串类型,翻译后的文本片段
数据拆分
每个配置仅包含一个训练集(train split),无其他拆分(如验证集或测试集)。