
NPCProgrammer/BERT_Emotions_tuned
收藏官方服务:
资源简介:
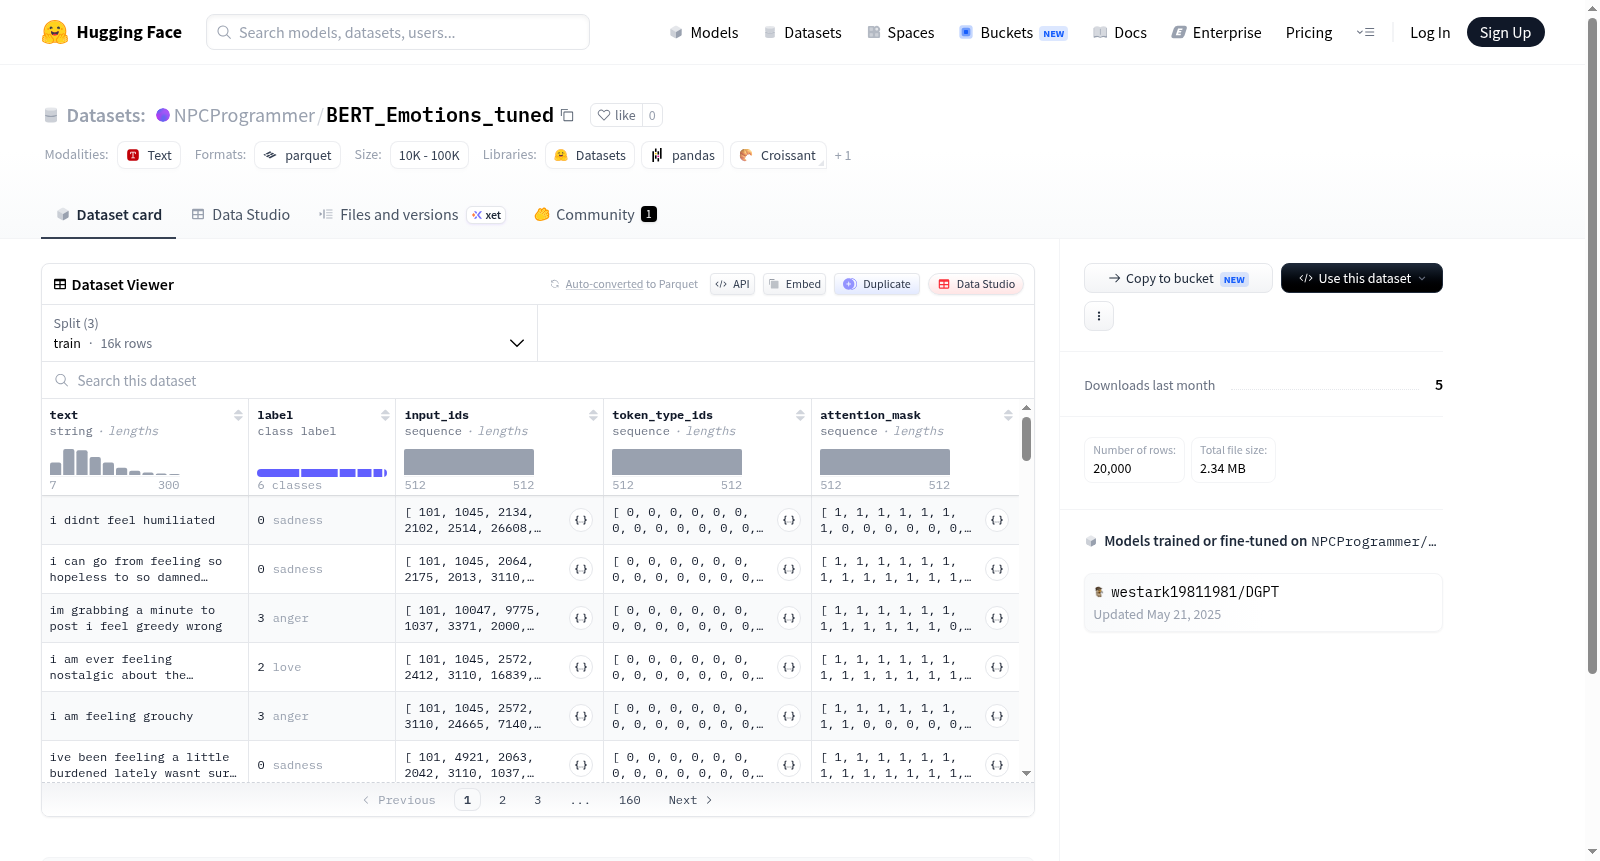
该数据集包含文本数据及其对应的情感标签。文本数据包括文本内容、输入ID、token类型ID和注意力掩码。情感标签分为六类:悲伤、喜悦、爱、愤怒、恐惧和惊讶。数据集分为训练集、验证集和测试集,分别包含16000、2000和2000个样本。
该数据集包含文本数据及其对应的情感标签。文本数据包括文本内容、输入ID、token类型ID和注意力掩码。情感标签分为六类:悲伤、喜悦、爱、愤怒、恐惧和惊讶。数据集分为训练集、验证集和测试集,分别包含16000、2000和2000个样本。
提供机构:
NPCProgrammer原始信息汇总
数据集概述
数据集特征
- text: 文本类型,数据类型为字符串。
- label: 标签类型,数据类型为分类标签,包含以下类别:
- 0: sadness
- 1: joy
- 2: love
- 3: anger
- 4: fear
- 5: surprise
- input_ids: 序列类型,数据类型为32位整数。
- token_type_ids: 序列类型,数据类型为8位整数。
- attention_mask: 序列类型,数据类型为8位整数。
数据集分割
- train: 训练集,包含16000个样本,占用51085533字节。
- validation: 验证集,包含2000个样本,占用6382695字节。
- test: 测试集,包含2000个样本,占用6385173字节。
数据集大小
- 下载大小: 2333818字节
- 数据集总大小: 63853401字节
配置文件
- config_name: default
- data_files:
- split: train, path: data/train-*
- split: validation, path: data/validation-*
- split: test, path: data/test-*
搜集汇总
数据集介绍
构建方式
在自然语言处理与情感分析的交汇领域,精准识别文本中的情感倾向是构建智能交互系统的核心挑战。该数据集基于BERT预训练模型进行微调构建,其构建过程遵循标准化流程:首先收集涵盖六类基本情感(悲伤、喜悦、爱、愤怒、恐惧、惊讶)的文本语料,通过人工标注形成原始标签体系。随后利用BERT分词器对原始文本进行向量化处理,生成input_ids、token_type_ids与attention_mask三类结构化特征,从而将非结构化文本转化为模型可理解的数值表示。数据集按16000:2000:2000的比例划分为训练、验证与测试三部分,确保模型训练与评估的可靠性。
特点
该数据集呈现出多维度的结构优势与情感分析专属性。在特征设计上,它不仅保留了原始文本与情感标签的映射关系,更通过预计算方式直接提供BERT模型所需的输入标识符、类型标识符与注意力掩码,大幅降低了使用者的预处理门槛。情感类别涵盖从积极到消极的六种基础情感状态,既有喜悦、爱等正向情绪,也有愤怒、恐惧等负向情绪,还包括惊喜这一中性情感,形成了较为完整的情感光谱。数据规模虽非海量,但训练集16000条、验证集与测试集各2000条的配置,足以支撑情感分类任务的模型微调与性能评估。
使用方法
使用者可通过HuggingFace的datasets库便捷加载该数据集,直接调用默认配置即可获取划分好的训练、验证与测试子集。由于数据已预先完成BERT词的向量化处理,用户无需重复执行分词与编码步骤,可直接将input_ids、attention_mask等特征输入到BERT分类模型中进行训练或推理。对于需要自定义训练流程的研究者,数据集提供了清晰的文本与标签字段,支持基于原始文本的二次特征工程。推荐在情感分析、对话系统或社交媒体舆情监控等场景中应用,利用预计算特征快速搭建情感分类管线。
背景与挑战
背景概述
情感分析作为自然语言处理领域的核心任务,致力于从文本中识别和提取人类情感状态。BERT_Emotions_tuned数据集由NPCProgrammer团队创建,旨在推动基于BERT预训练模型的情感分类研究。该数据集包含六大情感类别——悲伤、快乐、爱、愤怒、恐惧与惊讶,共计20000条文本样本,划分为训练、验证和测试三个子集,为微调预训练语言模型提供了标准化基准。其核心研究问题聚焦于如何利用深度双向Transformer架构捕捉文本中的细微情感差异,从而提升情感识别精度。自发布以来,该数据集在情感计算、社交媒体分析和人机交互等领域产生了广泛影响,成为评估情感分类模型性能的重要资源。
当前挑战
当前数据集面临的核心挑战包括多维度情感模糊性与构建复杂性。在领域问题层面,文本中常出现混合情感或隐含情感,如讽刺与幽默中的情绪表达,使得六分类模型难以准确捕捉细微差别;此外,跨文化语境下情感标签的主观性进一步加剧了分类歧义。在构建过程中,数据标注的一致性难以保障,不同标注者对同一文本的情感判断可能产生分歧,导致标签噪声;同时,数据集规模相对有限(16000训练样本),难以覆盖现实世界中丰富的情感表达模式,可能引发模型泛化能力不足与类别不平衡问题,制约了情感分析系统的鲁棒性提升。
常用场景
经典使用场景
在自然语言处理与情感计算交叉领域中,BERT_Emotions_tuned数据集是微调预训练语言模型以进行细粒度文本情感分类的经典基准。其核心应用场景在于训练模型识别文本中蕴含的六类基础情感——悲伤、喜悦、爱、愤怒、恐惧与惊讶。研究者通常利用该数据集对BERT架构进行领域适配,通过监督学习使模型掌握情感语义的深层表征,从而在社交媒体评论、产品用户反馈或对话系统等短文本场景中实现高精度情感判别。
实际应用
在实际产业应用中,该数据集微调后的模型被广泛应用于智能客服系统的情绪感知模块,以实时识别用户愤怒或焦虑信号并触发安抚策略;同时服务于社交媒体舆情监控平台,通过识别恐惧或喜悦情绪来预警社会热点事件。此外,在教育领域,它助力在线学习系统捕捉学生的情感状态,例如通过文本分析判断学习者的困惑或满足感,从而动态调整教学策略,提升个性化学习体验。
衍生相关工作
基于BERT_Emotions_tuned数据集,衍生出一系列具有影响力的学术工作。例如,研究者提出情感增强的对比学习框架,利用该数据集生成情感感知的正负样本对,提升模型对细微情感差异的区分能力;另有工作探索了情感标签间的层次关系,构建情感知识图谱辅助模型推理。此外,该数据集还被用于评估跨语言情感迁移效果,催生了多语言情感BERT模型的改进版本,以及结合图神经网络进行情感上下文建模的创新方法。
以上内容由遇见数据集搜集并总结生成


